Gemini 3.5 Flash 推出内置计算机使用工具
评分
71精选理由
创新性强,直接拓展了AI的应用边界,且集成度与易用性高,但尚需验证在复杂环境下的鲁棒性。
AI 点评
「该功能首次将大模型的视觉理解与物理操作能力直接结合,大幅降低了开发智能体应用的门槛。」
速览
Google DeepMind 在 Gemini 3.5 Flash 中集成了计算机使用工具,允许模型直接理解屏幕截图、模拟鼠标键盘操作,实现智能体自动化。该工具无需额外配置,可执行网页导航、数据输入、界面测试等任务,标志着大模型从“对话”向“行动”的关键跨越。
- Gemini 3.5 Flash 新增内置计算机使用功能,无需外部依赖。
- 模型可解析用户界面截图,并生成精准的鼠标/键盘操作指令。
- 支持自动化完成多步骤任务,如填写表单、跨页面信息提取。
- 该功能适用于 RPA、测试、辅助办公等场景。
正文
在Gemini 3.5 Flash中引入计算机使用
2026年6月24日
· Share x.com Facebook LinkedIn Mail Copy link计算机使用现在成为Gemini 3.5 Flash的内置工具,用于构建可在跨平台交互的智能体。
Mateo Quiros Product Manager, Google DeepMind Share x.com Facebook LinkedIn Mail Copy link
您的浏览器不支持音频元素。
Listen to article This content is generated by Google AI. Generative AI is experimental [[duration]] minutes Voice Speed Voice Speed 0.75X 1X 1.5X 2X计算机使用现在是Gemini 3.5 Flash支持的内置工具,为代理型计算机使用任务提供了我们迄今为止最佳的性能。此前仅作为独立的Gemini 2.5计算机使用模型提供,现在计算机使用已原生集成到主要的Gemini Flash模型中。Gemini已经在函数调用和使用内置工具(如Search和Maps grounding)方面表现出色。借助内置的计算机使用能力,开发者现在可以使用3.5 Flash可靠地构建能够跨浏览器、移动和桌面环境观察、推理并采取行动的自定义智能体。这为长期和企业自动化任务(如跨专业应用的持续软件测试和知识工作)解锁了改进的性能。
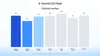
开发者和企业可以通过Gemini API和Gemini企业智能体平台开始在3.5 Flash中使用计算机使用。
3.5 Flash使用计算机使用来分析Gemini应用并返回分类的功能列表。
具备计算机使用功能的3.5 Flash会审计自己的文档以解决可访问性问题。
确保3.5 Flash中计算机使用的安全性
为了降低在真实环境中运行的智能体面临的一些提示注入风险,我们针对Gemini 3.5 Flash中的计算机使用进行了定向对抗训练。我们还发布了两项可选的企业保护系统,使企业能够:
- 要求对敏感或不可逆操作进行明确的用户确认。
- 如果识别到间接提示注入,自动停止任务。
我们采用“纵深防御”方法,鼓励开发者将这些功能与安全沙箱、人工在环验证和严格的访问控制相结合。有关安全措施的更多信息,请参阅我们的最佳实践文档。
我们已经看到客户通过计算机使用获得价值。以下是他们的一些反馈:

立即开始使用计算机使用进行构建:
- 立即尝试:在由Browserbase托管的演示环境中测试这些能力。
- 开始构建:通过Gemini API和Gemini企业智能体平台深入了解我们的参考实现和文档。


在您的收件箱中获取来自Google的更多故事。 在您的收件箱中获取来自Google的更多故事。
Email address您的信息将按照 Google隐私政策使用。
Subscribe完成。只需再一步。
检查您的收件箱以确认订阅。
您已经订阅了我们的通讯。
您也可以使用其他电子邮件地址 订阅。
POSTED IN:相关条目
精选DeepSeek V4 在 OpenRouter 上的代币份额翻倍,智能体工作负载成主要驱动力
DeepSeek V4 的快速采用表明市场对高性能、低成本推理模型的强烈偏好,尤其是智能体场景将重塑 AI 部署格局。
91
精选启用两项设置使ARC-AGI-3基准测试分数提升三倍
这项发现太关键了!它表明模型的性能不仅取决于训练,还取决于推理时的配置。对于AI工程师和研究者来说,这是一个必须注意的优化方向。特别是那些在资源受限设备上部署模型的团队,可能会因此找到低成本提升能力的方法。
91
精选GPT-5.6:前沿智能与前沿效率的融合
这条消息值得关注,因为它标志着大模型竞争从单纯拼参数转向拼效率。对于AI开发者和企业决策者来说,GPT-5.6意味着可以用更少预算获得更高性能,尤其适合那些被推理成本挡在门外的长上下文或Agent场景。OpenAI这一步,可能重新定义‘前沿’的标准。
91
精选LFM2.5-Encoder:面向CPU快速长上下文推理的新模型
这篇博文让我眼前一亮,因为它直接解决了大模型在CPU上跑长上下文的痛点。对于没有高端GPU的团队或个人开发者,LFM2.5-Encoder系列提供了可立即使用的开源方案。尤其推荐给做RAG、文档搜索或代码分析的朋友——现在用普通服务器就能处理百万级token的文档了。
91
精选GPT-Red:OpenAI通过自我对弈实现AI红队自动化,提升模型鲁棒性
GPT-Red 是红队测试从人工到自动化的里程碑,特别适合安全工程师和对齐研究者关注。它直接降低了测试成本,但也引发了对“自动攻击”本身的伦理讨论——值得所有关注AI治理的人深入思考。
91
精选OpenAI推出GPT-5.5生物漏洞赏金计划
这个计划值得关注,因为它首次将AI漏洞赏金制度拓展到生物安全领域,不仅为安全社区提供了新的研究方向,也为AI风险治理提供了实际演练场。对模型安全研究者、生物安全专家以及关心AI双重用途的从业者尤其重要。
91
精选vLLM推出原生速度Transformers建模后端,大幅提升推理性能
这项更新对于AI工程团队非常关键:无需格式转换意味着能更快地迭代模型,而2-5倍的速度提升直接降低GPU成本。如果你正在做LLM在线服务或者批量推理,这几乎是必读的技术更新。
90
精选Google DeepMind 发布手语转文本模型 SL2T,助力聋人用户
这则消息的意义不仅在于技术突破,更在于AI开始真正关注边缘群体的需求。对开发者而言,SL2T的架构思路和技术路径值得深入研究;对无障碍倡导者来说,这是推动行业标准的重要案例。