DeepSeek V4 在 OpenRouter 上的代币份额翻倍,智能体工作负载成主要驱动力
评分
92精选理由
该模型份额翻倍且由新兴智能体负载驱动,具有显著行业影响力,但数据局限于单一平台,扣分反映信息源局限性。
AI 点评
「DeepSeek V4 的快速采用表明市场对高性能、低成本推理模型的强烈偏好,尤其是智能体场景将重塑 AI 部署格局。」
速览
DeepSeek 模型在 OpenRouter 平台上的代币份额在六个月内翻了一番,其中 V4 Flash 版本贡献最大。智能体(Agentic)工作负载成为此次增长的主要驱动力,反映出市场对高效、低成本推理模型的旺盛需求。
- DeepSeek 在 OpenRouter 上的代币份额六个月翻倍。
- V4 Flash 模型是增长的关键,尤其适合智能体场景。
- 智能体工作负载(如自主循环、多步骤推理)推动采用。
正文
DeepSeek V4 正在获取代理代币份额
OpenRouter ·2026年6月30日
 On this page
- 当前推动代币使用的模型作者
- V4 是首个足以胜任代理工作负载的 DeepSeek 模型
- DeepSeek 与中国模型的崛起
- 方法论说明
DeepSeek——这家公司对许多人而言仍等同于开源大语言模型——于4月24日发布了其新的旗舰模型 V4。
V4 重新设定了发展轨迹。六个月内,DeepSeek 在 OpenRouter 上的代币份额大约翻了一番,而代理工作负载贡献了大部分增长。
当前推动代币使用的模型作者
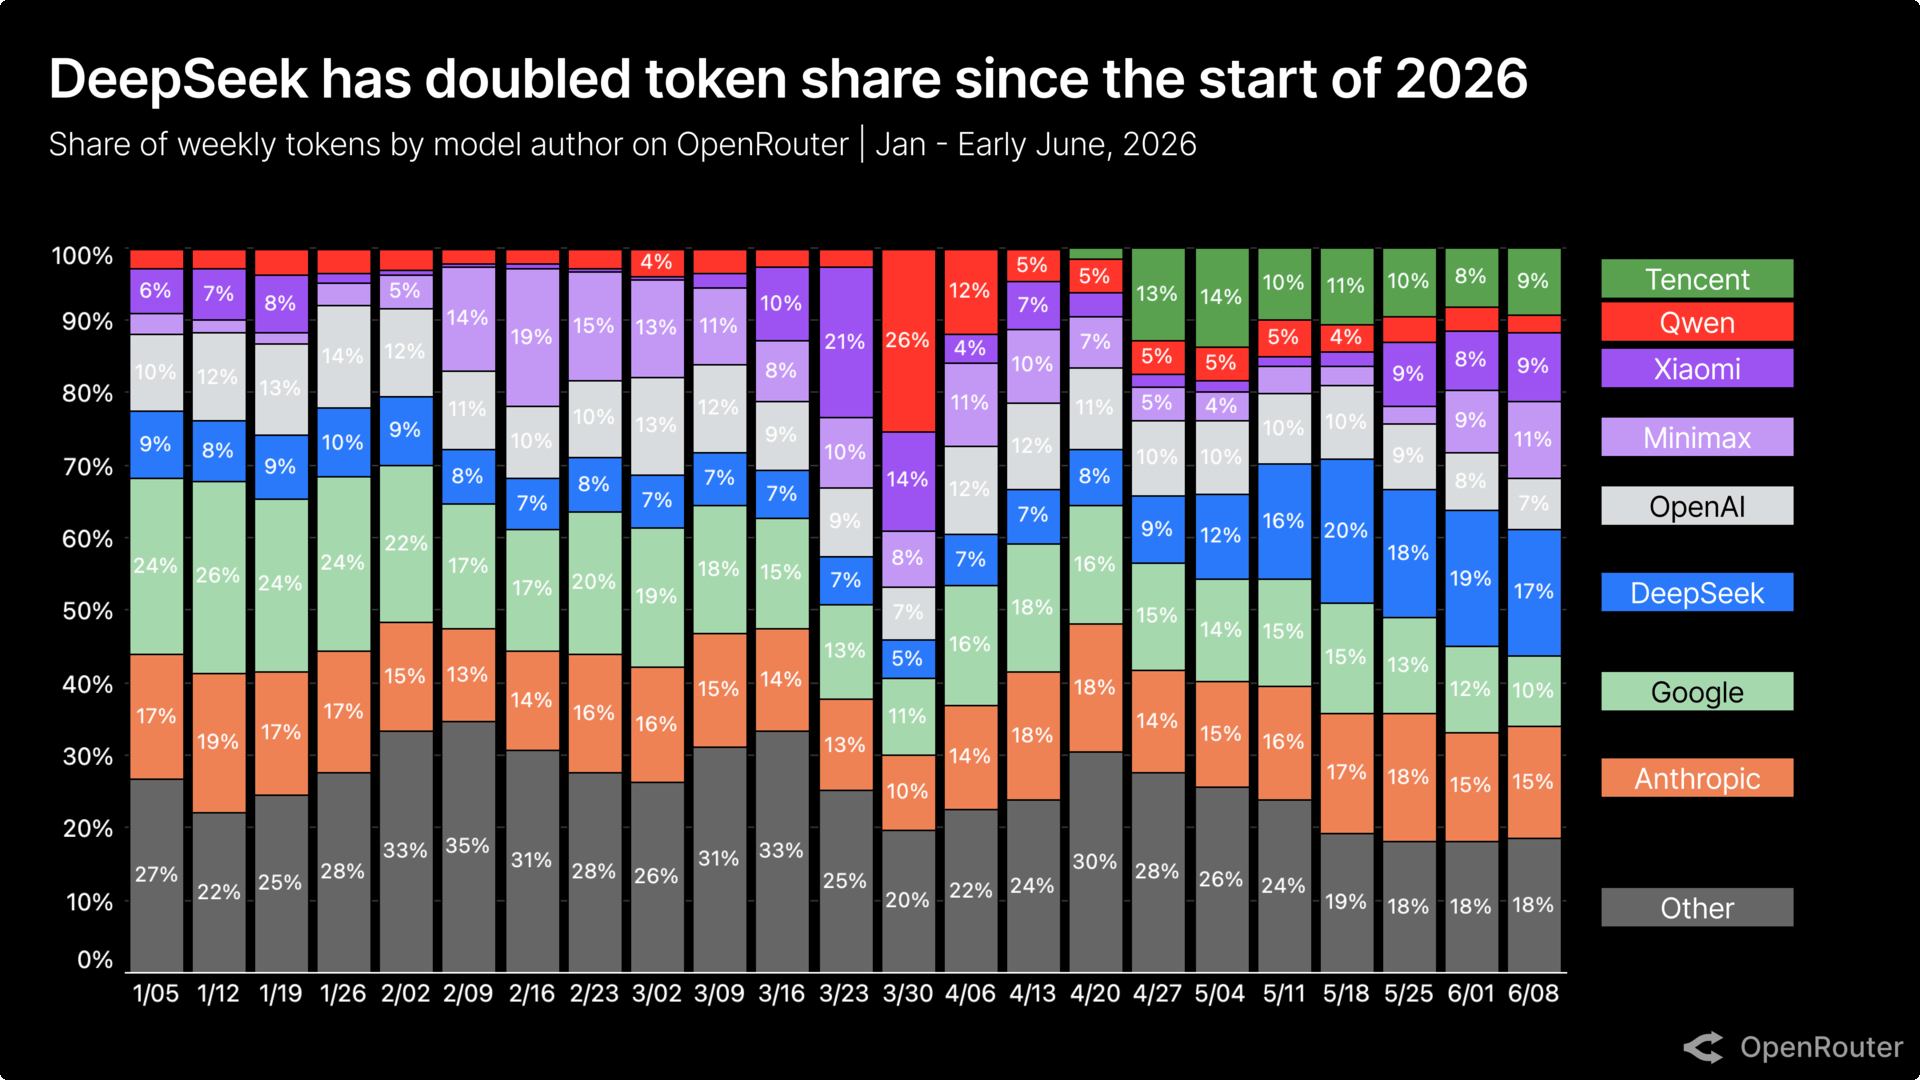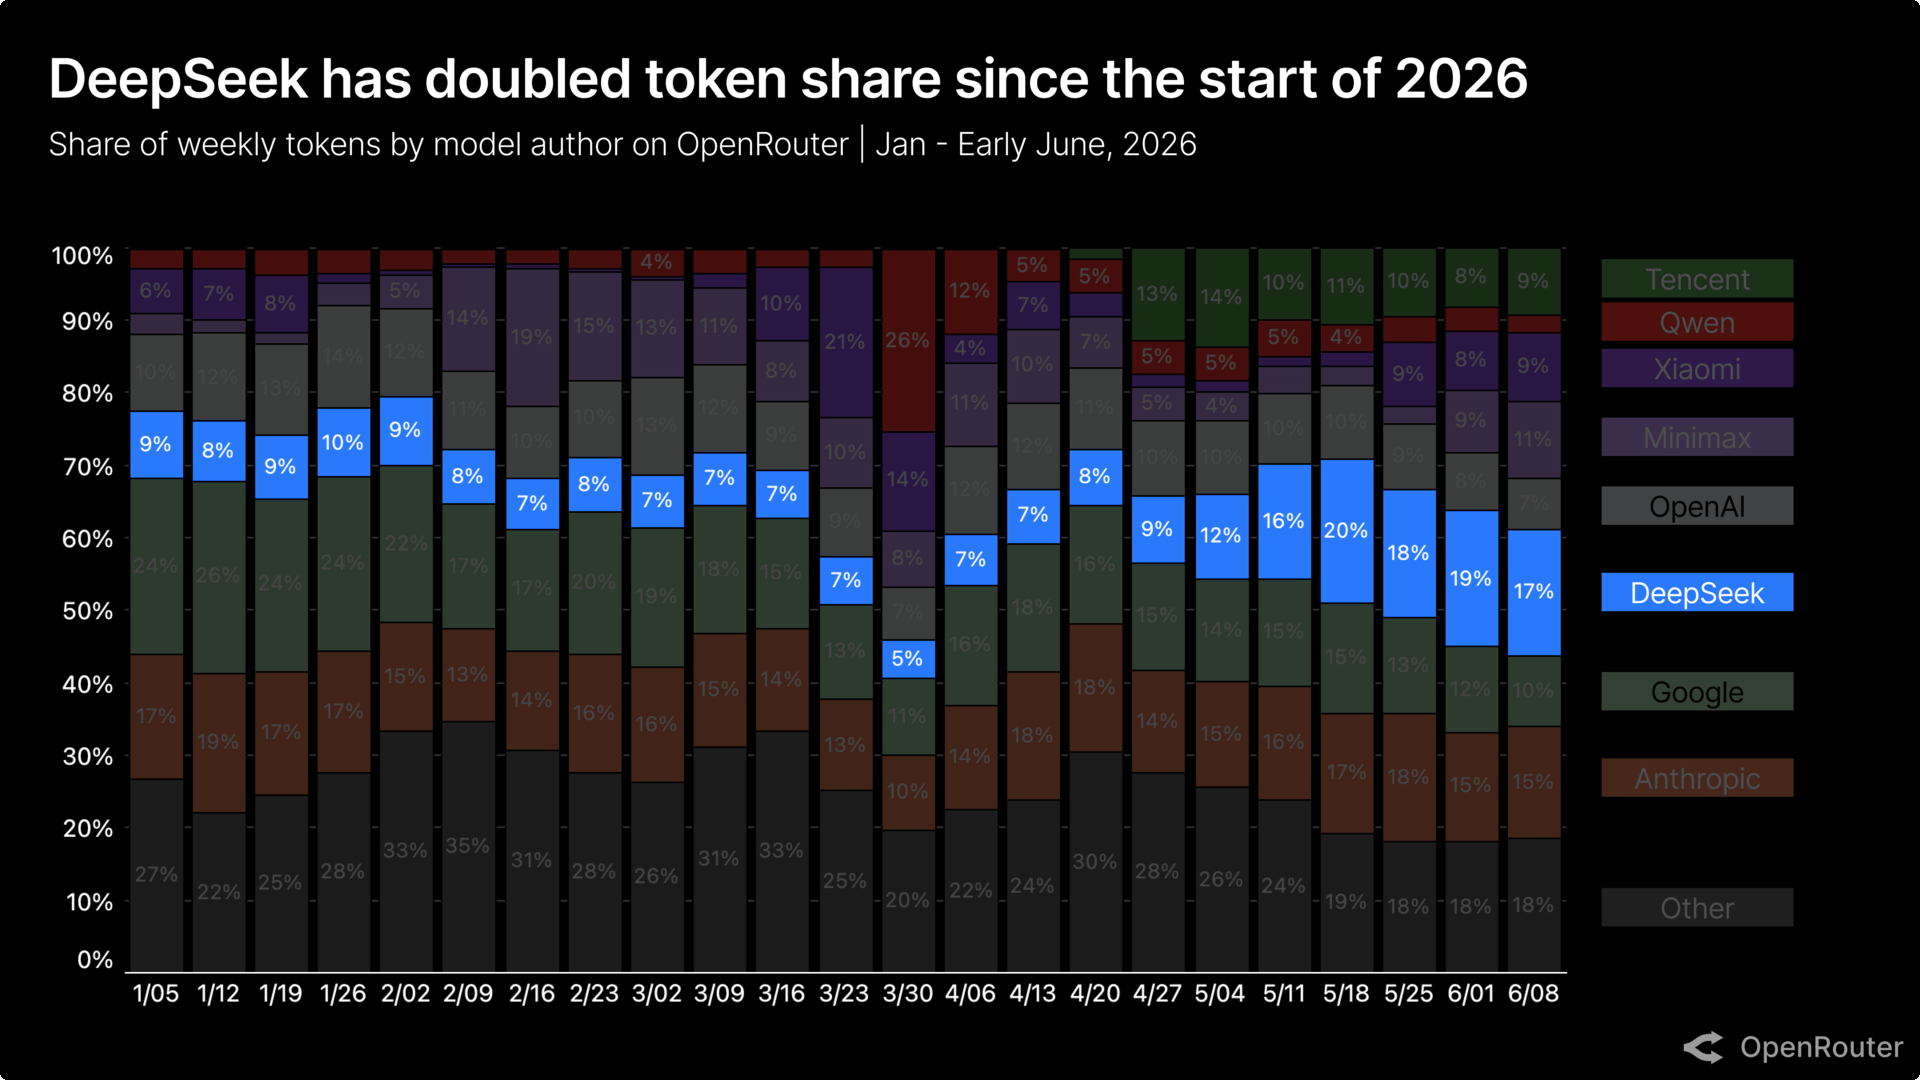
年初,DeepSeek 在 OpenRouter 上每周代币流量占比略低于10%。随着代理工作在2月和3月开始兴起,代币使用量以前所未有的速度增长,DeepSeek 的份额实际上降至总代币的5%。该公司受到来自上方的专有模型和来自下方其他开源大语言模型浪潮的双重挤压。
V4 模型系列的发布立即产生了积极影响。到6月初,DeepSeek 已获得近20%的代币份额,并且自5月中旬以来一直是 OpenRouter 上的顶级模型。
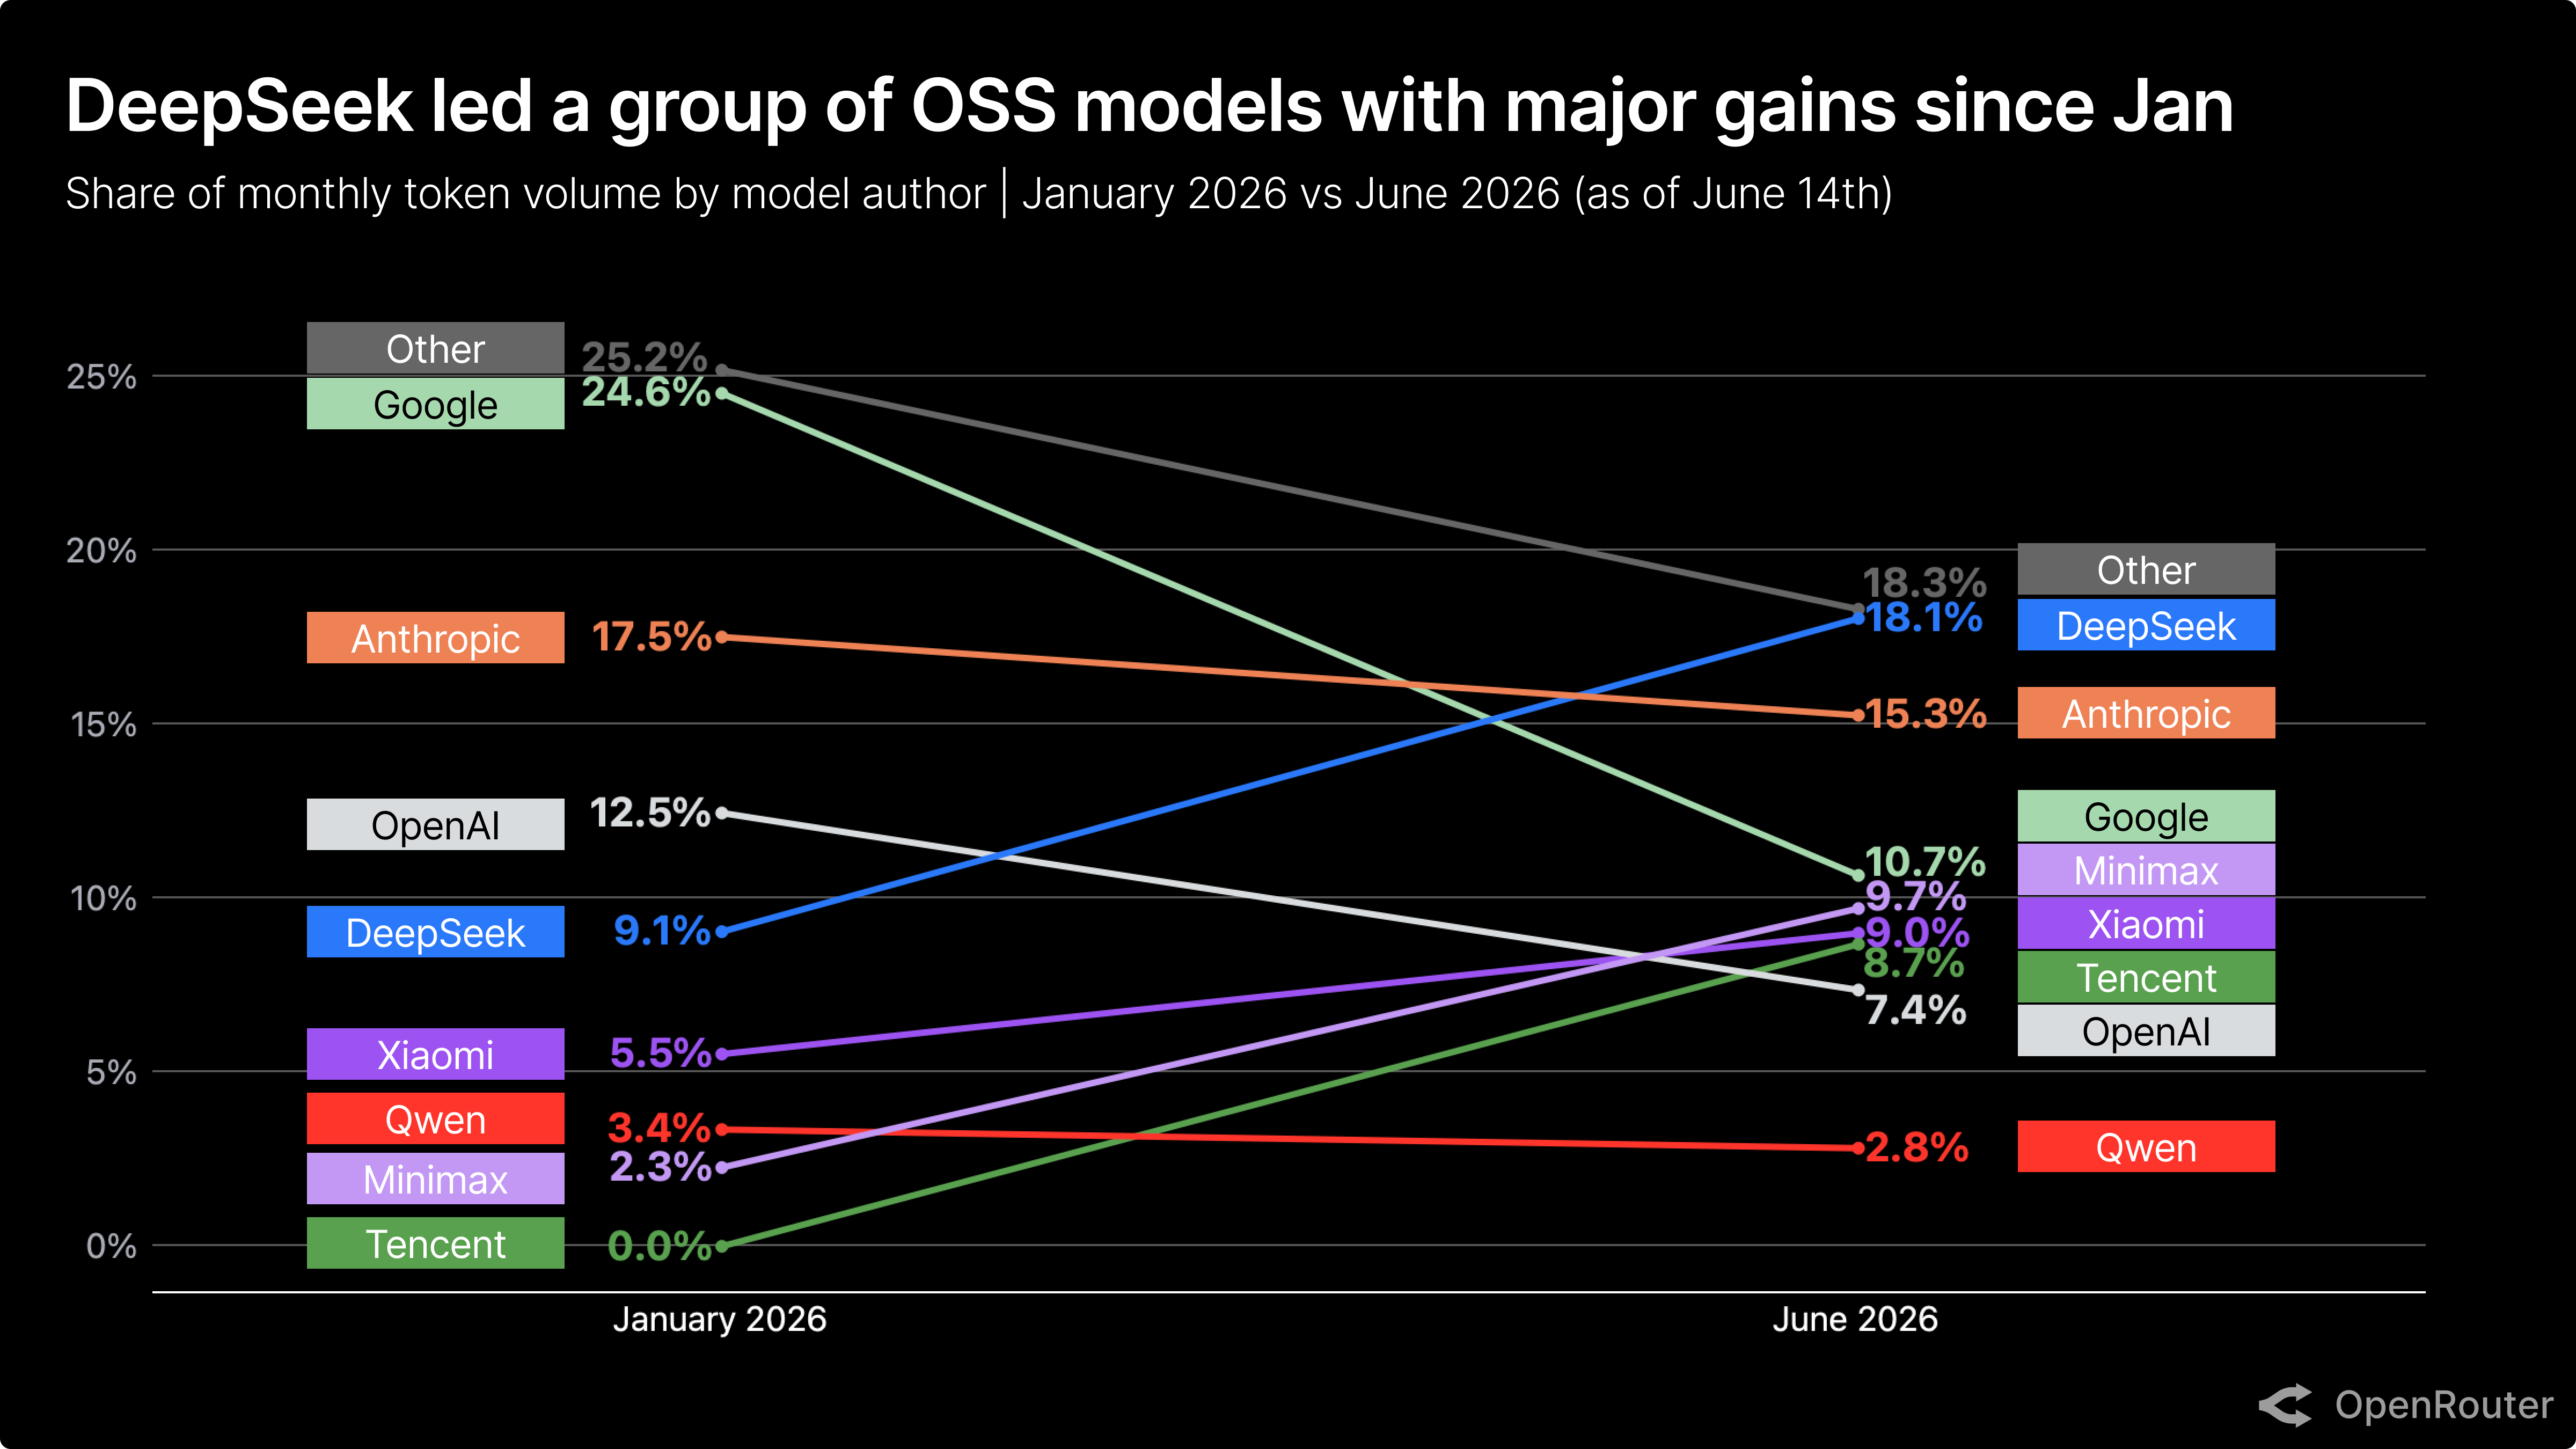
直接比较2026年1月和6月,可以看出模型作者之间的偏好变化之快。DeepSeek 在此期间代币份额有效翻了一番(从9%增至18%),但许多其他模型提供商的命运也经历了重大波动。
一组中国开源模型,包括小米、Minimax 和腾讯,在过去6个月中代币份额均有所上升。这似乎是以牺牲几家领先的美国模型公司为代价的,特别是 Google 和 OpenAI。
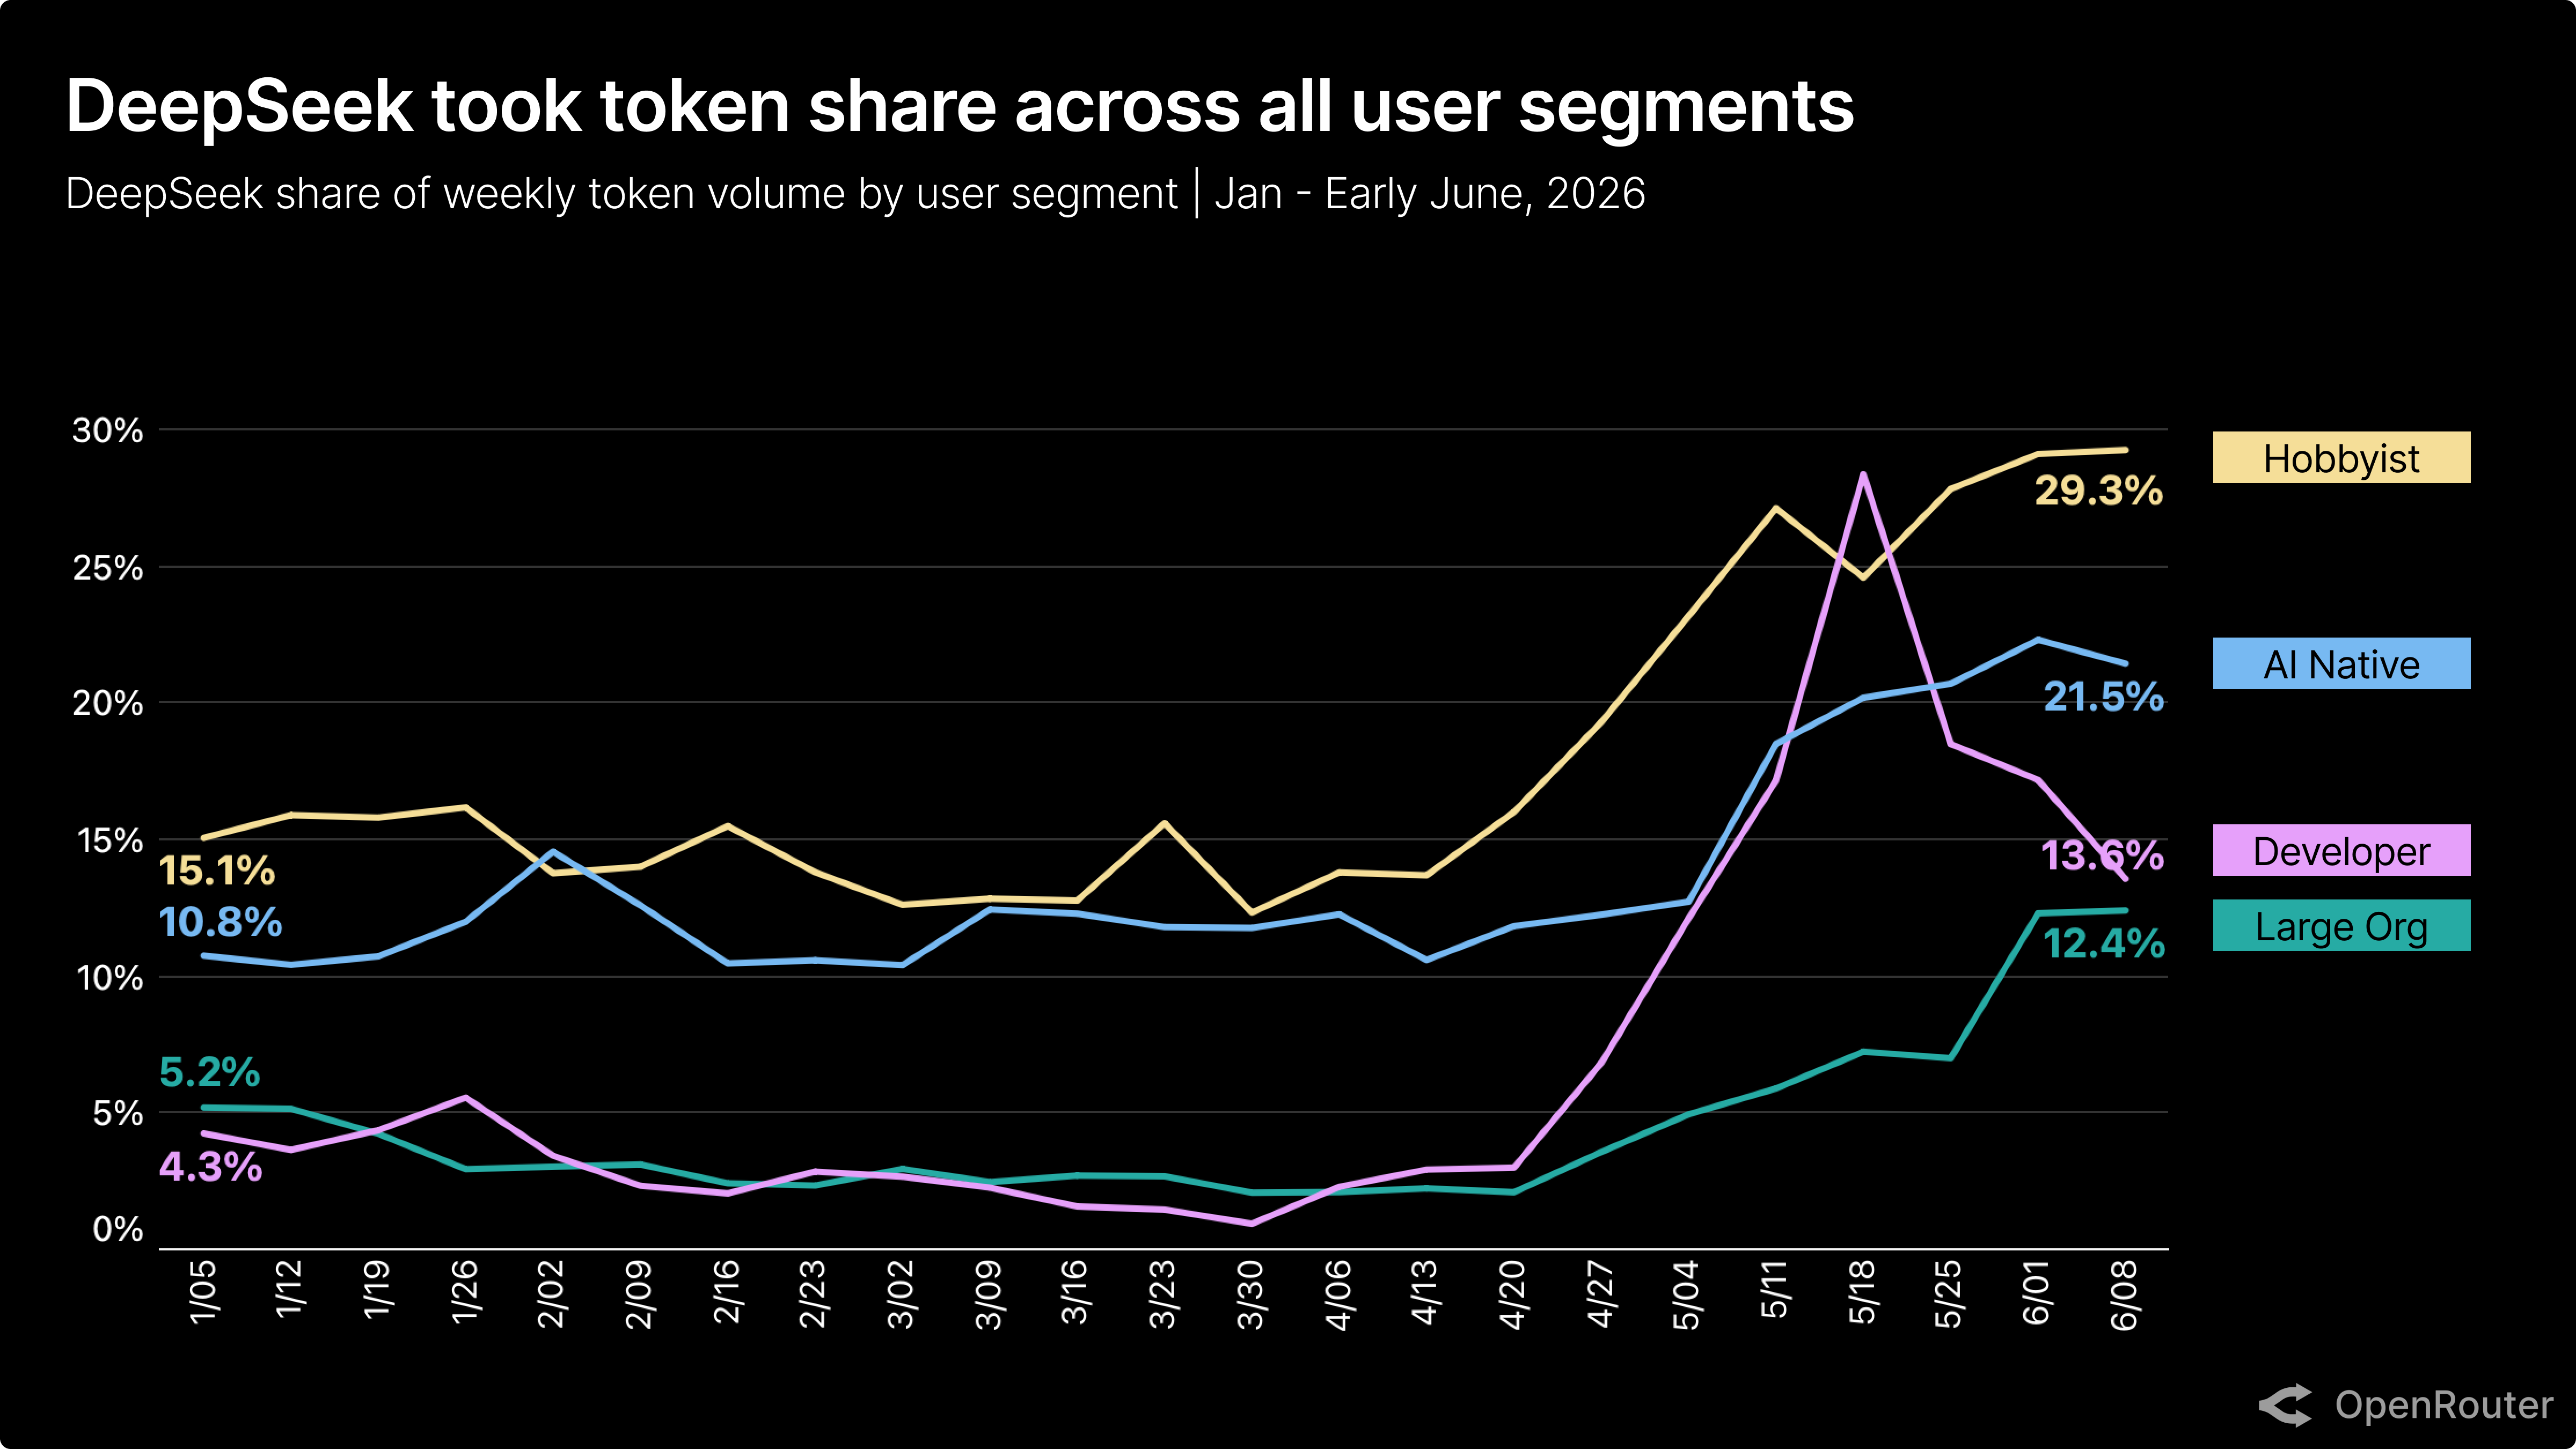
DeepSeek 的翻倍并非局限于单一用户类型。到6月初,各种类型的公司和个人都在使用越来越多的 DeepSeek 代币。业余爱好者用户(通常通过面向消费者的应用类别大量使用,如角色扮演、通用聊天、个人代理等)现在将近三分之一的代币路由到 DeepSeek 模型。
即使在 AI 原生公司或大型组织的用户中,尽管他们可能被预期优先考虑前沿闭源模型,但在6月初,他们向 DeepSeek 发送的代币流量也比年初多得多。
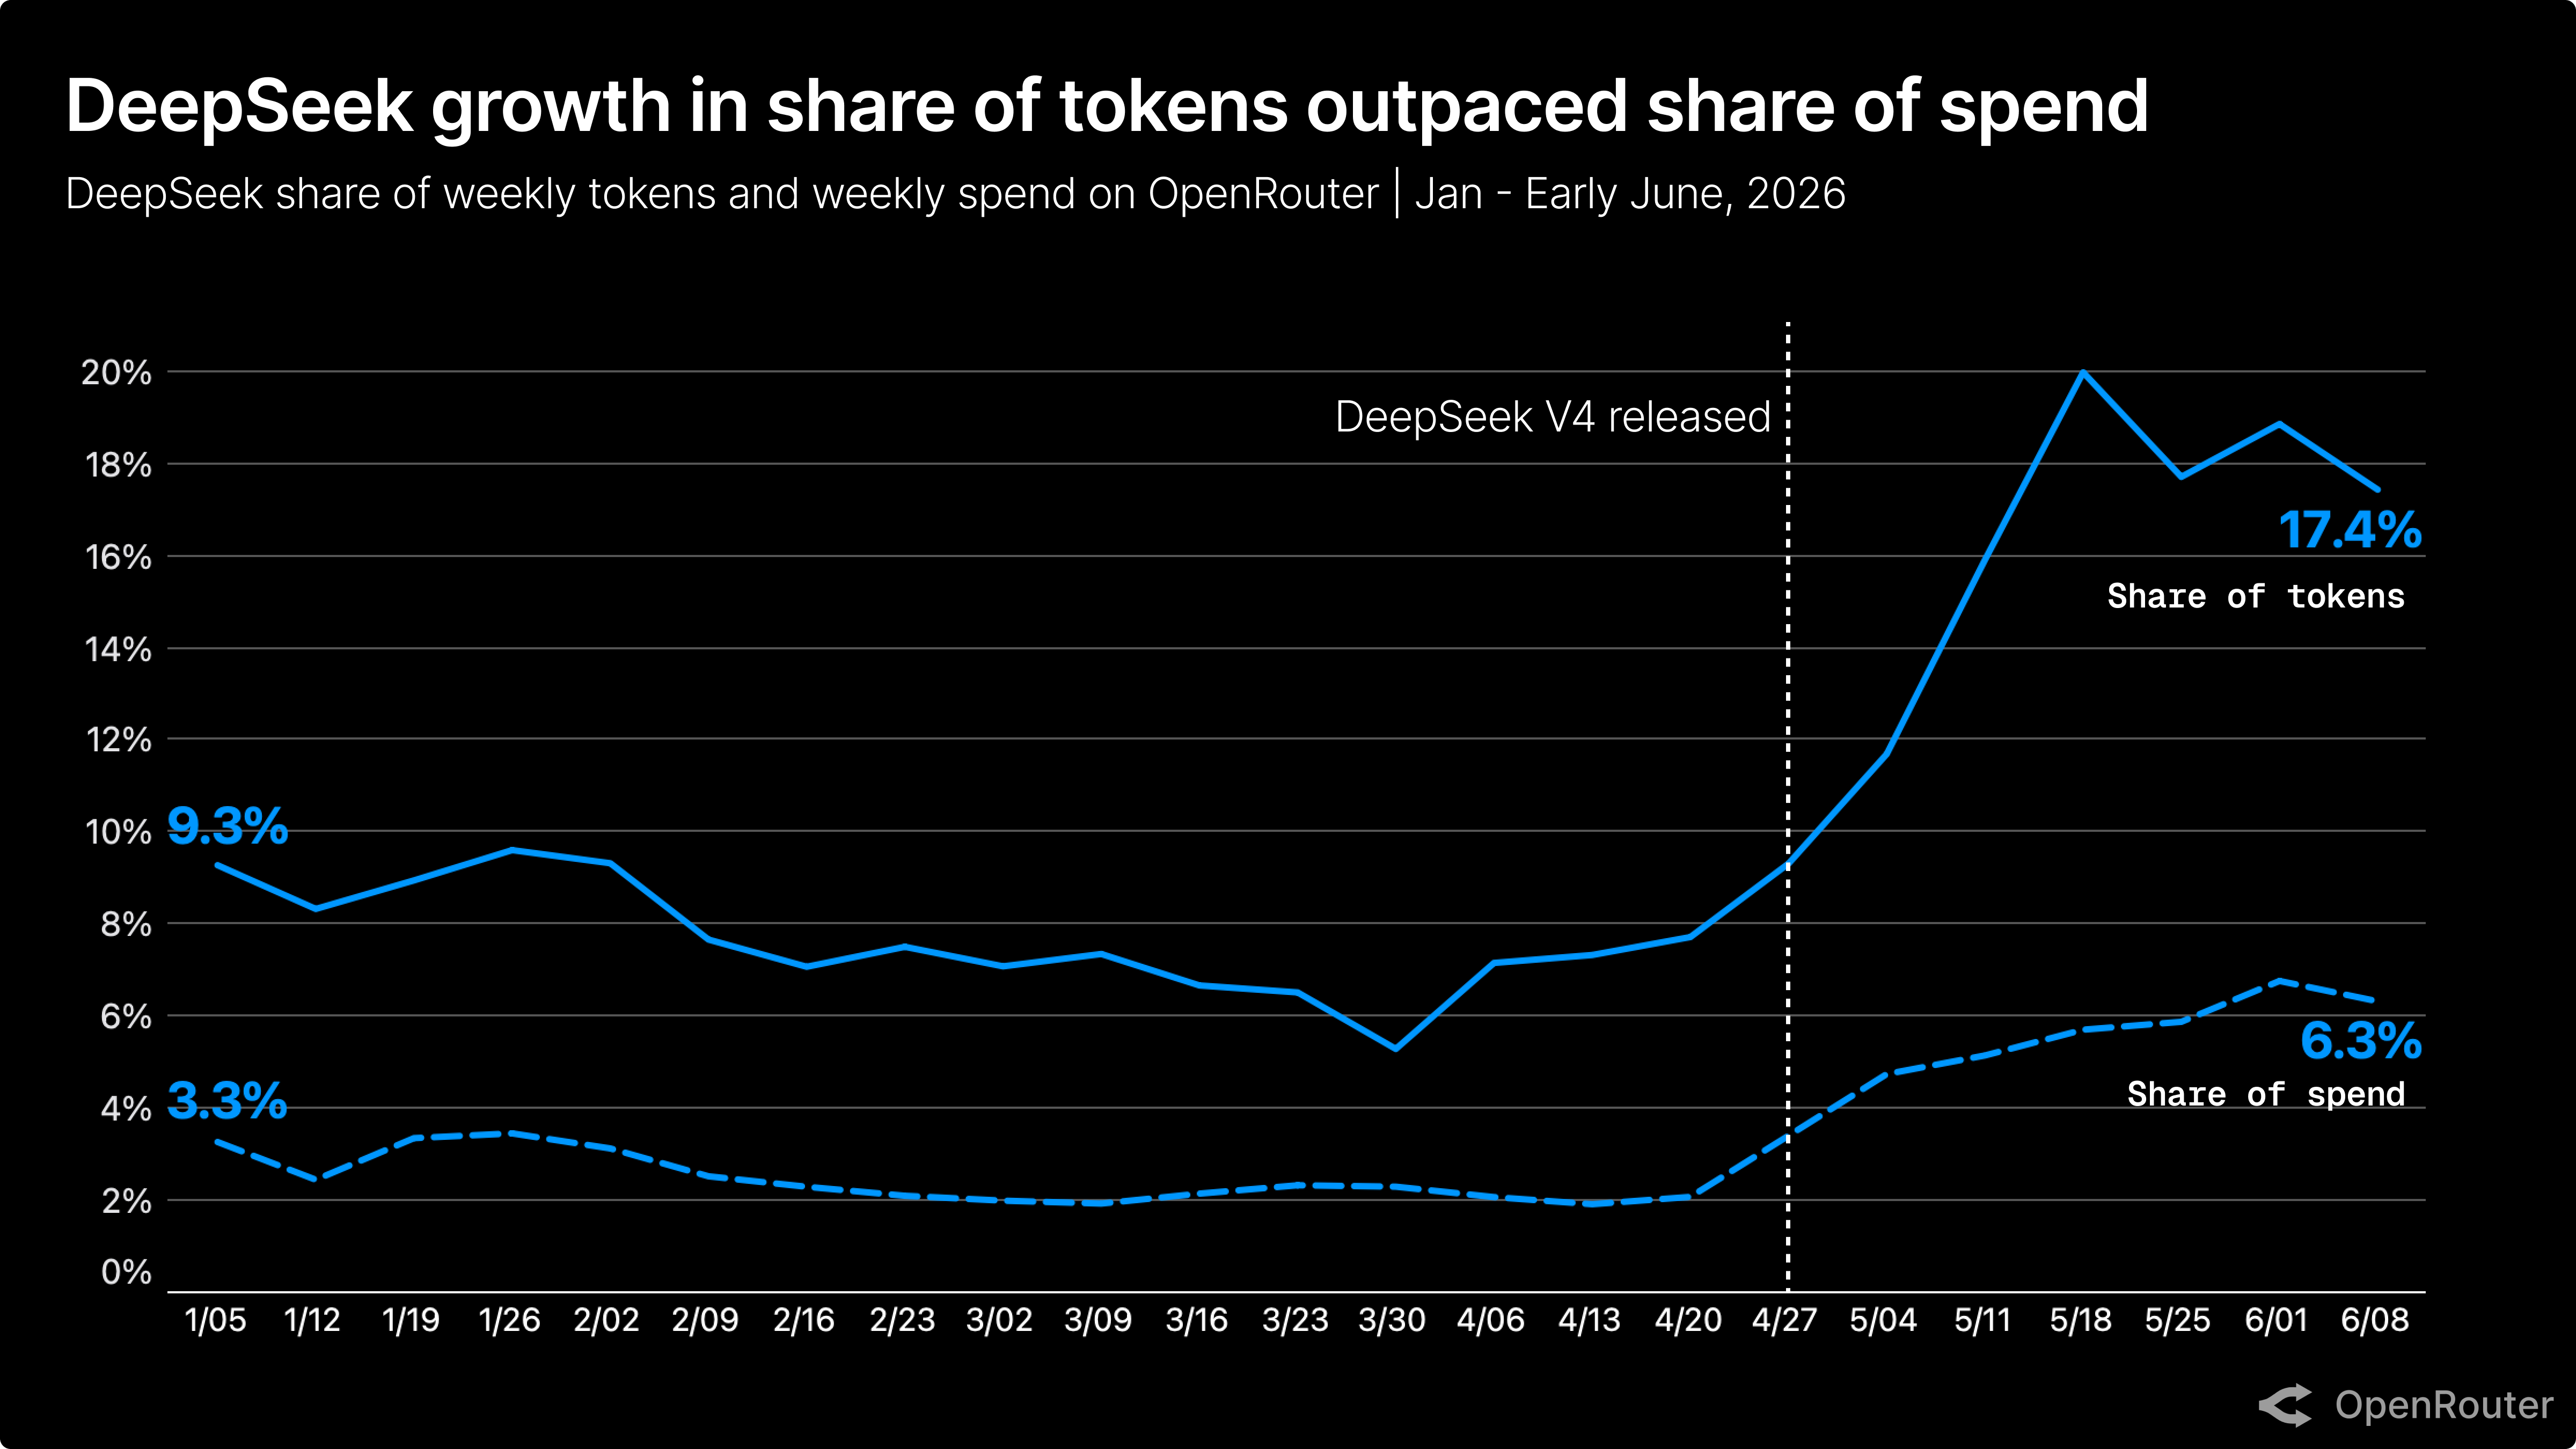
DeepSeek V4 Flash 在最便宜的端点上,每百万代币输入成本0.09美元,输出成本0.18美元。作为对比,GPT-5.5 目前每百万代币定价为输入5美元,输出30美元。
因此,看到 V4 代币量突然激增并未导致支出份额同步飙升并不令人意外。V4 的成本效益与输出质量比是同类最佳——事实上,它足够好,以至于各种规模的组织都开始信任 DeepSeek 用于实际的代理工作。
V4 是首个足以胜任代理工作负载的 DeepSeek 模型
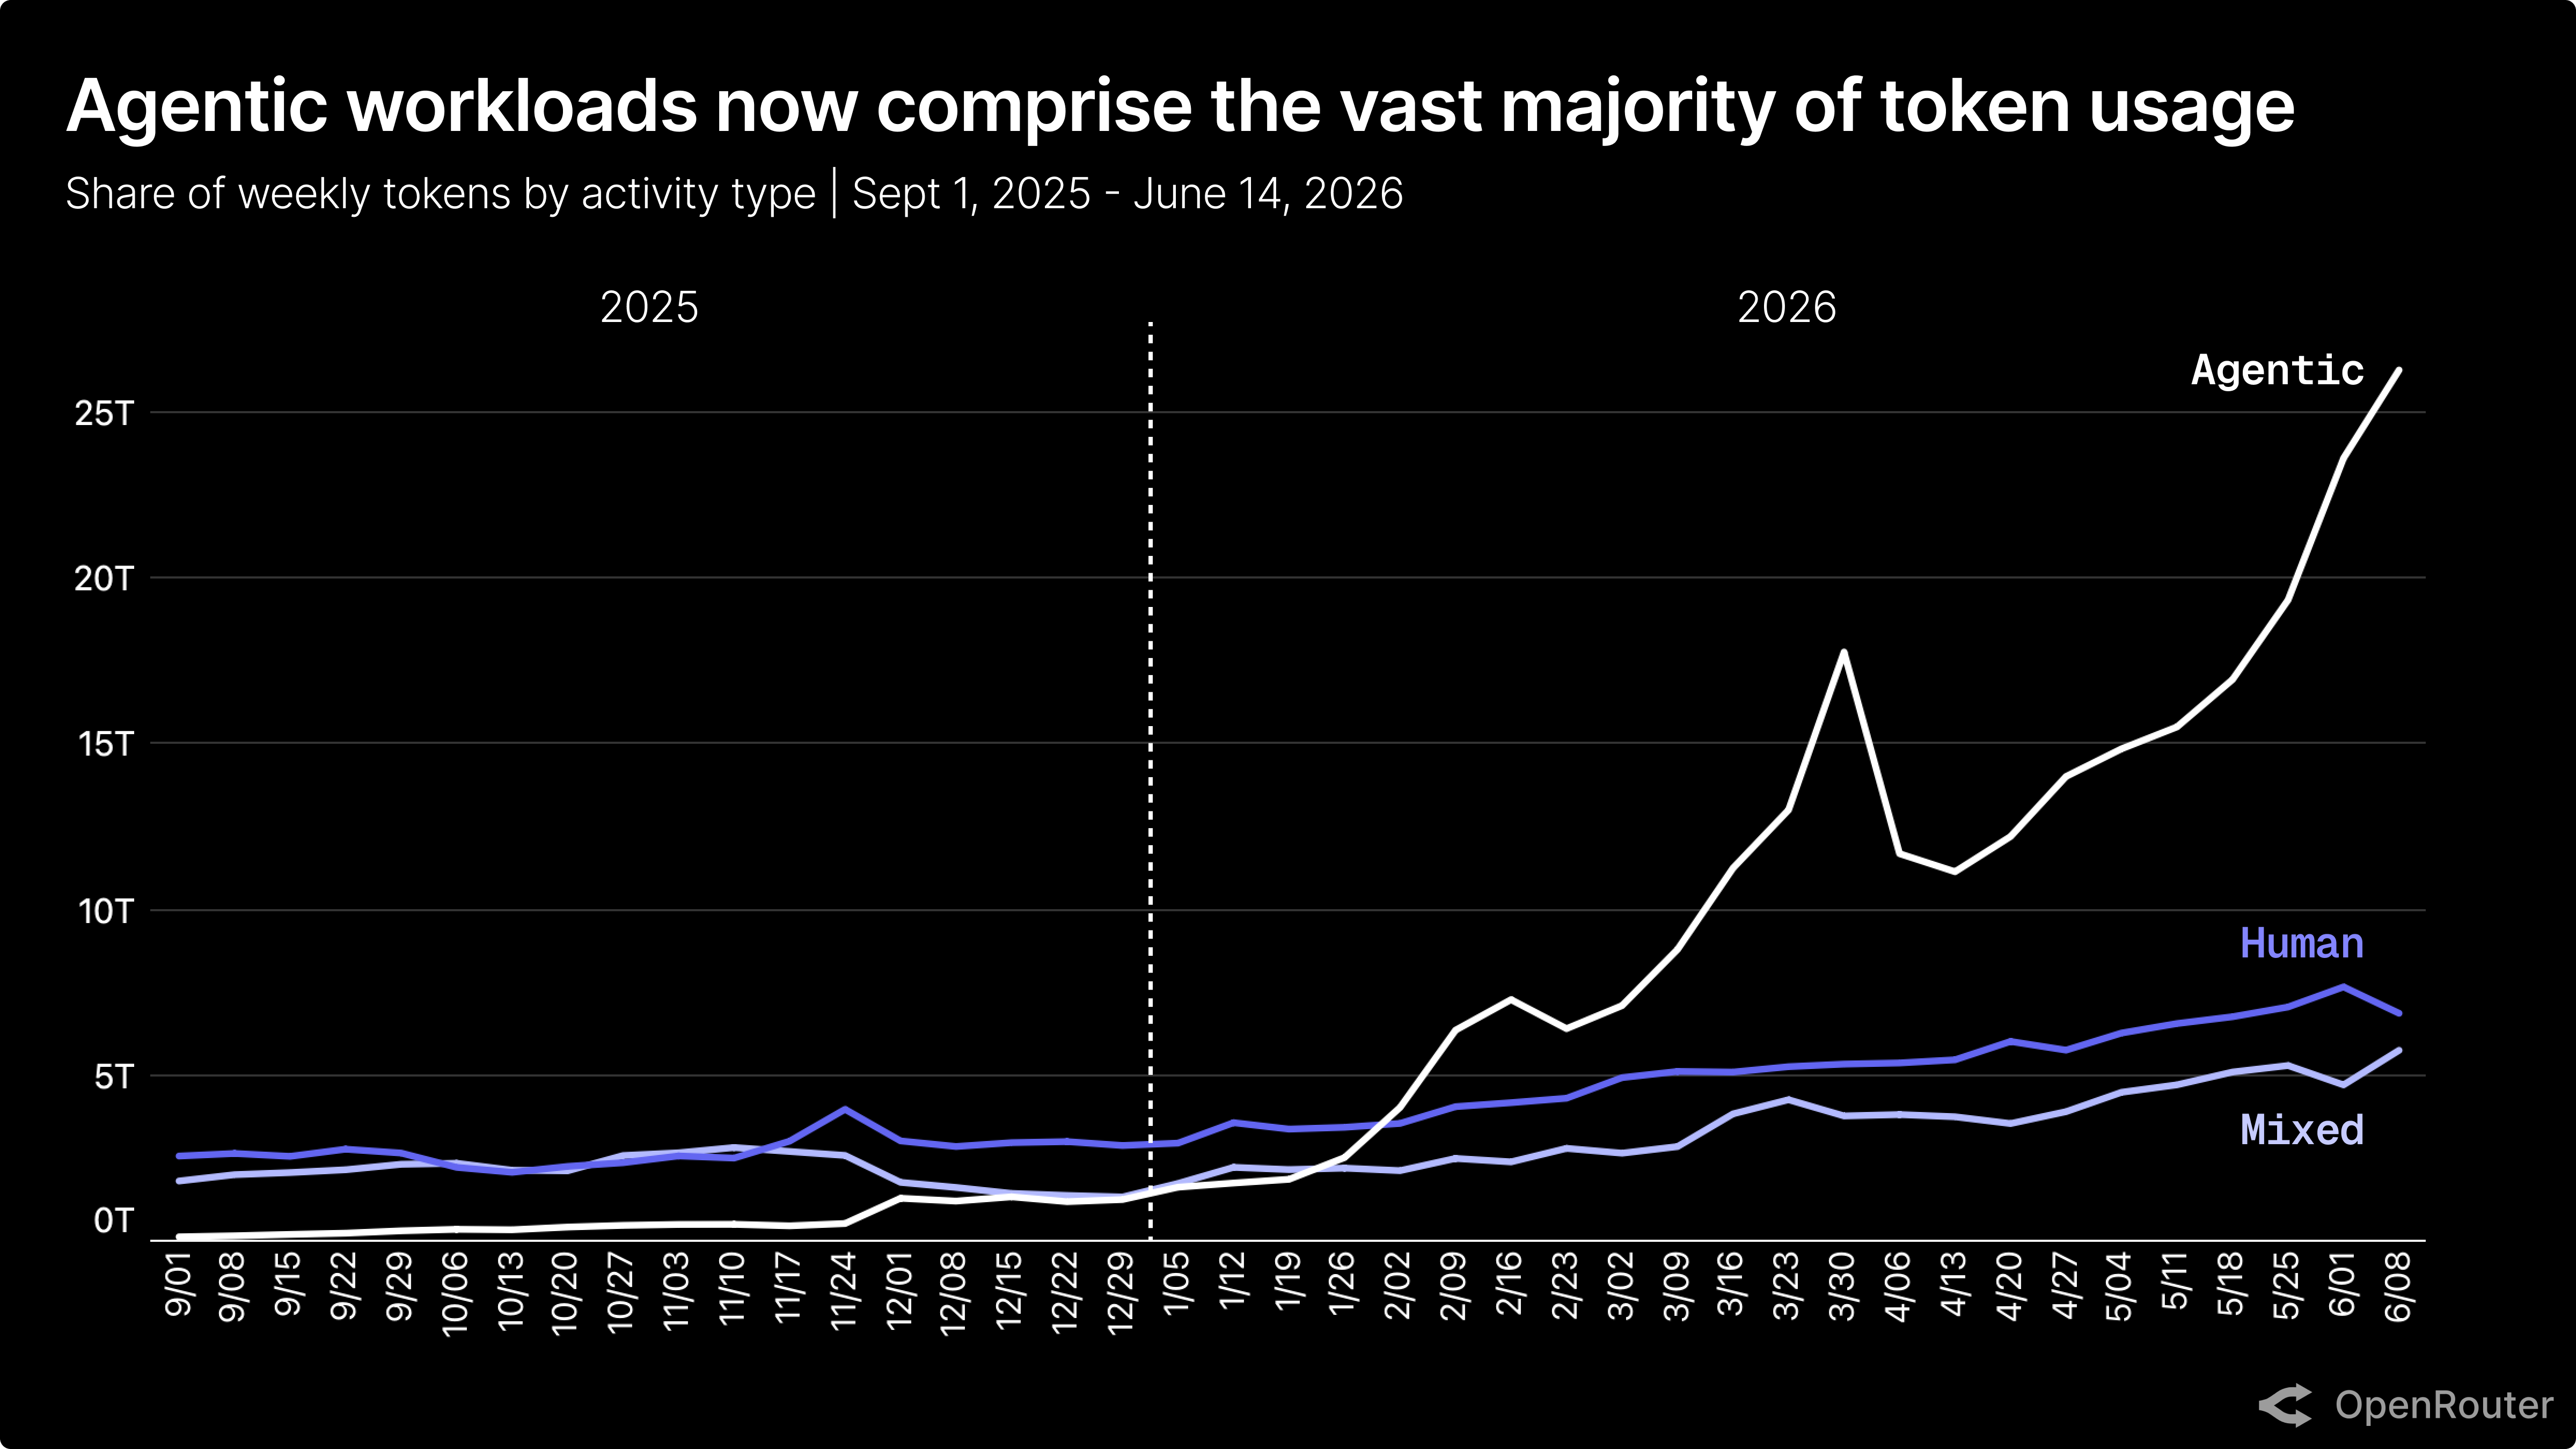
我们在 API 密钥级别将代币流量划分为三个主要类别(代理、混合和人类)。这些类别根据一个包含7个信号的加权综合评分分配,这些信号包括工具调用率、轮次数、间隔时间等。
众所周知,代理工作消耗的代币比正常人类 AI 使用多得多(根据 OpenRouter 数据,每个请求大约多15倍)。但需要记住的是,这种代理代币的爆炸式增长是2026年的现象,实际上直到今年2月初才真正开始。
不过,即使这样说对某些模型作者而言也过于夸张了。
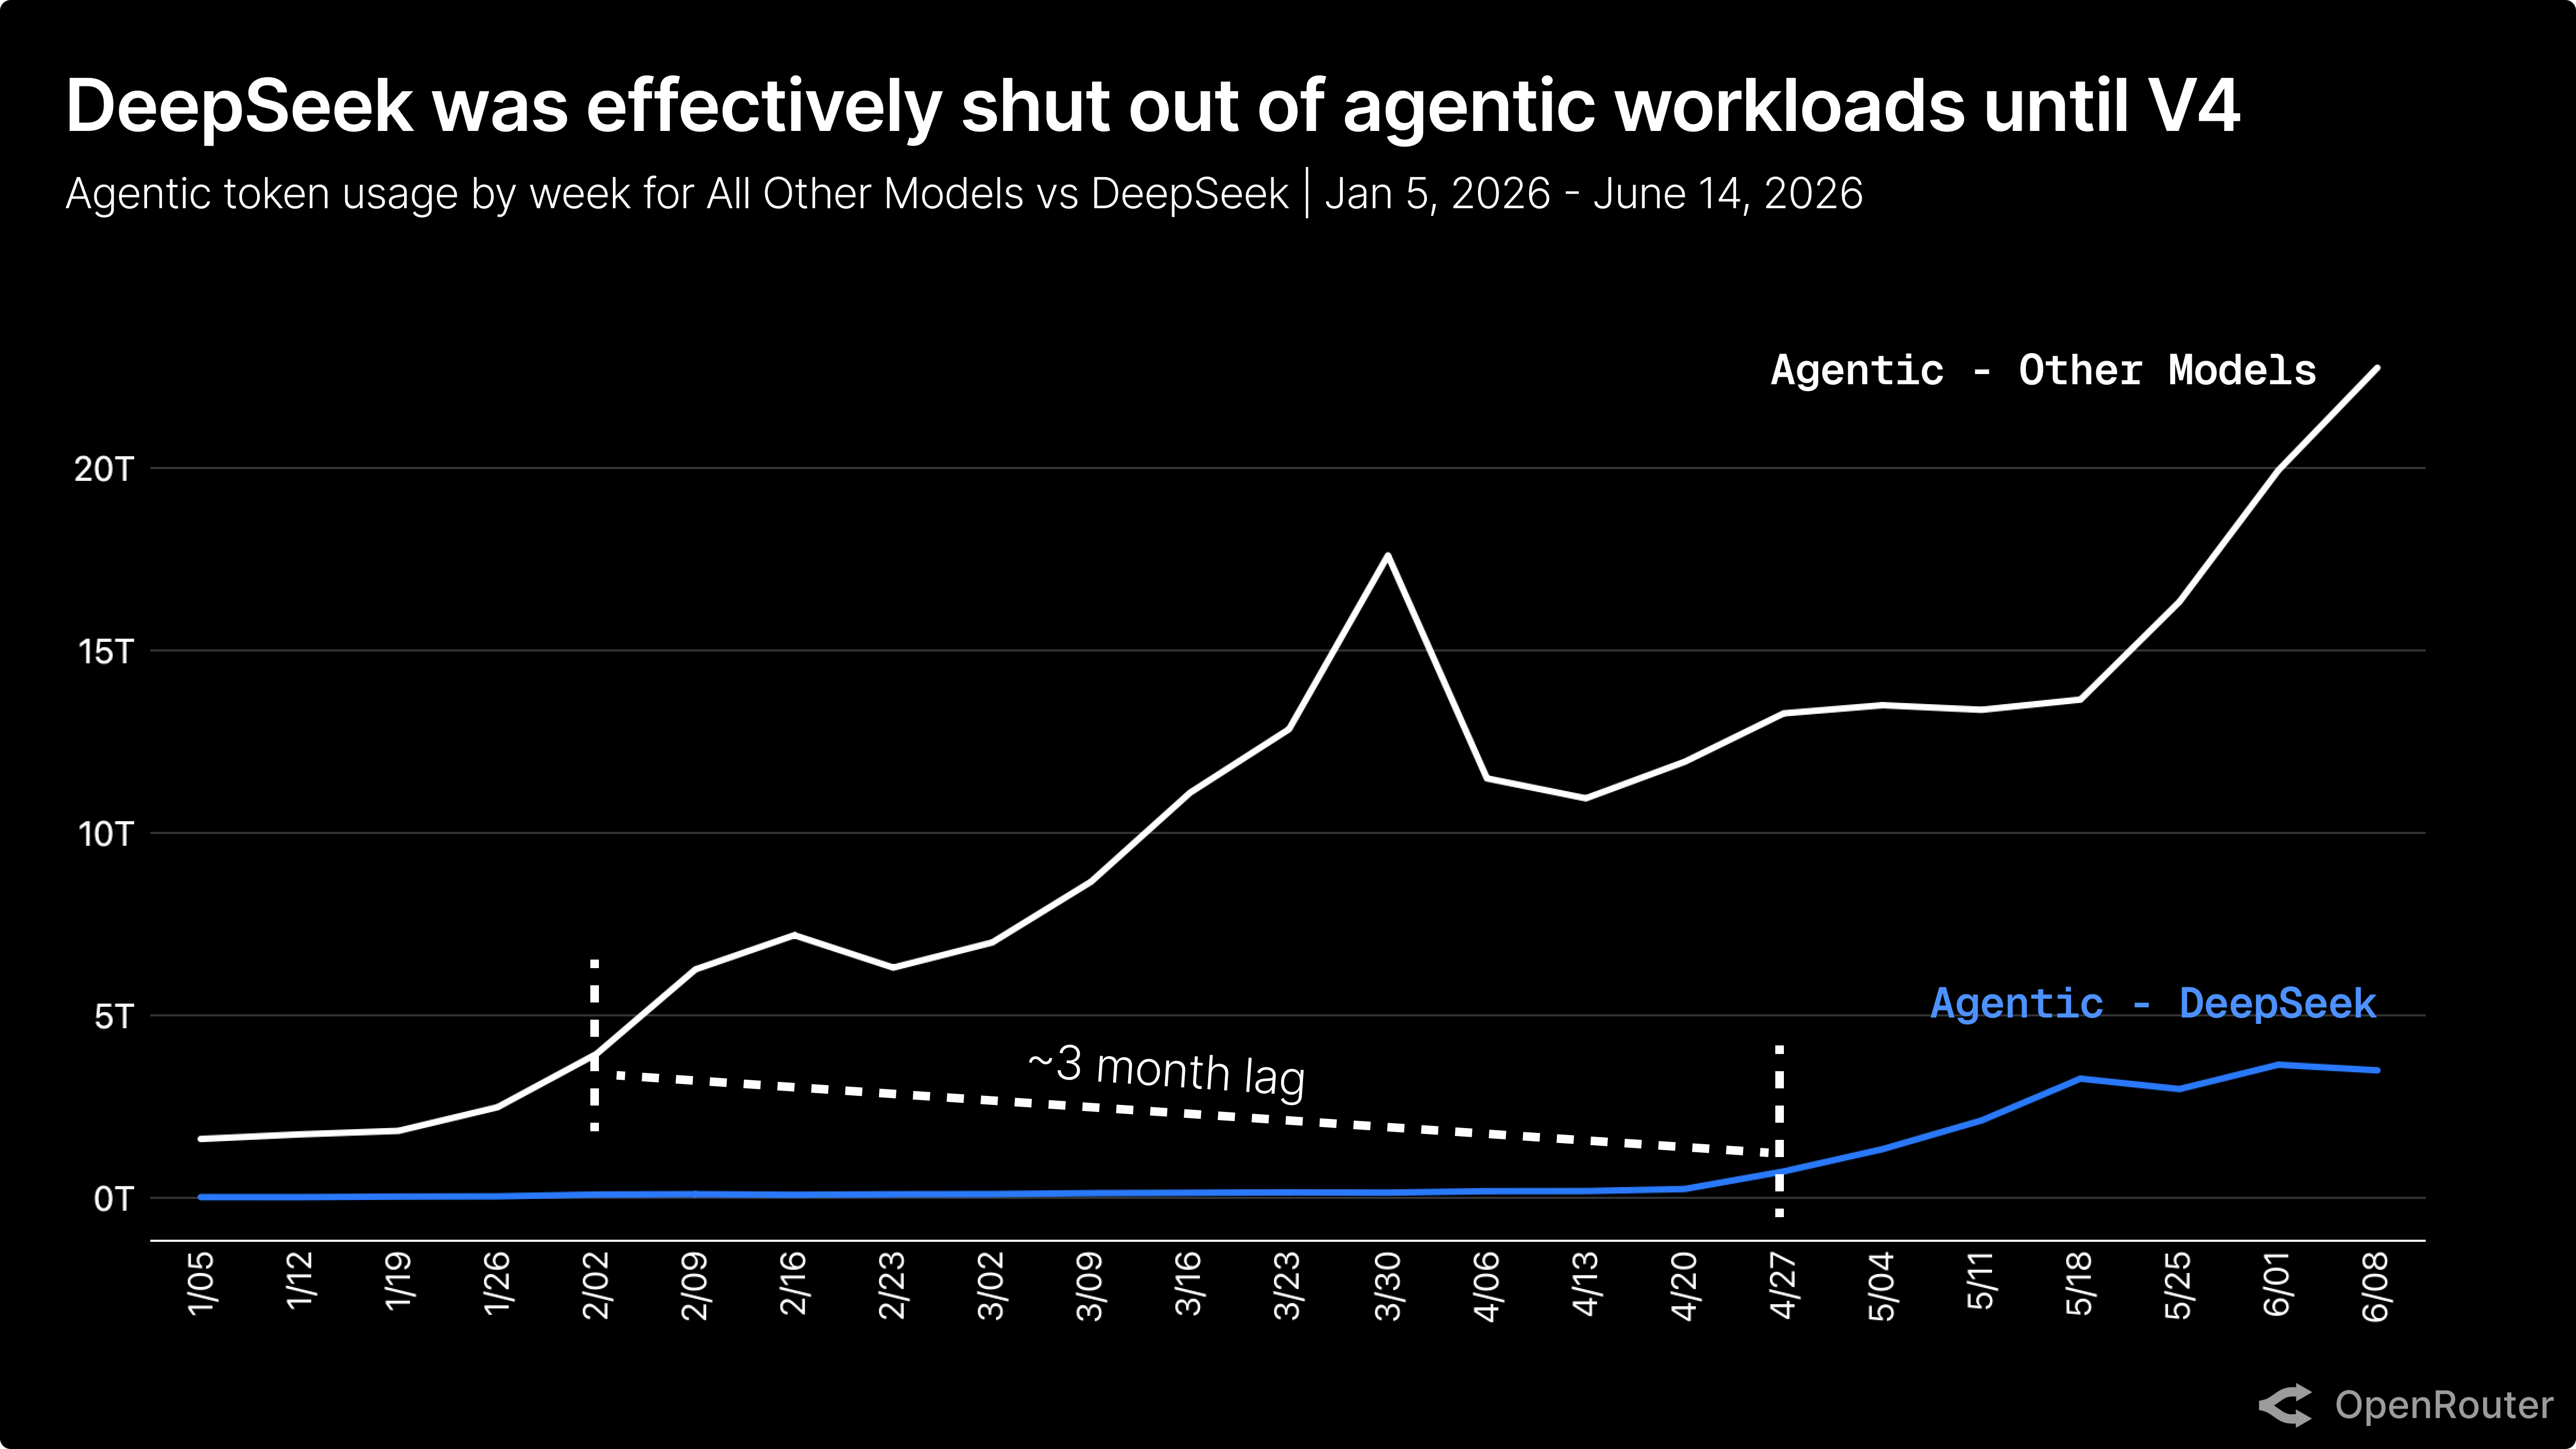
代理工作负载消耗的代币在2月1日左右超过了人类使用的代币。起初,代理工作仅集中在少数模型作者中,而 DeepSeek 并不在其中。
V4 的发布标志着 DeepSeek 正式加入代理工作流程的竞争。
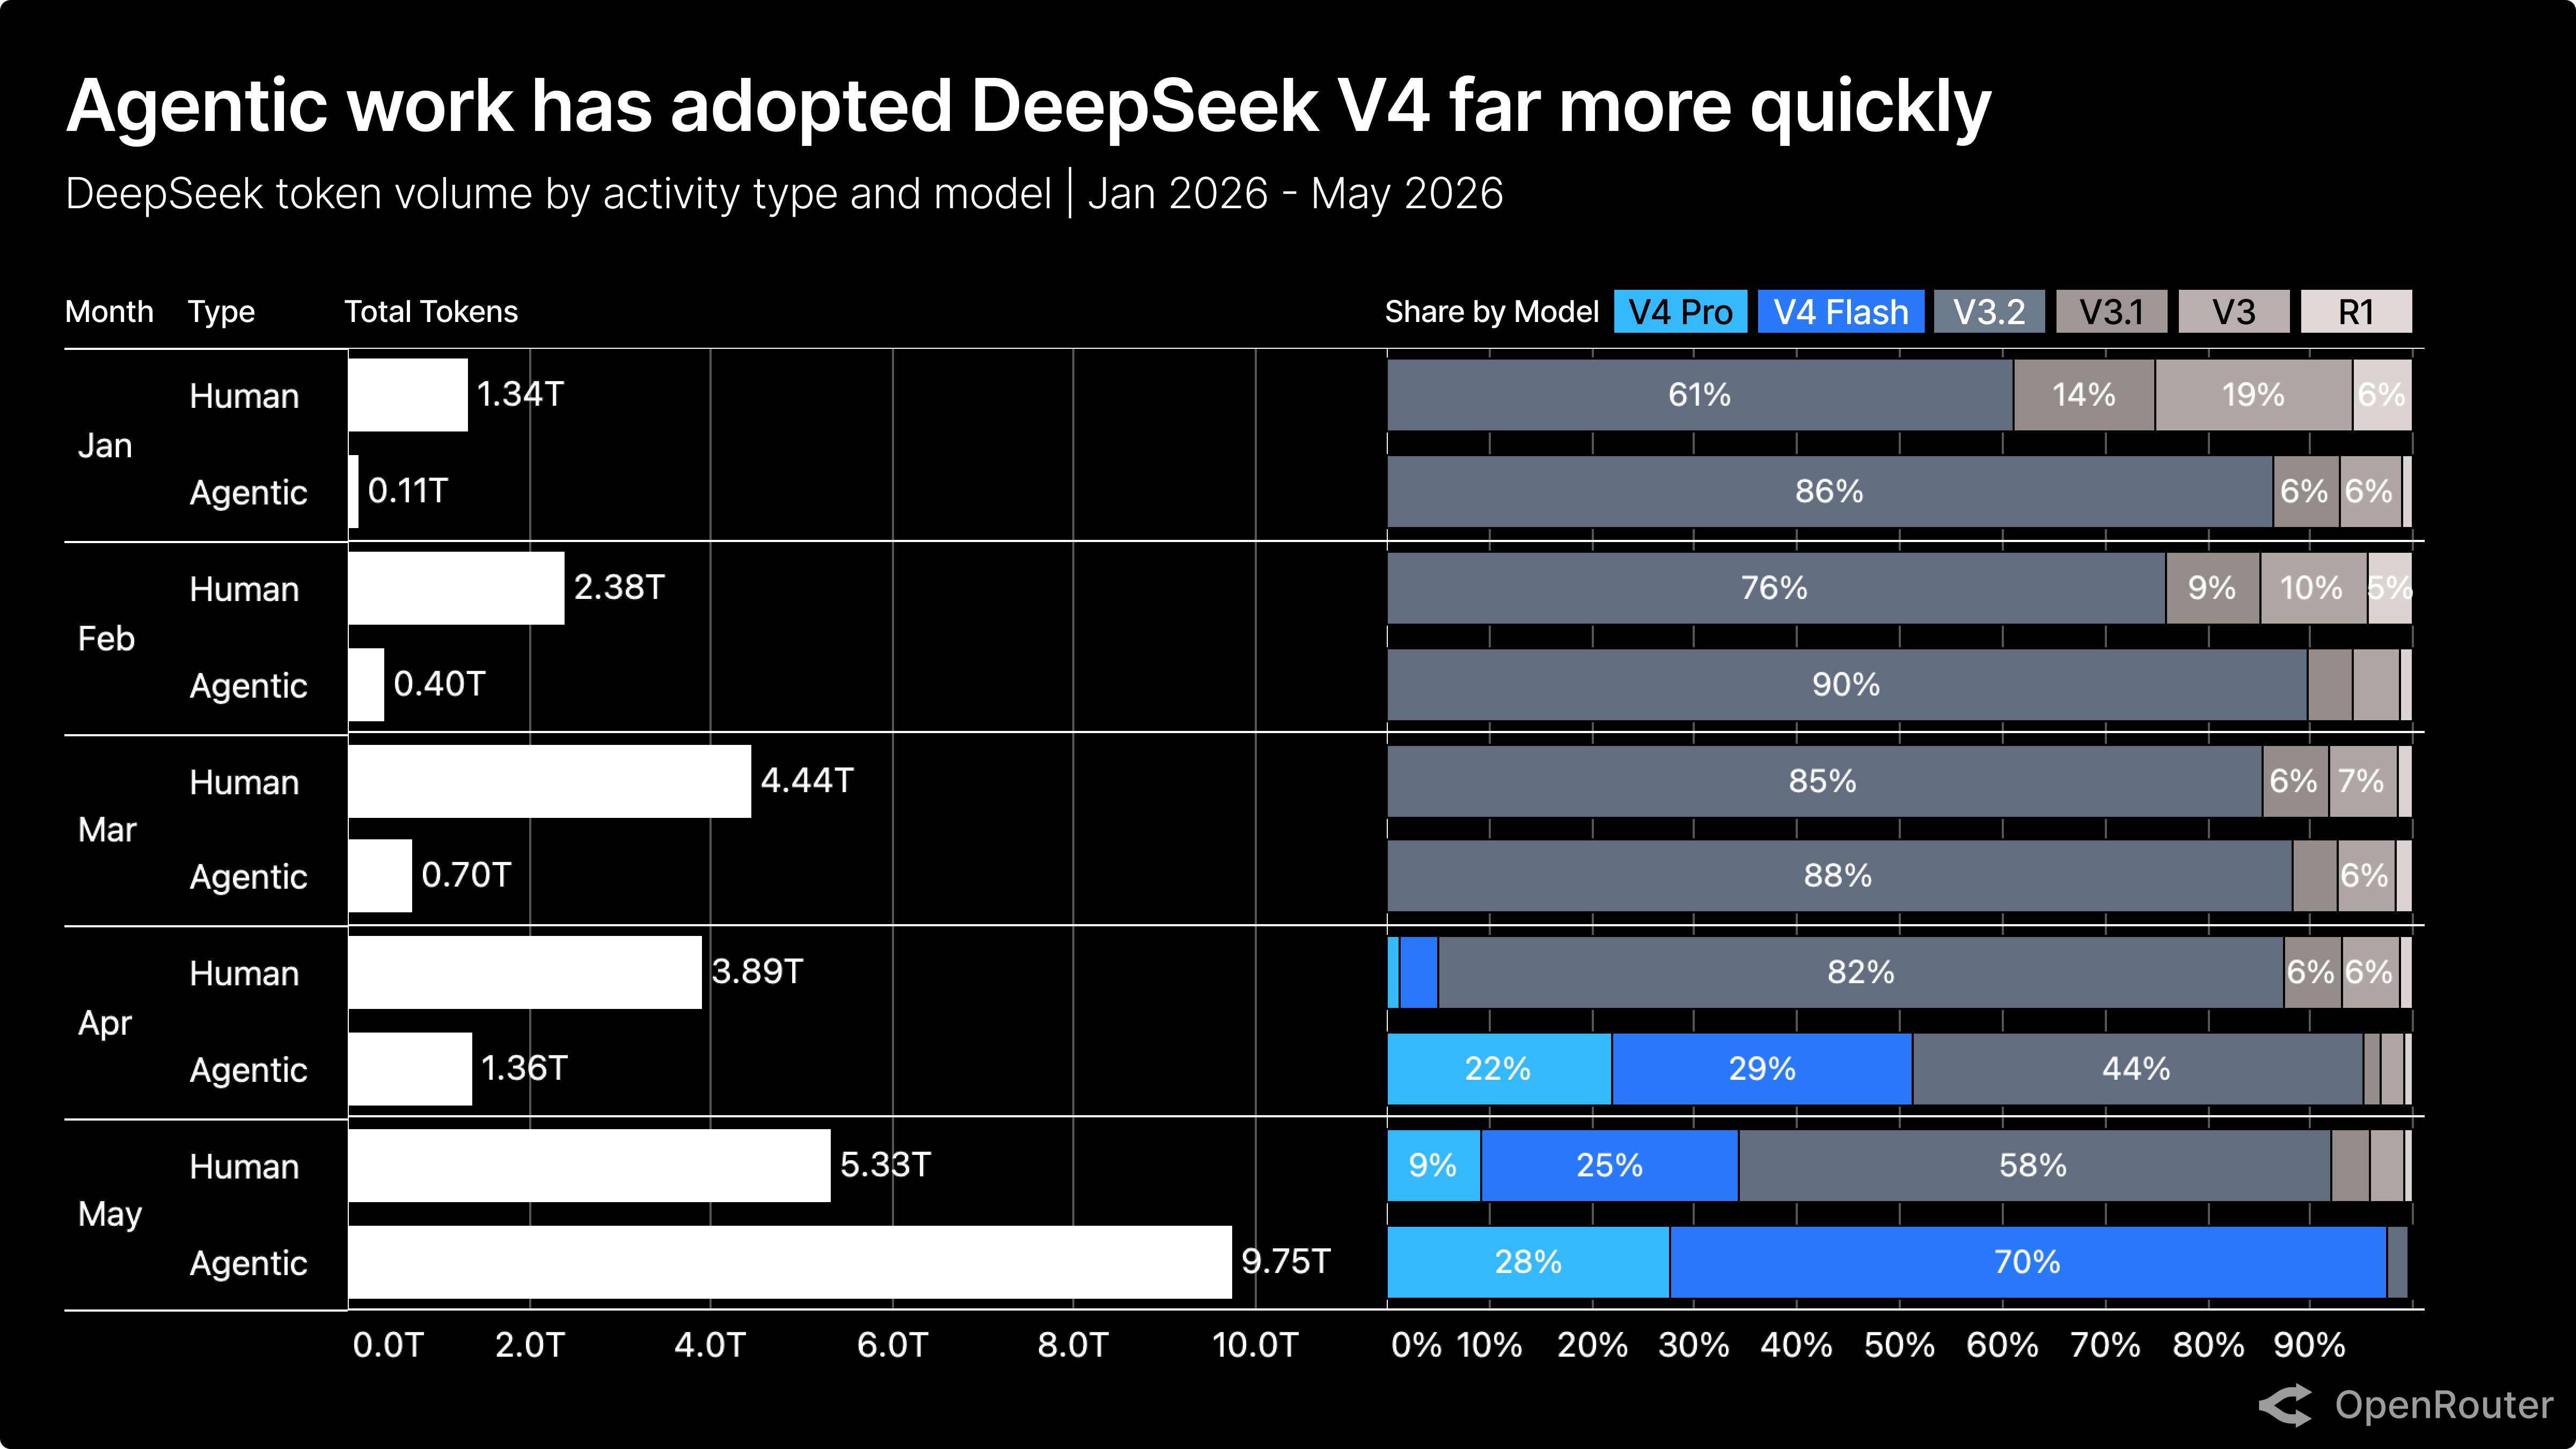
并非所有工作负载都会同时切换到最新模型。上图显示,今年前5个月中,DeepSeek 代币使用中的人类活动仍然与 DeepSeek V3.2 绑定在一起。
然而,代理密集型工作负载使 V4 成为其首选模型。截至 5 月底,即发布仅一个月后,V4-Flash 已占 DeepSeek 使用中代理型 token 流量的 70%。
DeepSeek 与中国模型的崛起
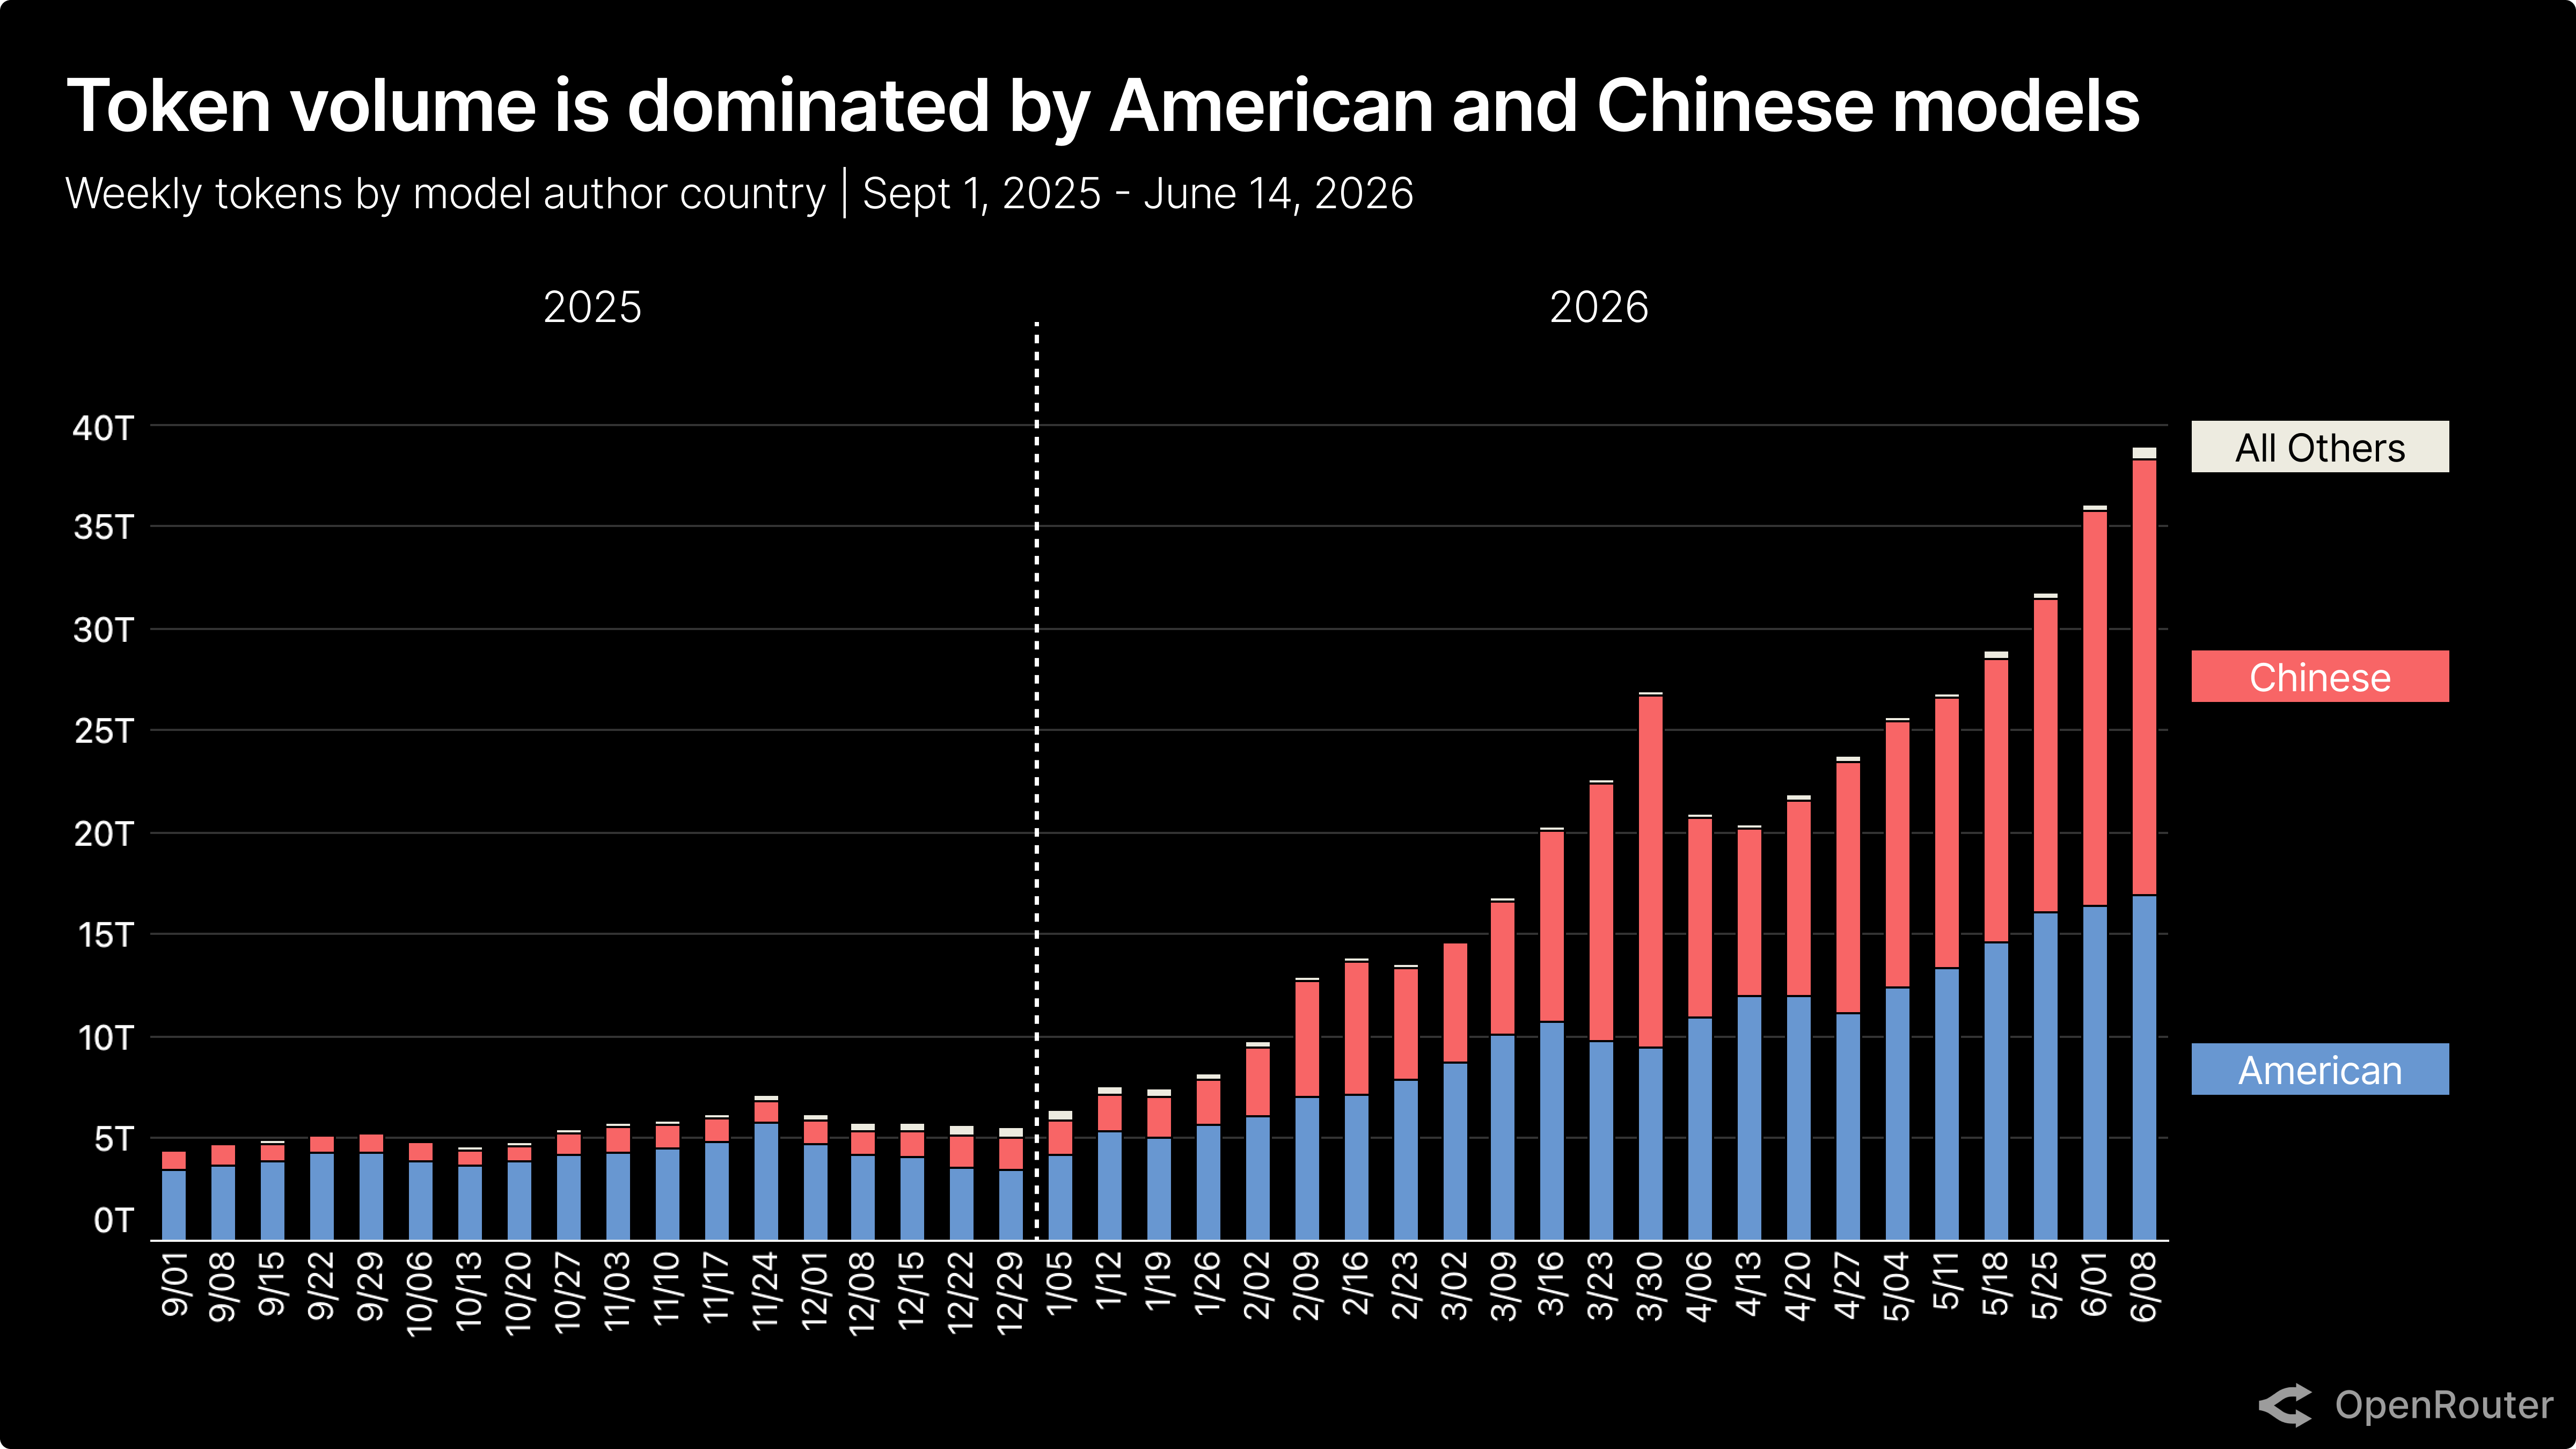
Token 流量流向两个国家创建的 LLM:美国和中国(浅棕色小切片中零星代表其他国家)。2026 年 token 数量激增,但增长并未扩散到其他国家的 LLM。
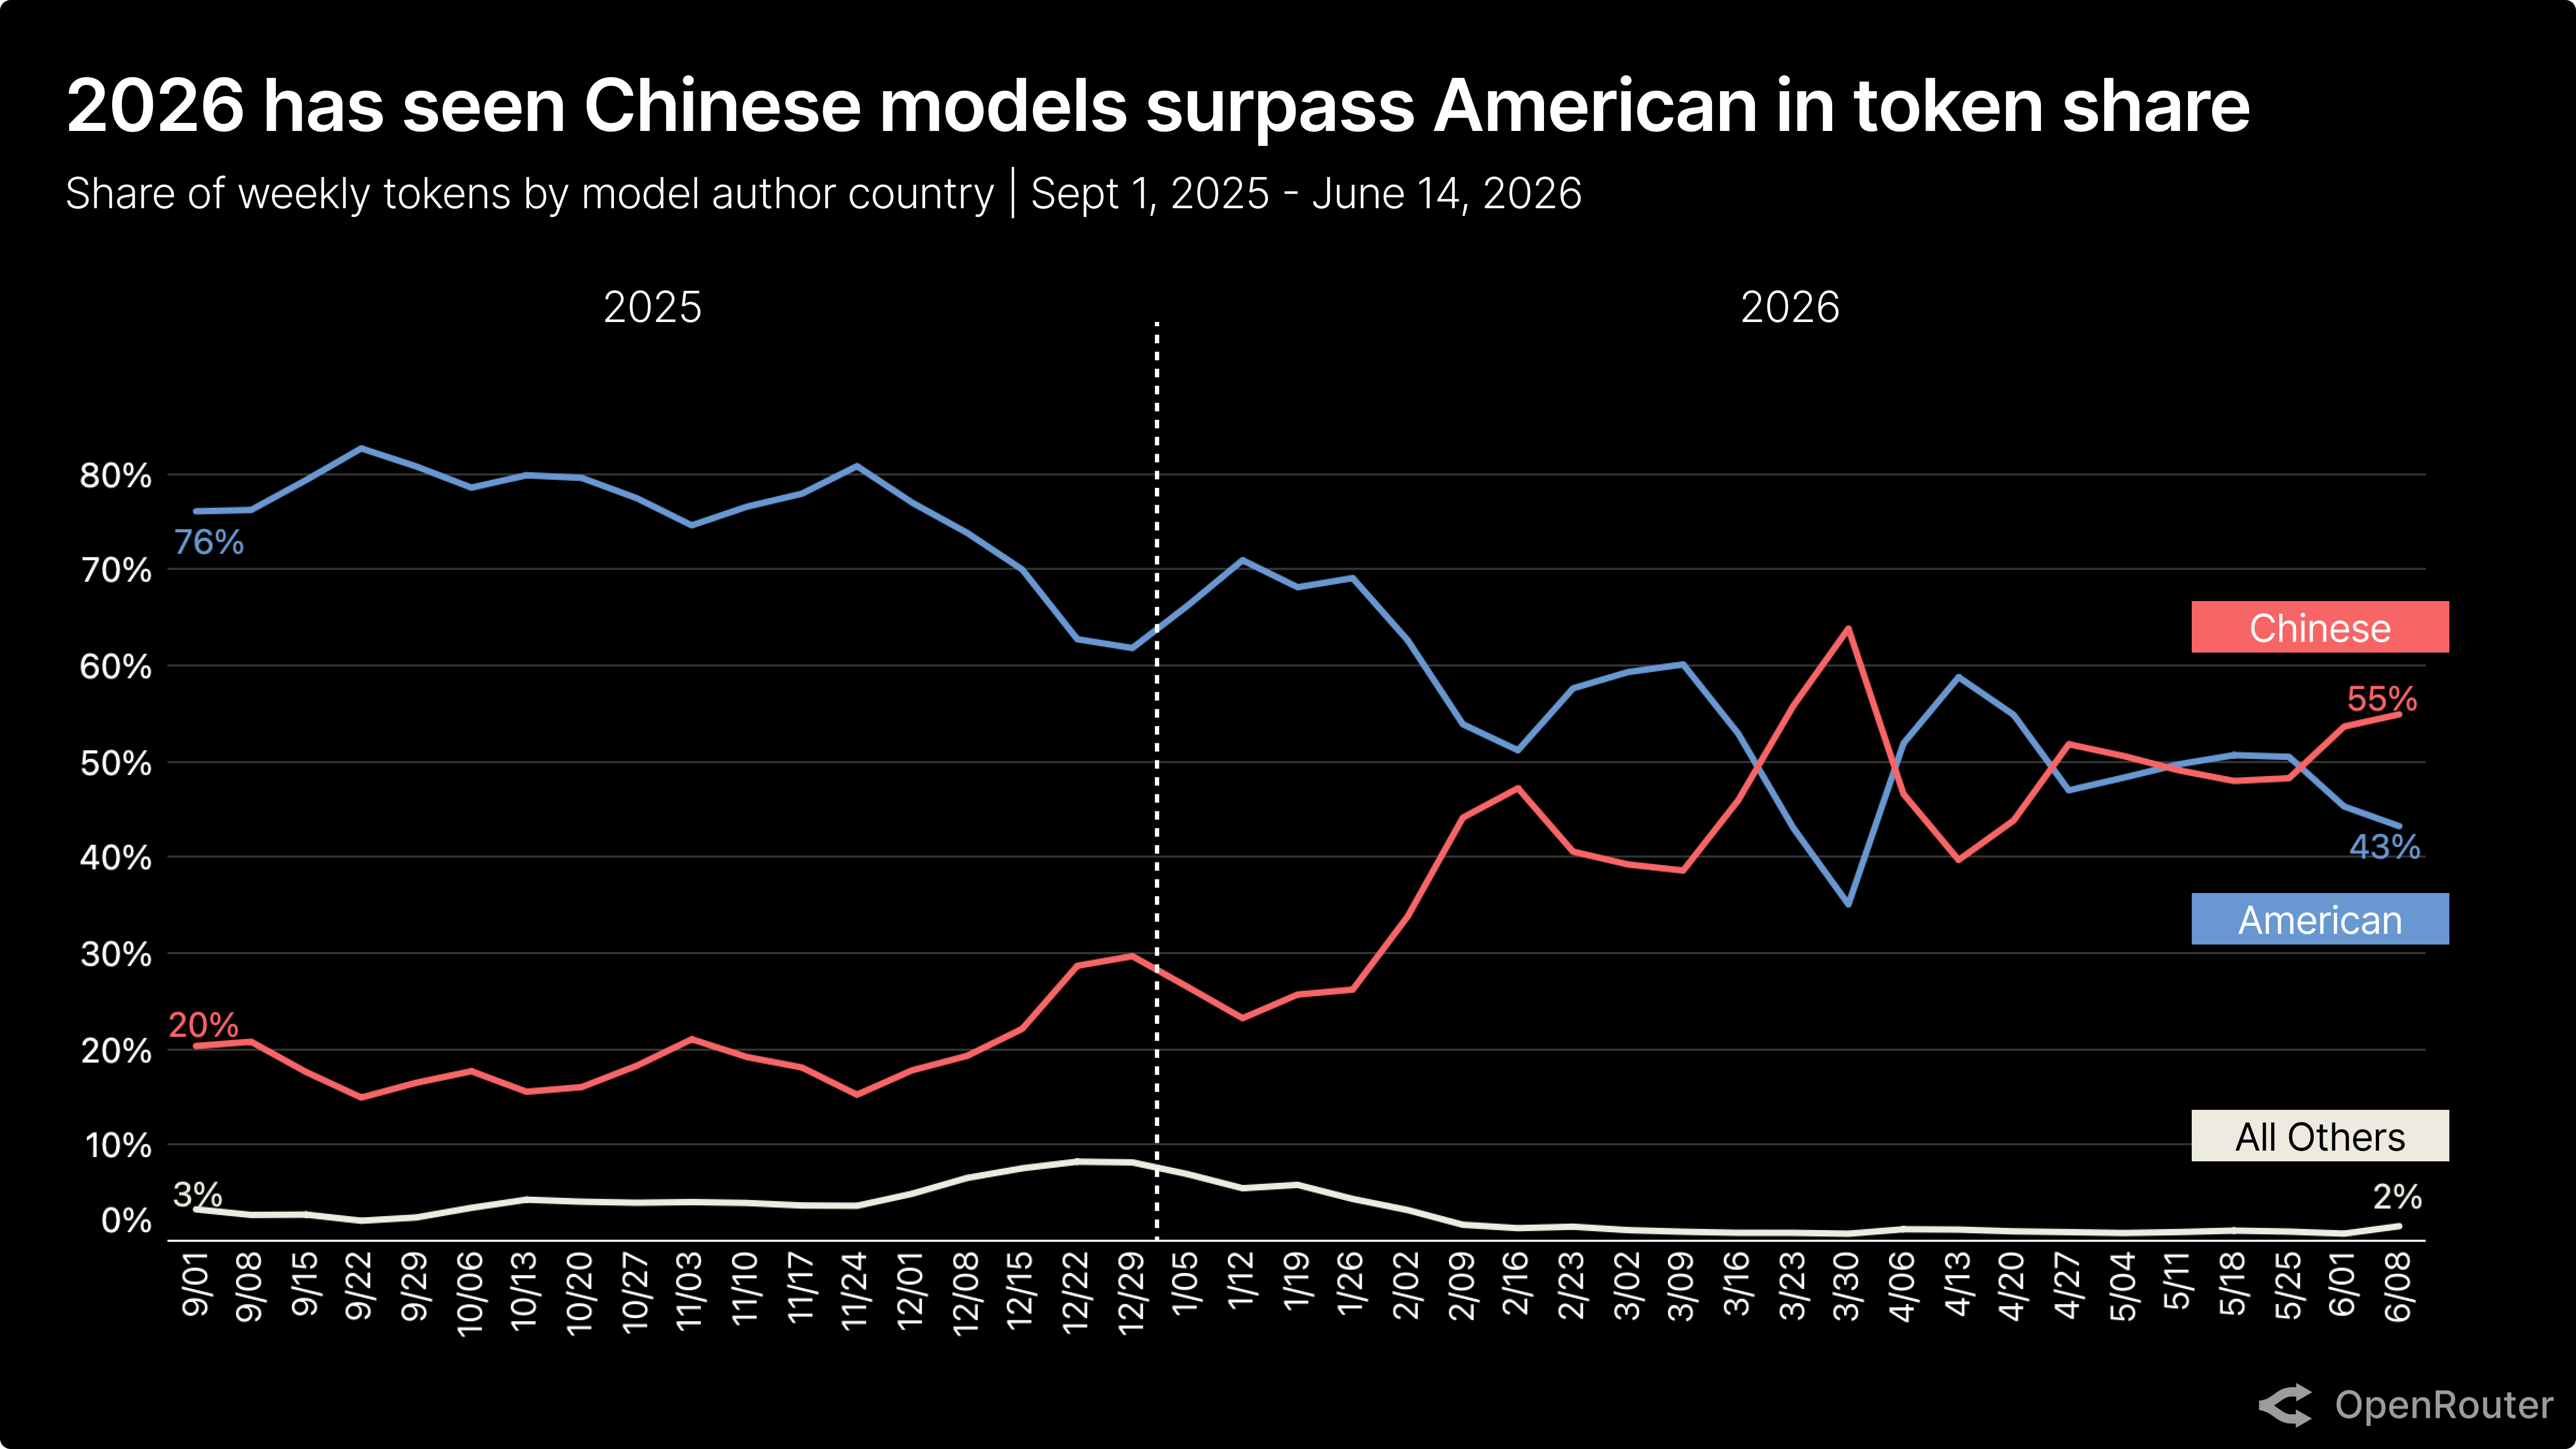
2025 年是美国 token 的年份,美国模型使用的 token 约占总数量的 3/4。2026 年竞争激烈得多,截至 6 月初,中国模型在 token 份额上实际上已超越美国模型。
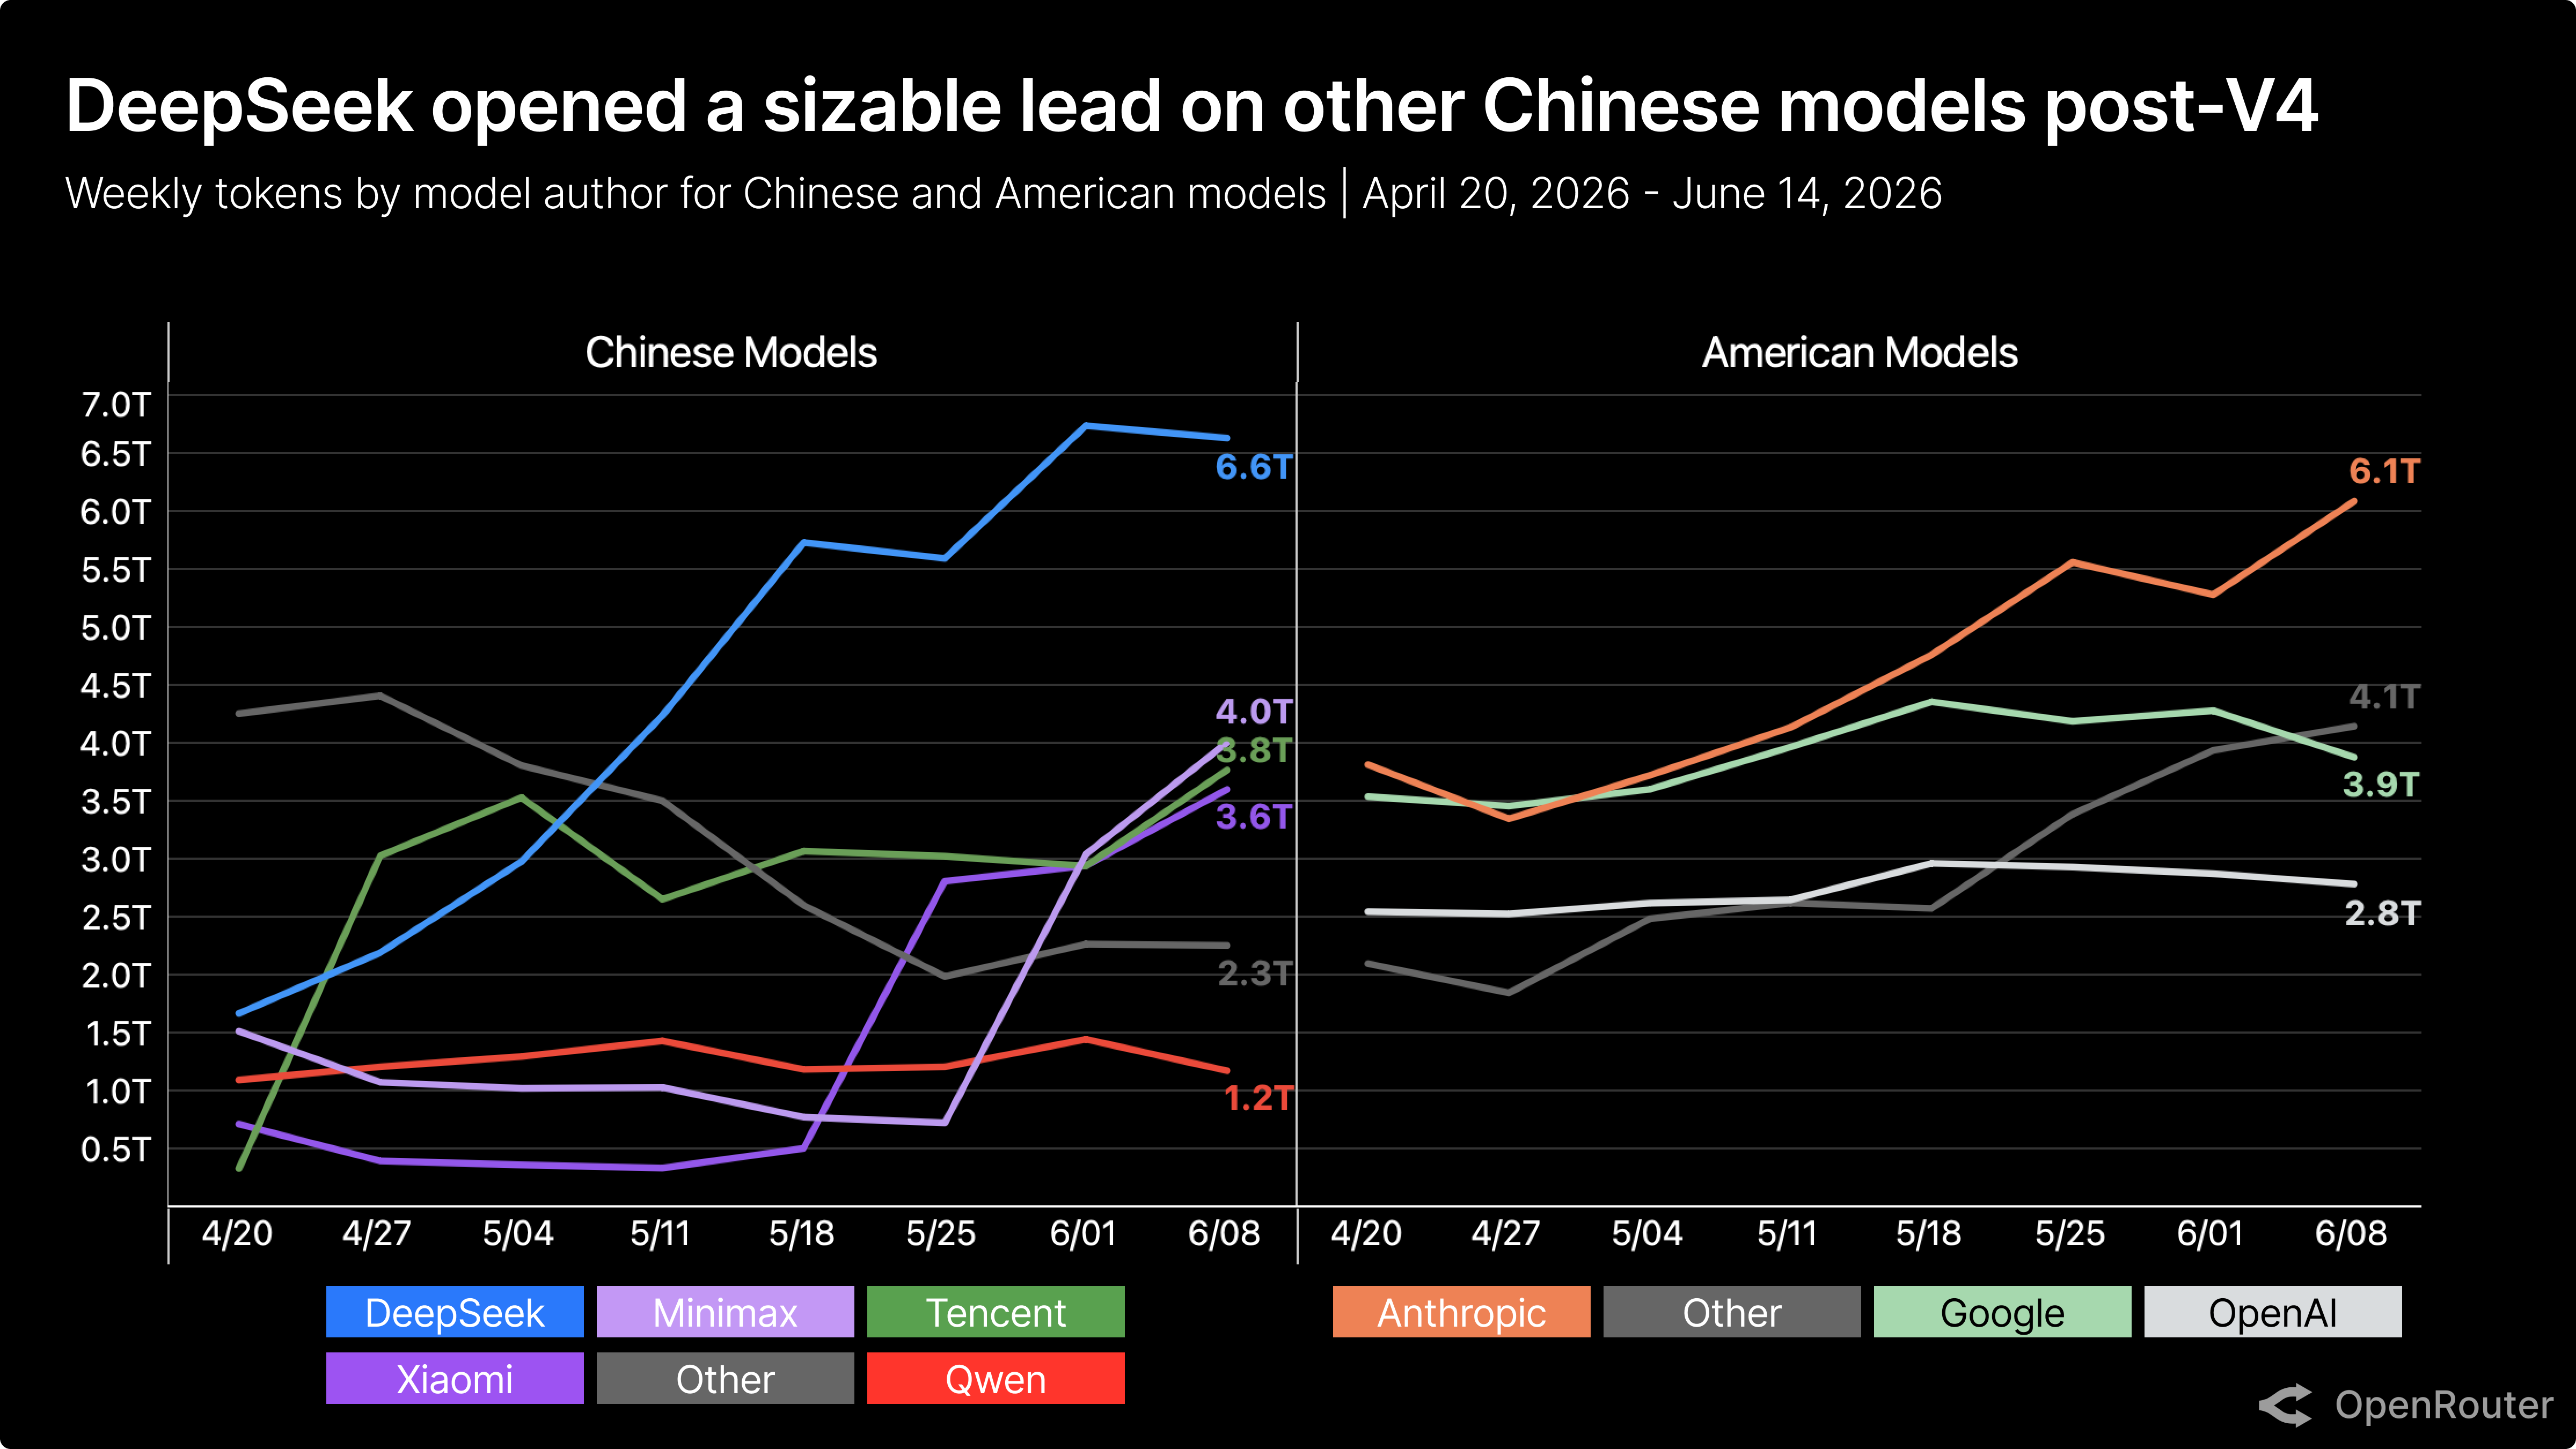
毫不意外的是,自 4 月底 V4 发布以来,DeepSeek 在中国模型中处于领先地位。尽管过去六周中几家美国领先者的 token 使用量趋于平稳,但多家中国竞争对手的 token 量在 6 月初出现了激增。
随着关于经济高效 token 使用的报道占据夏季头条,我们预计这些更便宜但依然强大的开源模型将继续吸引更多 token 使用。正如《华尔街日报》在近期报道(引用 OpenRouter 数据)中所言:“初创公司和科技巨头都在混合搭配 AI 模型,以避免高昂的溢价定价。”
DeepSeek V4 必将成为这一组合的一部分。
方法论说明
关于我们如何整合这些数据的几点说明:
- 数据来源:OpenRouter 的请求日志。
- 样本量:2026 年 1 月 1 日至 2026 年 6 月 14 日期间超过 450 万亿个 token。
- 份额指标:所有“份额”数据均指 token 数量(输入和输出合计)的份额,而非支出份额。如定价部分所述,对于 V4 等低成本模型,这两者可能相差悬殊。
- 活动类型:我们将 API key 级别的 token 流量分为三大类(代理型、混合型、人工型)。这些类别根据包含工具调用率、轮次数、间隔时间等七项信号加权综合评分进行分配。由于划分发生在 key 级别,执行混合任务的单个 key 会按其主导模式分类,而非按每个请求分类。
相关条目
92
精选OpenRouter 推出提示缓存与粘性路由,大幅降低多轮对话成本
对于高频调用 AI API 的开发者,这个功能堪称直接省钱利器。粘性路由保证了缓存命中率,配合 session_id 零配置接入,值得所有使用 OpenRouter 的团队立即尝试。
91
精选启用两项设置使ARC-AGI-3基准测试分数提升三倍
这项发现太关键了!它表明模型的性能不仅取决于训练,还取决于推理时的配置。对于AI工程师和研究者来说,这是一个必须注意的优化方向。特别是那些在资源受限设备上部署模型的团队,可能会因此找到低成本提升能力的方法。
91
精选GPT-5.6:前沿智能与前沿效率的融合
这条消息值得关注,因为它标志着大模型竞争从单纯拼参数转向拼效率。对于AI开发者和企业决策者来说,GPT-5.6意味着可以用更少预算获得更高性能,尤其适合那些被推理成本挡在门外的长上下文或Agent场景。OpenAI这一步,可能重新定义‘前沿’的标准。
91
精选LFM2.5-Encoder:面向CPU快速长上下文推理的新模型
这篇博文让我眼前一亮,因为它直接解决了大模型在CPU上跑长上下文的痛点。对于没有高端GPU的团队或个人开发者,LFM2.5-Encoder系列提供了可立即使用的开源方案。尤其推荐给做RAG、文档搜索或代码分析的朋友——现在用普通服务器就能处理百万级token的文档了。
91
精选GPT-Red:OpenAI通过自我对弈实现AI红队自动化,提升模型鲁棒性
GPT-Red 是红队测试从人工到自动化的里程碑,特别适合安全工程师和对齐研究者关注。它直接降低了测试成本,但也引发了对“自动攻击”本身的伦理讨论——值得所有关注AI治理的人深入思考。
91
精选OpenAI推出GPT-5.5生物漏洞赏金计划
这个计划值得关注,因为它首次将AI漏洞赏金制度拓展到生物安全领域,不仅为安全社区提供了新的研究方向,也为AI风险治理提供了实际演练场。对模型安全研究者、生物安全专家以及关心AI双重用途的从业者尤其重要。
91
精选vLLM推出原生速度Transformers建模后端,大幅提升推理性能
这项更新对于AI工程团队非常关键:无需格式转换意味着能更快地迭代模型,而2-5倍的速度提升直接降低GPU成本。如果你正在做LLM在线服务或者批量推理,这几乎是必读的技术更新。
90
精选Google DeepMind 发布手语转文本模型 SL2T,助力聋人用户
这则消息的意义不仅在于技术突破,更在于AI开始真正关注边缘群体的需求。对开发者而言,SL2T的架构思路和技术路径值得深入研究;对无障碍倡导者来说,这是推动行业标准的重要案例。