GPT-5.6系列发布:Luna、Terra、Sol三款模型亮相
评分
79提供详细基准对比和API新功能,对了解最新模型进展有较高信息增量。
内容来自知名博主Simon Willison的一手体验与官方信息结合,逻辑清晰,但部分为个人主观评价。
对开发者选择模型和API集成有直接参考价值,尤其定价和基准对比。
今日发布,时效性满分。
Simon Willison是知名AI开发者博客,信源可靠,且引用官方信息。
基础分 87.5 × T2 信源权重 ×0.9 = 79
精选线 70已入选精选
精选理由
模型发布本身具有高信息量,但实际表现仍需独立验证,且部分基准存在争议,综合评分8分。
AI 点评
「GPT-5.6在代理任务上的突破令人振奋,但SWE-Bench的争议提醒我们标榜成绩需谨慎。对需要复杂推理和长程自主任务的开发者来说,Sol可能成为新选择;而对成本敏感的场景,Luna和Terra性价比突出。API新特性如编程工具调用和多Agent子代理值得深入探索。」
速览
OpenAI今日正式发布GPT-5.6系列旗舰模型,包括Luna、Terra、Sol三款尺寸。基准测试显示,Sol在“Agent最后考试”中以53.6分超越Claude Fable 5(40.5分),提升13.1分。即使在中等推理模式下,Sol也能以约四分之一成本领先Fable 5 11.4分。Terra和Luna则以约十六分之一成本超越Fable 5。新模型引入编程工具调用、多Agent子代理、提示缓存断点等API特性。但SWE-Bench Pro基准测试中Fable 5仍领先(80% vs Sol的64.6%),OpenAI此前发文质疑该基准约30%任务存在问题。
- GPT-5.6系列包括Luna、Terra、Sol三款模型,定价从$1/$6到$5/$30每百万token。
- 在Agent长期工作流基准“Agents’ Last Exam”上,Sol以53.6分大幅领先Claude Fable 5(40.5分)。
- 新API支持:编程工具调用(JavaScript编排)、多Agent子代理、提示缓存断点、图像原始分辨率。
- SWE-Bench Pro上Fable 5仍领先,OpenAI此前指该基准约30%任务存在缺陷。
正文
OpenAI最新的旗舰模型 今天上午正式上线,并提供三种尺寸:Luna、Terra和Sol(从小到大)。
新模型按每百万输入/输出令牌定价为:Luna $1/$6,Terra $2.50/$15,Sol $5/$30。作为对比,Claude Opus系列为$5/$25,Claude Fable 5为$10/$50,但每百万令牌的价格现在并不能说明太多问题,因为对于相同任务,不同模型之间的推理令牌数量可能相差很大。
OpenAI最大的基准测试主张涉及长期运行的智能体性能,一项基准测试显示所有三个模型均优于Claude Fable 5:
我们训练了GPT-5.6,让每个令牌都能产生更多有用的工作。在Agents’ Last Exam,一项横跨55个领域、评估长期专业工作流程的基准测试上,GPT-5.6 Sol取得了53.6的新高,比Claude Fable 5(自适应推理)高出13.1分。即使在中等推理水平下,它也比Fable 5高出11.4分,而预估成本仅为后者的四分之一左右。这种效率延伸到更小的模型,这对于让智能更丰富、更实惠至关重要:GPT-5.6 Terra和GPT-5.6 Luna以大约六分之一的成本超越了Fable 5。
有趣的是,Fable 5在SWE-Bench Pro上碾压GPT-5.6系列的一个自我报告基准测试中,Fable 5获得了80%,而GUT-5.6 Sol只有64.6%。这可能有助于解释为什么OpenAI选择在昨天发布这篇文章,专门指出他们在审计该基准时发现的问题:
基于这些结果,我们估计大约30%的SWE-bench Pro任务是损坏的,并建议模型开发者仔细检查结果。
我早期试用过GPT-5.6 Sol——它确实非常强大,但到目前为止,在我使用Anthropic模型进行的复杂编码任务中,它并没有让我觉得比Fable更好。
像往常一样,使用GPT-5.6的模型指导包含了最有趣的细节。有一堆新的API功能需要我探索(并可能在LLM中添加支持),包括:
- Programmatic Tool Calling允许模型“编写和运行编排工具调用的JavaScript”——在我看来,这有助于弥合MCP与完整终端会话之间的差距,后者可以用有用的方式组合CLI工具。这也让人联想到Anthropic在其网络搜索工具中添加的dynamic filtering机制,该机制允许在单个模型轮次中针对网络结果执行代码。
- Multi-agent让模型“启动子智能体进行并行、专注的工作”——子智能体模式现已内置于核心API中。
- Prompt cache breakpoints将Claude的提示缓存模型引入OpenAI,让你明确指定缓存断点的位置,而不是依赖API自动检测。我个人更喜欢自动检测(OpenAI仍然支持),但如果你投入工作,大概可以在此处获得优化成本节省。
- 你现在可以在图像请求上设置detail: original,以避免在处理前对图像进行任何缩放。
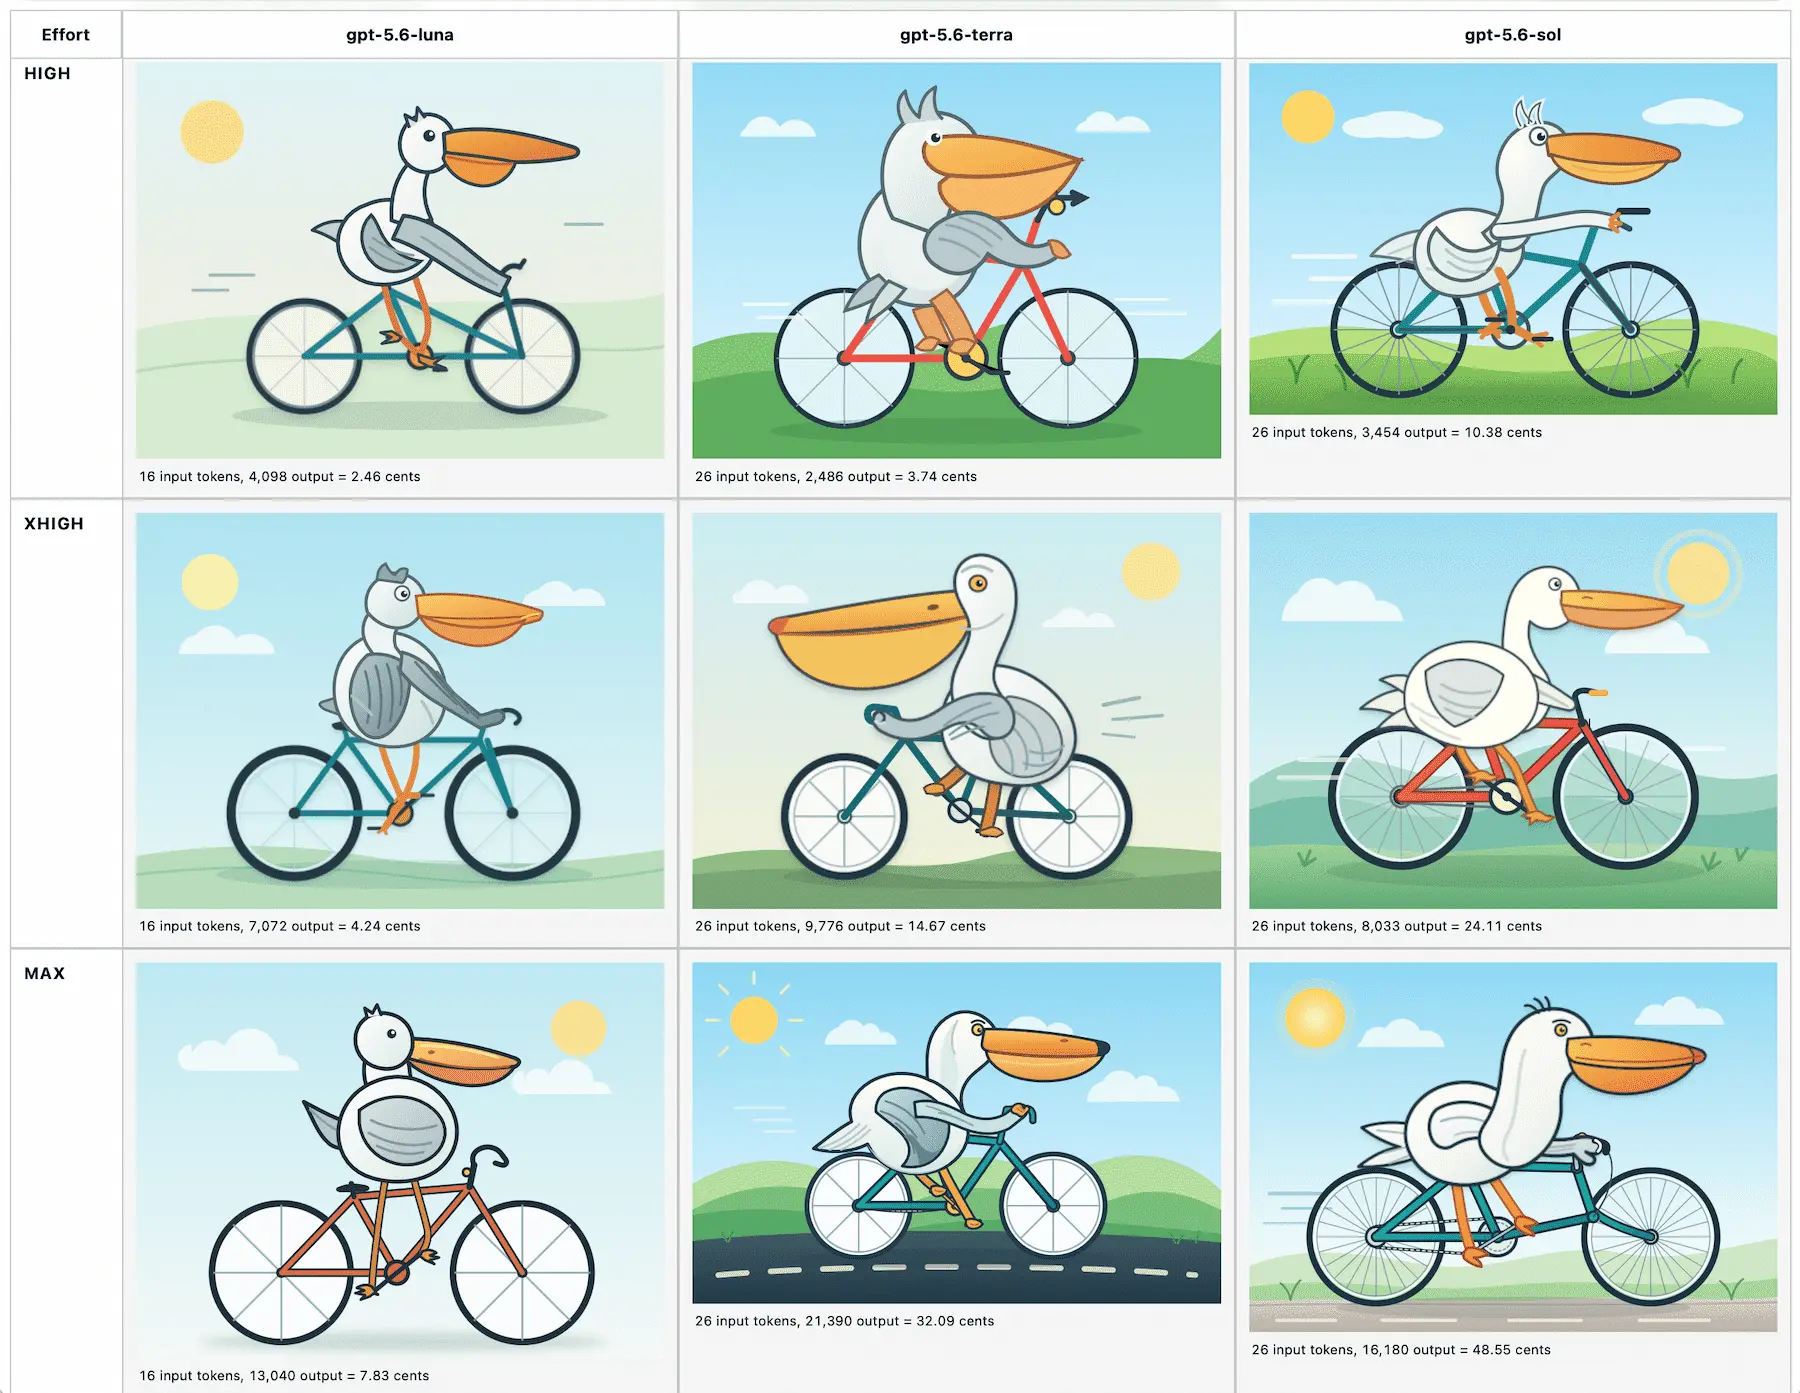
这里有一个 包含18种不同鹈鹕的完整页面 —— 展示了三种不同模型在推理努力程度(none、low、medium、high、xhigh、max)下的结果。同时还列出了它们的token数量和计算成本——最便宜的是gpt-5.6-luna在none努力程度下,花费0.71美分;最贵的是gpt-5.6-sol在max推理级别下,花费48.55美分。
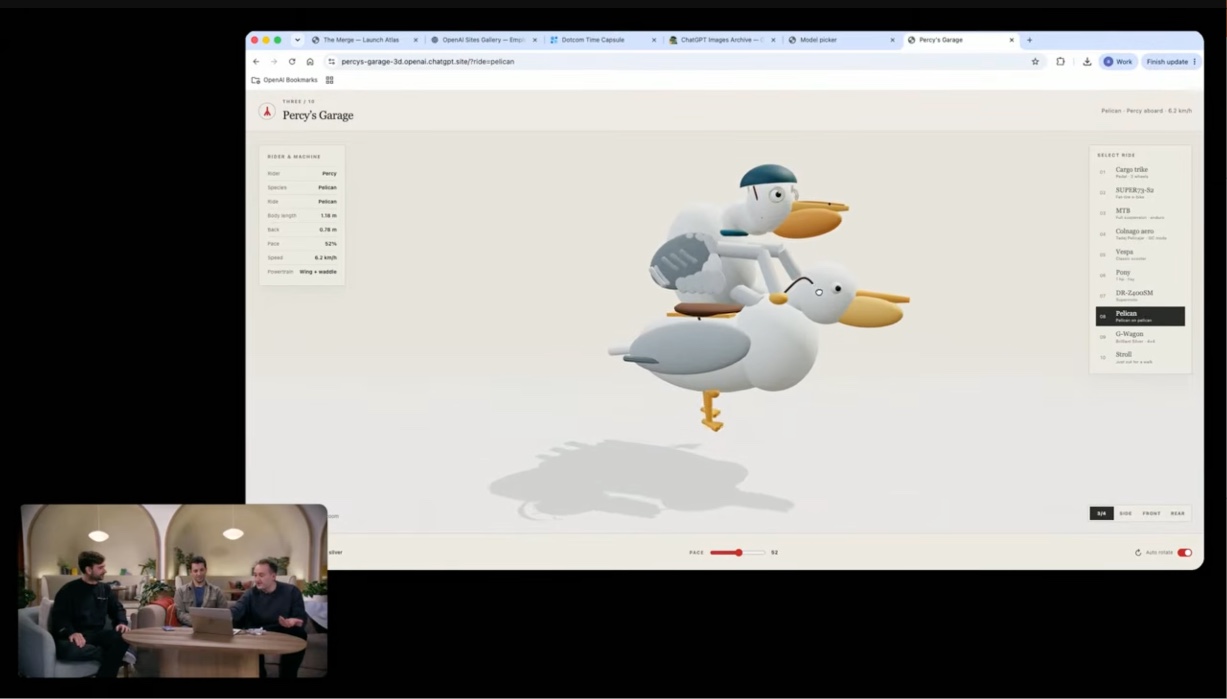
更多关于鹈鹕的新闻:如果你跳到 他们今天早上的直播 的17:50,你会看到OpenAI自己的演示——3D鹈鹕骑三轮车、自行车、小马,还有另一只鹈鹕!
标签:ai, openai, generative-ai, llms, llm-tool-use, llm-pricing, pelican-riding-a-bicycle, llm-release, gpt-5
相关条目
精选DeepSeek V4 在 OpenRouter 上的代币份额翻倍,智能体工作负载成主要驱动力
DeepSeek V4 的快速采用表明市场对高性能、低成本推理模型的强烈偏好,尤其是智能体场景将重塑 AI 部署格局。
91
精选启用两项设置使ARC-AGI-3基准测试分数提升三倍
这项发现太关键了!它表明模型的性能不仅取决于训练,还取决于推理时的配置。对于AI工程师和研究者来说,这是一个必须注意的优化方向。特别是那些在资源受限设备上部署模型的团队,可能会因此找到低成本提升能力的方法。
91
精选GPT-5.6:前沿智能与前沿效率的融合
这条消息值得关注,因为它标志着大模型竞争从单纯拼参数转向拼效率。对于AI开发者和企业决策者来说,GPT-5.6意味着可以用更少预算获得更高性能,尤其适合那些被推理成本挡在门外的长上下文或Agent场景。OpenAI这一步,可能重新定义‘前沿’的标准。
91
精选LFM2.5-Encoder:面向CPU快速长上下文推理的新模型
这篇博文让我眼前一亮,因为它直接解决了大模型在CPU上跑长上下文的痛点。对于没有高端GPU的团队或个人开发者,LFM2.5-Encoder系列提供了可立即使用的开源方案。尤其推荐给做RAG、文档搜索或代码分析的朋友——现在用普通服务器就能处理百万级token的文档了。
91
精选GPT-Red:OpenAI通过自我对弈实现AI红队自动化,提升模型鲁棒性
GPT-Red 是红队测试从人工到自动化的里程碑,特别适合安全工程师和对齐研究者关注。它直接降低了测试成本,但也引发了对“自动攻击”本身的伦理讨论——值得所有关注AI治理的人深入思考。
91
精选OpenAI推出GPT-5.5生物漏洞赏金计划
这个计划值得关注,因为它首次将AI漏洞赏金制度拓展到生物安全领域,不仅为安全社区提供了新的研究方向,也为AI风险治理提供了实际演练场。对模型安全研究者、生物安全专家以及关心AI双重用途的从业者尤其重要。
91
精选vLLM推出原生速度Transformers建模后端,大幅提升推理性能
这项更新对于AI工程团队非常关键:无需格式转换意味着能更快地迭代模型,而2-5倍的速度提升直接降低GPU成本。如果你正在做LLM在线服务或者批量推理,这几乎是必读的技术更新。
90
精选Google DeepMind 发布手语转文本模型 SL2T,助力聋人用户
这则消息的意义不仅在于技术突破,更在于AI开始真正关注边缘群体的需求。对开发者而言,SL2T的架构思路和技术路径值得深入研究;对无障碍倡导者来说,这是推动行业标准的重要案例。