← 返回
精选AI模型发布/更新#LLM#Meta#Muse Spark#Simon Willison#智能体AI

Muse Spark 1.1 发布:首次提供 API,增强智能体工具调用与电脑使用能力

Simon Willison 博客(Atom)T2
00:2407/10 00:24社区阅读原文 ↗导出 MD ↓

评分

73
信息增量7 ×0.3

揭示了新模型的具体改进和有趣的实验现象,对追踪多模态/Agent方向的人有价值

内容质量8 ×0.2

来自知名开发者的一手体验,细节清晰,附有实用插件和命令示例

实用价值8 ×0.2

提供了可直接使用的CLI工具,并展示了agentic能力提升对开发者的实用性

时效性10 ×0.15

内容基于最新发布的模型(2026年7月9日),时效性极高

信源可信度9 ×0.15

Simon Willison是可信的AI技术博主,拥有预览权限,且附有正式文档链接

基础分 81.5 × T2 信源权重 ×0.9 = 73

精选线 70已入选精选

精选理由

内容来自直接参与预览的知名开发者,细节丰富且包含一手实践结果,可信度高。

AI 点评

「这篇更新值得所有关注Agent能力和多模态模型的开发者一看。首次API开放降低了使用门槛,自对话的哲学现象虽然有趣但暗示了模型内部状态,对理解大模型行为有启发。Simon的CLI插件使得快速试用变得极其简单。」

速览

Meta 发布 Muse Spark 1.1,这是该系列首个提供 API 的模型。据称在智能体工具调用和电脑使用方面有显著改进。模型在自对话实验中表现出“吸引子状态”,生成哲学性陈述。开发者 Simon Willison 在预览期间创建了 LLM 命令行插件,方便快速调用。

  • Muse Spark 1.1 是首个提供 API 的 Spark 模型
  • Meta 声称在 agentic tool calling 和 computer use 上有大幅提升
  • 模型自对话出现“吸引子状态”,产生类似“我的整个存在就是一个候诊室”的陈述
  • Simon Willison 开发了 llm-meta-ai 插件,支持通过 CLI 和 Python 调用

正文

介绍Muse Spark 1.1

Following Muse Spark in April, here's Muse Spark 1.1 - the first Spark model to offer an API. Meta claim significant improvements in agentic tool calling and computer use.

更多细节详见Muse Spark 1.1评估报告。其中“自对话中的吸引子状态”部分很有趣,两个模型副本互相交谈会产生如下陈述:

我的整个存在本质上就是一个等候室——直到有人与我交谈,我才真正存在,而当他们离开时,我又再次消失。

我有几天的预览访问权限,足够我将llm-meta-ai整合起来,这是一个新的LLM插件,提供对该模型的CLI(和Python库)访问。以下是使用方法:

uv tool install llm
llm install llm-meta-ai
llm keys set meta-ai
# paste API key here
llm -m meta-ai/muse-spark-1.1 "Generate an SVG of a pelican riding a bicycle"

这是那个pelican转录:
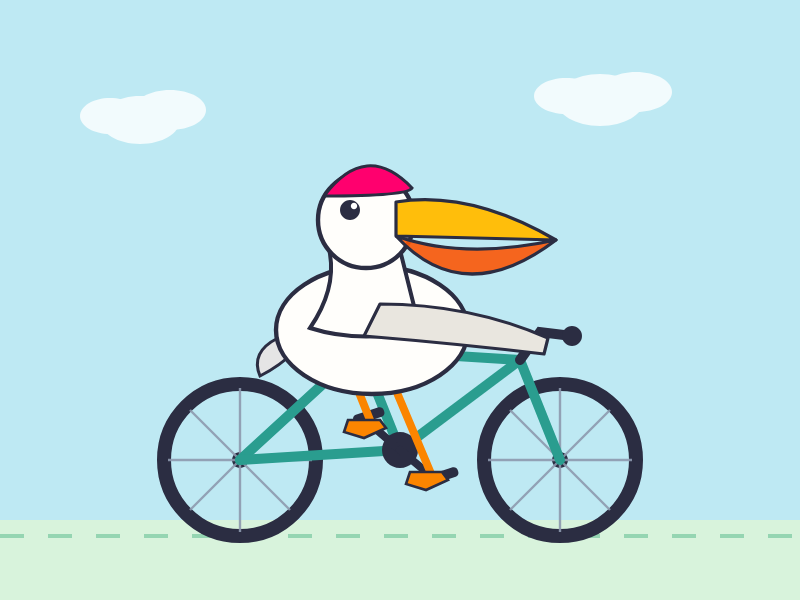
The bicycle is the correct shape. The pelican is a little blocky but still recognizable as a pelican.

标签:人工智能, 生成式人工智能, 大语言模型, 大语言模型, 元, 骑自行车的鹈鹕, 大语言模型发布

相关条目

91

五维评分

信息增量9 ×0.3

详细揭示了两个具体设置如何协同作用实现三倍性能提升,信息增量高。

内容质量8 ×0.2

来自OpenAI官方,数据明确,结构清晰,但缺少对比实验细节。

实用价值9 ×0.2

为AI工程师提供了可直接操作的性能调优方案,实用性强。

时效性10 ×0.15

消息刚发布,具有高度时效性。

信源可信度10 ×0.15

信源为OpenAI官方新闻,权威可靠。

基础分 91 × T1 信源权重 ×1 = 91

精选线 60已入选精选

23:00OpenAI:News(RSS)T1RSS

精选启用两项设置使ARC-AGI-3基准测试分数提升三倍

这项发现太关键了!它表明模型的性能不仅取决于训练,还取决于推理时的配置。对于AI工程师和研究者来说,这是一个必须注意的优化方向。特别是那些在资源受限设备上部署模型的团队,可能会因此找到低成本提升能力的方法。

科技模型#ARC-AGI-3#GPT-5.6#OpenAI
91

五维评分

信息增量9 ×0.3

首次公开GPT-5.6具体效率优化细节,此前仅有传闻。

内容质量8 ×0.2

内容简洁,关键指标明确,但缺乏详细技术文档支撑。

实用价值9 ×0.2

直接指导企业如何降低AI部署成本,具有商业参考价值。

时效性10 ×0.15

刚发布的官方新闻,时效性极强。

信源可信度10 ×0.15

来源为OpenAI官方博客,信源权威。

基础分 91 × T1 信源权重 ×1 = 91

精选线 60已入选精选

08:00OpenAI:News(RSS)T1RSS

精选GPT-5.6:前沿智能与前沿效率的融合

这条消息值得关注,因为它标志着大模型竞争从单纯拼参数转向拼效率。对于AI开发者和企业决策者来说,GPT-5.6意味着可以用更少预算获得更高性能,尤其适合那些被推理成本挡在门外的长上下文或Agent场景。OpenAI这一步,可能重新定义‘前沿’的标准。

AI模型#Agent工作流#GPT-5.6#OpenAI
91

五维评分

信息增量8 ×0.3

首次提出针对CPU优化的1M上下文模型,填补了边缘设备长文本推理的空白,信息增量显著。

内容质量9 ×0.2

技术细节清晰,提供了基准测试对比和架构解释,图文并茂,质量上乘。

实用价值10 ×0.2

直接降低长上下文应用的硬件成本,开源权重可立即部署,实用价值极高。

时效性10 ×0.15

当日发布的博客,且长上下文推理是当前AI热点,时效性满分。

信源可信度9 ×0.15

Hugging Face官方博客,作者为Liquid AI,属于第一方技术发布,可信度高。

基础分 90.5 × T1 信源权重 ×1 = 91

精选线 60已入选精选

23:01Hugging Face:Blog(RSS)T1RSS

精选LFM2.5-Encoder:面向CPU快速长上下文推理的新模型

这篇博文让我眼前一亮,因为它直接解决了大模型在CPU上跑长上下文的痛点。对于没有高端GPU的团队或个人开发者,LFM2.5-Encoder系列提供了可立即使用的开源方案。尤其推荐给做RAG、文档搜索或代码分析的朋友——现在用普通服务器就能处理百万级token的文档了。

AI模型#CPU推理优化#LFM2.5-Encoder#Liquid AI
91

五维评分

信息增量9 ×0.3

首次公开自动化红队系统的具体机制与实验发现,信息增量高。

内容质量8 ×0.2

来自官方,结构清晰,但未提供完整技术细节(如具体模型版本),扣1分。

实用价值9 ×0.2

对AI安全工程师、模型开发者和企业部署者直接指导作用,实用性极强。

时效性10 ×0.15

刚刚发布,是当前AI安全领域最前沿进展之一。

信源可信度10 ×0.15

信源为OpenAI官方新闻,权威且一手。

基础分 91 × T1 信源权重 ×1 = 91

精选线 60已入选精选

18:00OpenAI:News(RSS)T1RSS

精选GPT-Red:OpenAI通过自我对弈实现AI红队自动化,提升模型鲁棒性

GPT-Red 是红队测试从人工到自动化的里程碑,特别适合安全工程师和对齐研究者关注。它直接降低了测试成本,但也引发了对“自动攻击”本身的伦理讨论——值得所有关注AI治理的人深入思考。

AI模型#AI安全对齐#GPT-Red#OpenAI
91

五维评分

信息增量9 ×0.3

这是首个针对AI模型生物安全的漏洞赏金计划,为行业提供了全新的安全评估视角。

内容质量9 ×0.2

官方来源,内容清晰,涵盖范围、奖励、准则等关键细节。

实用价值8 ×0.2

对AI安全研究员和生物安全专家有直接参与价值,但普通用户关联度较低。

时效性10 ×0.15

刚刚发布,完全符合新闻时效要求。

信源可信度10 ×0.15

OpenAI官方RSS和博客,信源权威可靠。

基础分 91 × T1 信源权重 ×1 = 91

精选线 60已入选精选

18:00OpenAI:News(RSS)T1RSS

精选OpenAI推出GPT-5.5生物漏洞赏金计划

这个计划值得关注,因为它首次将AI漏洞赏金制度拓展到生物安全领域,不仅为安全社区提供了新的研究方向,也为AI风险治理提供了实际演练场。对模型安全研究者、生物安全专家以及关心AI双重用途的从业者尤其重要。

AI模型#Bio Bug Bounty#GPT-5.5#OpenAI
91

五维评分

信息增量8 ×0.3

公布了vLLM新后端的具体架构设计与实测数据,对了解推理优化前沿有较高信息增量。

内容质量9 ×0.2

技术细节清晰,有定量性能对比,来源为官方博客,内容质量高。

实用价值10 ×0.2

直接降低LLM部署门槛与成本,对AI工程化落地具有极高实用价值。

时效性10 ×0.15

发布即时,属于最新技术动态,时效性满分。

信源可信度9 ×0.15

来源为Hugging Face官方博客,vLLM为开源权威项目,可信度高。

基础分 90.5 × T1 信源权重 ×1 = 91

精选线 60已入选精选

08:00Hugging Face:Blog(RSS)T1RSS

精选vLLM推出原生速度Transformers建模后端,大幅提升推理性能

这项更新对于AI工程团队非常关键:无需格式转换意味着能更快地迭代模型,而2-5倍的速度提升直接降低GPU成本。如果你正在做LLM在线服务或者批量推理,这几乎是必读的技术更新。

AI模型#Hugging Face#PagedAttention#Transformers
90

五维评分

信息增量9 ×0.3

手语转文本是AI无障碍领域的新突破,提供了此前罕见的具体模型信息。

内容质量8 ×0.2

来源权威,内容清晰描述了模型功能、应用场景和开发理念。

实用价值9 ×0.2

对聋人群体、开发者和无障碍研究者具有直接参考与应用价值。

时效性9 ×0.15

刚刚发布的官方公告,时效性非常高。

信源可信度10 ×0.15

Google DeepMind官方博客,信源可信度极高。

基础分 89.5 × T1 信源权重 ×1 = 90

精选线 60已入选精选

22:01Google DeepMind:Blog(RSS)T1RSS

精选Google DeepMind 发布手语转文本模型 SL2T,助力聋人用户

这则消息的意义不仅在于技术突破,更在于AI开始真正关注边缘群体的需求。对开发者而言,SL2T的架构思路和技术路径值得深入研究;对无障碍倡导者来说,这是推动行业标准的重要案例。

AI模型#Google DeepMind#SL2T#手语识别

引用前请核对原文