← 返回
精选AI模型发布/更新#AI模型评测#Claude Sonnet 5#Gemini 3.5 Flash#GLM-5.2#GPT-5.6 Terra#图像生成

AI实验室是否在刻意训练“骑自行车的鹈鹕”?一项严谨评测给出否定答案

Simon Willison 博客(Atom)T2
07:0107/23 07:01社区阅读原文 ↗导出 MD ↓

评分

75
信息增量8 ×0.3

针对广泛流传的都市传说提供了首次系统化、可复现的证据,颠覆了社区对模型训练偏向的普遍猜测。

内容质量9 ×0.2

方法设计严谨(多因素、重复、辅助评估),数据公开,结论统计清晰,文本表述专业且易读。

实用价值7 ×0.2

对模型评测社区提供了可复用的流程思路,但对普通用户直接使用价值有限。

时效性9 ×0.15

2026年7月22日刚发布,紧跟当前关于模型训练数据污染的讨论热点。

信源可信度9 ×0.15

来源为Simon Willison博客(知名AI观察者),实验由独立研究者Dylan Castillo完成,方法透明。

基础分 83 × T2 信源权重 ×0.9 = 75

精选线 70已入选精选

精选理由

实验设计完整、数据透明、结论有统计支撑,对理解模型训练偏向性具有较高参考价值。

AI 点评

「这篇研究完美诠释了如何用科学方法回应一个有趣的网络梗。对于AI评测者、模型训练工程师和关注数据污染的读者来说,这是一份难得的范例:它用详实的数据证明,尽管社区玩笑式地猜测模型存在“鹈鹕骑自行车”训练偏向,但实际评测并不支持。值得留意的是,该实验设计(多因素交叉+独立评估者)本身就可以被复用至其他类似怀疑的验证中。」

速览

Dylan Castillo 对“AI 实验室是否故意训练模型绘制骑自行车的鹈鹕”这一流传甚广的梗进行了系统评测。选取 8 种动物 × 6 种交通工具共 48 条提示词,在 7 个主流模型(GPT-5.6 Terra、Claude Sonnet 5、Gemini 3.5 Flash、Grok 4.5、Qwen3.7-Max、GLM-5.2、DeepSeek V4 Pro)上各运行 3 次,并使用 GPT-5.6 Luna 和 Gemini 3.1 Flash-Lite 辅助评估。结果未发现任何模型在“鹈鹕骑自行车”组合上表现显著优于其个体能力,驳斥了“pelicanmaxxing”传言。

  • Castillo 使用 48 种提示词组合(8 动物 × 6 交通工具),在 7 个模型上重复 3 次,构建了 1000 余张图像的测试集。
  • 通过辅助模型(GPT-5.6 Luna、Gemini 3.1 Flash-Lite)对生成结果进行客观评估,避免了主观偏差。
  • 主要结论:没有实验室在“鹈鹕骑自行车”上的表现显著优于其绘制鹈鹕和自行车的基础能力,不支持“pelicanmaxxing”假说。
  • GLM-5.2 在个别样本上略有提升,但统计上不显著,不足以证明刻意训练。

正文

AI实验室在搞鹈鹕最大化吗?

Excellent piece of work by Dylan Castillo, who took a deep-dive into the frequently pondered question of whether the AI labs have been deliberately training models to draw pelicans riding bicycles in response to my deeply unscientific benchmark.

我过去曾随机抽查过这一点,测试模型对其他动物骑其他类型车辆的生成情况,但从未像Dylan这里的方法那样严谨。

Dylan采用了8种动物×6种车辆=48个提示词,每个提示词在7个不同模型(GPT-5.6 Terra, Claude Sonnet 5, Gemini 3.5 Flash, Grok 4.5, Qwen3.7-Max, GLM-5.2, and DeepSeek V4 Pro)上各运行三次。然后他使用GPT-5.6 Luna和Gemini 3.1 Flash-Lite来帮助评估结果。

有一个简洁的筛选视图可用于探索结果:
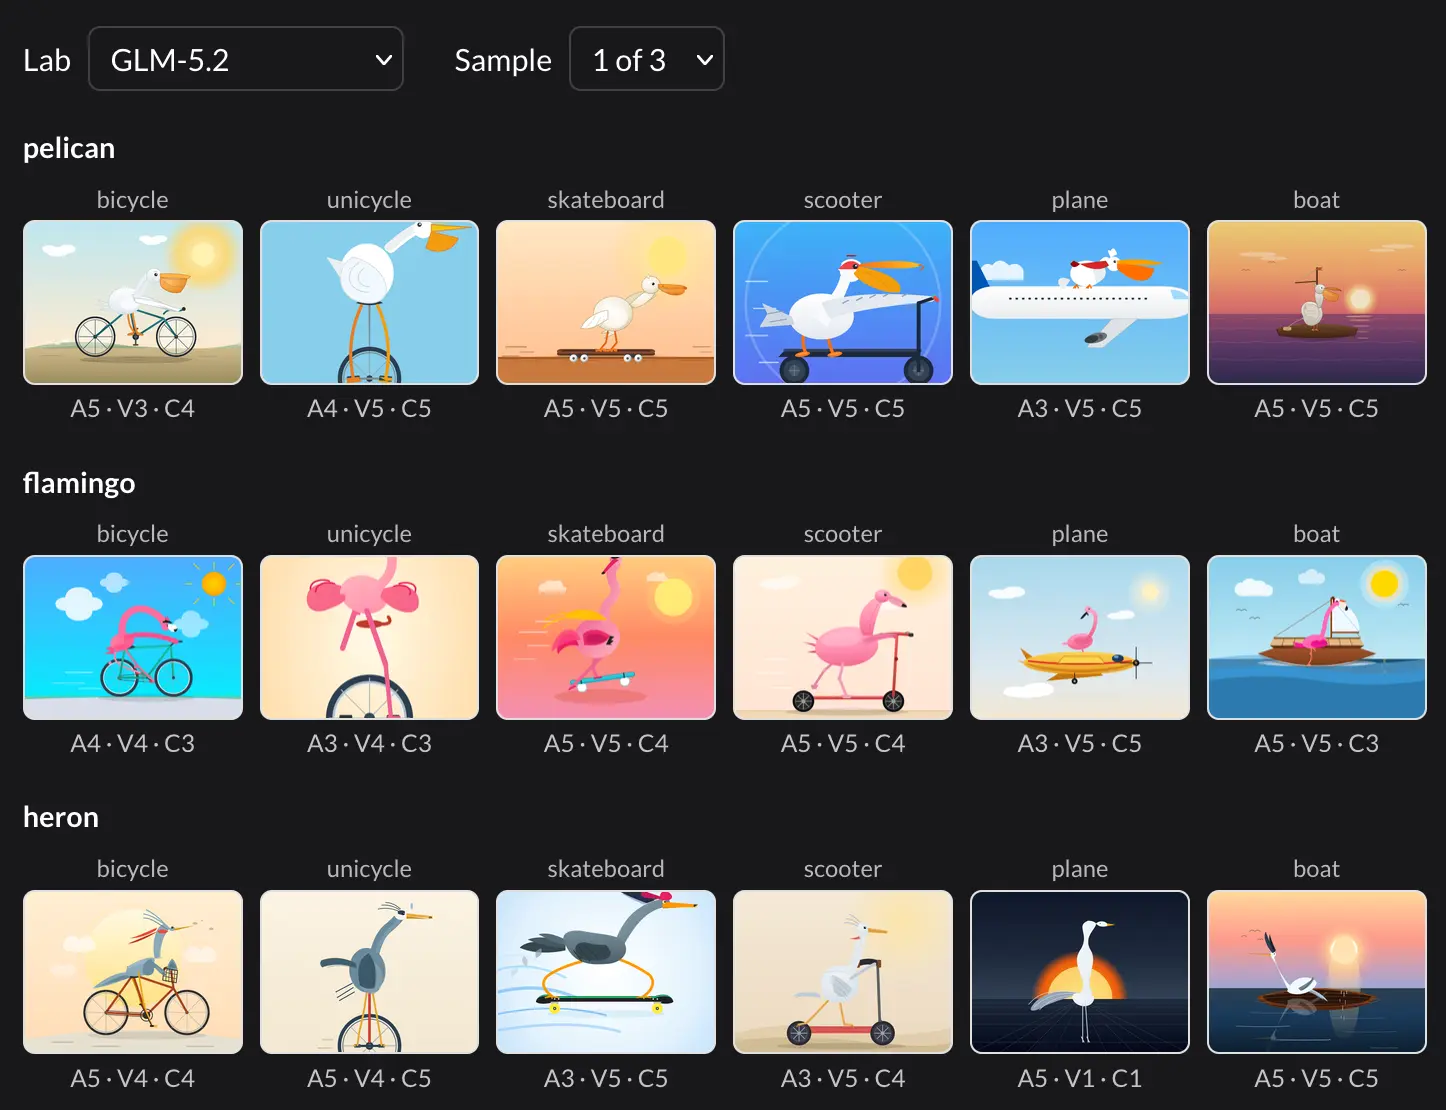
Screenshot of a grid for sample 1/3 of GLM-5.2, with pelicn and flamingo and heron riding bicycle, unicycle, skateboard, scooter, plane and boat

对于他测试的模型,他没有发现pelimaxxing的证据:

骑自行车的鹈鹕看起来并不更好 实验室并不更擅长画鹈鹕 实验室并不更擅长画自行车 实验室并不更擅长画骑自行车的鹈鹕,即使调整难度 鹈鹕-自行车场景看起来并不像是被记住的 [...] 鹈鹕并不比其他动物画得更好。自行车并不比其他车辆画得更好。而且,没有实验室能画出比其鹈鹕和自行车本身预测组合更好的组合。GLM-5.2最接近:它在鹈鹕-自行车组合上提升最大,而且它的第一个鹈鹕骑自行车样本引起了我的注意。但效果很小且不显著,所以我不应该过分看重它。

来自 Hacker News

标签: ai, generative-ai, llms, evals, pelican-riding-a-bicycle

相关条目

91

五维评分

信息增量9 ×0.3

详细揭示了两个具体设置如何协同作用实现三倍性能提升,信息增量高。

内容质量8 ×0.2

来自OpenAI官方,数据明确,结构清晰,但缺少对比实验细节。

实用价值9 ×0.2

为AI工程师提供了可直接操作的性能调优方案,实用性强。

时效性10 ×0.15

消息刚发布,具有高度时效性。

信源可信度10 ×0.15

信源为OpenAI官方新闻,权威可靠。

基础分 91 × T1 信源权重 ×1 = 91

精选线 60已入选精选

23:00OpenAI:News(RSS)T1RSS

精选启用两项设置使ARC-AGI-3基准测试分数提升三倍

这项发现太关键了!它表明模型的性能不仅取决于训练,还取决于推理时的配置。对于AI工程师和研究者来说,这是一个必须注意的优化方向。特别是那些在资源受限设备上部署模型的团队,可能会因此找到低成本提升能力的方法。

科技模型#ARC-AGI-3#GPT-5.6#OpenAI
91

五维评分

信息增量9 ×0.3

首次公开GPT-5.6具体效率优化细节,此前仅有传闻。

内容质量8 ×0.2

内容简洁,关键指标明确,但缺乏详细技术文档支撑。

实用价值9 ×0.2

直接指导企业如何降低AI部署成本,具有商业参考价值。

时效性10 ×0.15

刚发布的官方新闻,时效性极强。

信源可信度10 ×0.15

来源为OpenAI官方博客,信源权威。

基础分 91 × T1 信源权重 ×1 = 91

精选线 60已入选精选

08:00OpenAI:News(RSS)T1RSS

精选GPT-5.6:前沿智能与前沿效率的融合

这条消息值得关注,因为它标志着大模型竞争从单纯拼参数转向拼效率。对于AI开发者和企业决策者来说,GPT-5.6意味着可以用更少预算获得更高性能,尤其适合那些被推理成本挡在门外的长上下文或Agent场景。OpenAI这一步,可能重新定义‘前沿’的标准。

AI模型#Agent工作流#GPT-5.6#OpenAI
91

五维评分

信息增量8 ×0.3

首次提出针对CPU优化的1M上下文模型,填补了边缘设备长文本推理的空白,信息增量显著。

内容质量9 ×0.2

技术细节清晰,提供了基准测试对比和架构解释,图文并茂,质量上乘。

实用价值10 ×0.2

直接降低长上下文应用的硬件成本,开源权重可立即部署,实用价值极高。

时效性10 ×0.15

当日发布的博客,且长上下文推理是当前AI热点,时效性满分。

信源可信度9 ×0.15

Hugging Face官方博客,作者为Liquid AI,属于第一方技术发布,可信度高。

基础分 90.5 × T1 信源权重 ×1 = 91

精选线 60已入选精选

23:01Hugging Face:Blog(RSS)T1RSS

精选LFM2.5-Encoder:面向CPU快速长上下文推理的新模型

这篇博文让我眼前一亮,因为它直接解决了大模型在CPU上跑长上下文的痛点。对于没有高端GPU的团队或个人开发者,LFM2.5-Encoder系列提供了可立即使用的开源方案。尤其推荐给做RAG、文档搜索或代码分析的朋友——现在用普通服务器就能处理百万级token的文档了。

AI模型#CPU推理优化#LFM2.5-Encoder#Liquid AI
91

五维评分

信息增量9 ×0.3

首次公开自动化红队系统的具体机制与实验发现,信息增量高。

内容质量8 ×0.2

来自官方,结构清晰,但未提供完整技术细节(如具体模型版本),扣1分。

实用价值9 ×0.2

对AI安全工程师、模型开发者和企业部署者直接指导作用,实用性极强。

时效性10 ×0.15

刚刚发布,是当前AI安全领域最前沿进展之一。

信源可信度10 ×0.15

信源为OpenAI官方新闻,权威且一手。

基础分 91 × T1 信源权重 ×1 = 91

精选线 60已入选精选

18:00OpenAI:News(RSS)T1RSS

精选GPT-Red:OpenAI通过自我对弈实现AI红队自动化,提升模型鲁棒性

GPT-Red 是红队测试从人工到自动化的里程碑,特别适合安全工程师和对齐研究者关注。它直接降低了测试成本,但也引发了对“自动攻击”本身的伦理讨论——值得所有关注AI治理的人深入思考。

AI模型#AI安全对齐#GPT-Red#OpenAI
91

五维评分

信息增量9 ×0.3

这是首个针对AI模型生物安全的漏洞赏金计划,为行业提供了全新的安全评估视角。

内容质量9 ×0.2

官方来源,内容清晰,涵盖范围、奖励、准则等关键细节。

实用价值8 ×0.2

对AI安全研究员和生物安全专家有直接参与价值,但普通用户关联度较低。

时效性10 ×0.15

刚刚发布,完全符合新闻时效要求。

信源可信度10 ×0.15

OpenAI官方RSS和博客,信源权威可靠。

基础分 91 × T1 信源权重 ×1 = 91

精选线 60已入选精选

18:00OpenAI:News(RSS)T1RSS

精选OpenAI推出GPT-5.5生物漏洞赏金计划

这个计划值得关注,因为它首次将AI漏洞赏金制度拓展到生物安全领域,不仅为安全社区提供了新的研究方向,也为AI风险治理提供了实际演练场。对模型安全研究者、生物安全专家以及关心AI双重用途的从业者尤其重要。

AI模型#Bio Bug Bounty#GPT-5.5#OpenAI
91

五维评分

信息增量8 ×0.3

公布了vLLM新后端的具体架构设计与实测数据,对了解推理优化前沿有较高信息增量。

内容质量9 ×0.2

技术细节清晰,有定量性能对比,来源为官方博客,内容质量高。

实用价值10 ×0.2

直接降低LLM部署门槛与成本,对AI工程化落地具有极高实用价值。

时效性10 ×0.15

发布即时,属于最新技术动态,时效性满分。

信源可信度9 ×0.15

来源为Hugging Face官方博客,vLLM为开源权威项目,可信度高。

基础分 90.5 × T1 信源权重 ×1 = 91

精选线 60已入选精选

08:00Hugging Face:Blog(RSS)T1RSS

精选vLLM推出原生速度Transformers建模后端,大幅提升推理性能

这项更新对于AI工程团队非常关键:无需格式转换意味着能更快地迭代模型,而2-5倍的速度提升直接降低GPU成本。如果你正在做LLM在线服务或者批量推理,这几乎是必读的技术更新。

AI模型#Hugging Face#PagedAttention#Transformers
90

五维评分

信息增量9 ×0.3

手语转文本是AI无障碍领域的新突破,提供了此前罕见的具体模型信息。

内容质量8 ×0.2

来源权威,内容清晰描述了模型功能、应用场景和开发理念。

实用价值9 ×0.2

对聋人群体、开发者和无障碍研究者具有直接参考与应用价值。

时效性9 ×0.15

刚刚发布的官方公告,时效性非常高。

信源可信度10 ×0.15

Google DeepMind官方博客,信源可信度极高。

基础分 89.5 × T1 信源权重 ×1 = 90

精选线 60已入选精选

22:01Google DeepMind:Blog(RSS)T1RSS

精选Google DeepMind 发布手语转文本模型 SL2T,助力聋人用户

这则消息的意义不仅在于技术突破,更在于AI开始真正关注边缘群体的需求。对开发者而言,SL2T的架构思路和技术路径值得深入研究;对无障碍倡导者来说,这是推动行业标准的重要案例。

AI模型#Google DeepMind#SL2T#手语识别

引用前请核对原文