Claude Science:面向科学家的AI工作台
评分
67精选理由
产品定位精准,针对科研痛点,结合AI能力提升效率,但尚需观察实际应用效果。
AI 点评
「Claude Science通过AI专为科学家设计,可能极大简化数据分析与实验工作流,推动科研效率变革。」
速览
Anthropic推出Claude Science,一个专为科学家定制的AI工作台。它集成了研究人员常用的工具和包,生成可审计的工件,并提供灵活的计算资源访问,旨在加速科学发现和实验分析。
- 可定制化集成科学家常用工具与软件包
- 生成可审计的工件,提升研究透明度与可复现性
- 提供灵活的计算资源访问,支持不同规模实验
正文
Claude Science(面向科学家的 AI 工作台)现已推出
Jun 30, 2026Get started with Claude Science
AI 有潜力大幅加速科学发现和医疗干预措施的开发。自去年秋季我们在生命科学领域启动相关努力以来,我们一直致力于提升模型能力,通过 MCP 和技能与科学生态系统建立连接,并启动合作项目以发挥这一潜力。
今天,我们推出这些努力中最重要的一次扩展:Claude Science,一个面向科学家的 AI 工作台。Claude Science 是一款集成研究人员最常用工具和软件包、生成可审计成果物并提供灵活计算资源访问的应用。
介绍 Claude Science
科学研究往往繁琐。研究人员必须处理数十个数据库,每个都有不同的模式,应对需要定制数据管道和查看器的文件格式,并在各种工具之间切换:PubMed、Jupyter、R、集群终端等。
Claude Science 将这些碎片化的工具整合到一个统一的研究环境中,科学家可以在其中完成工作各个阶段。它帮助你分析文献、执行多步骤研究、生成详细的成果物,并让你迭代优化图表和手稿直至可发表。每个输出都带有可审计的制作历史,因此你可以验证和复现结果。就像 Jupyter Notebook 一样,你可以在现有的工作环境中访问 Claude Science——本地 macOS 或 Linux,或者通过 SSH 或 HPC 登录节点访问远程机器。
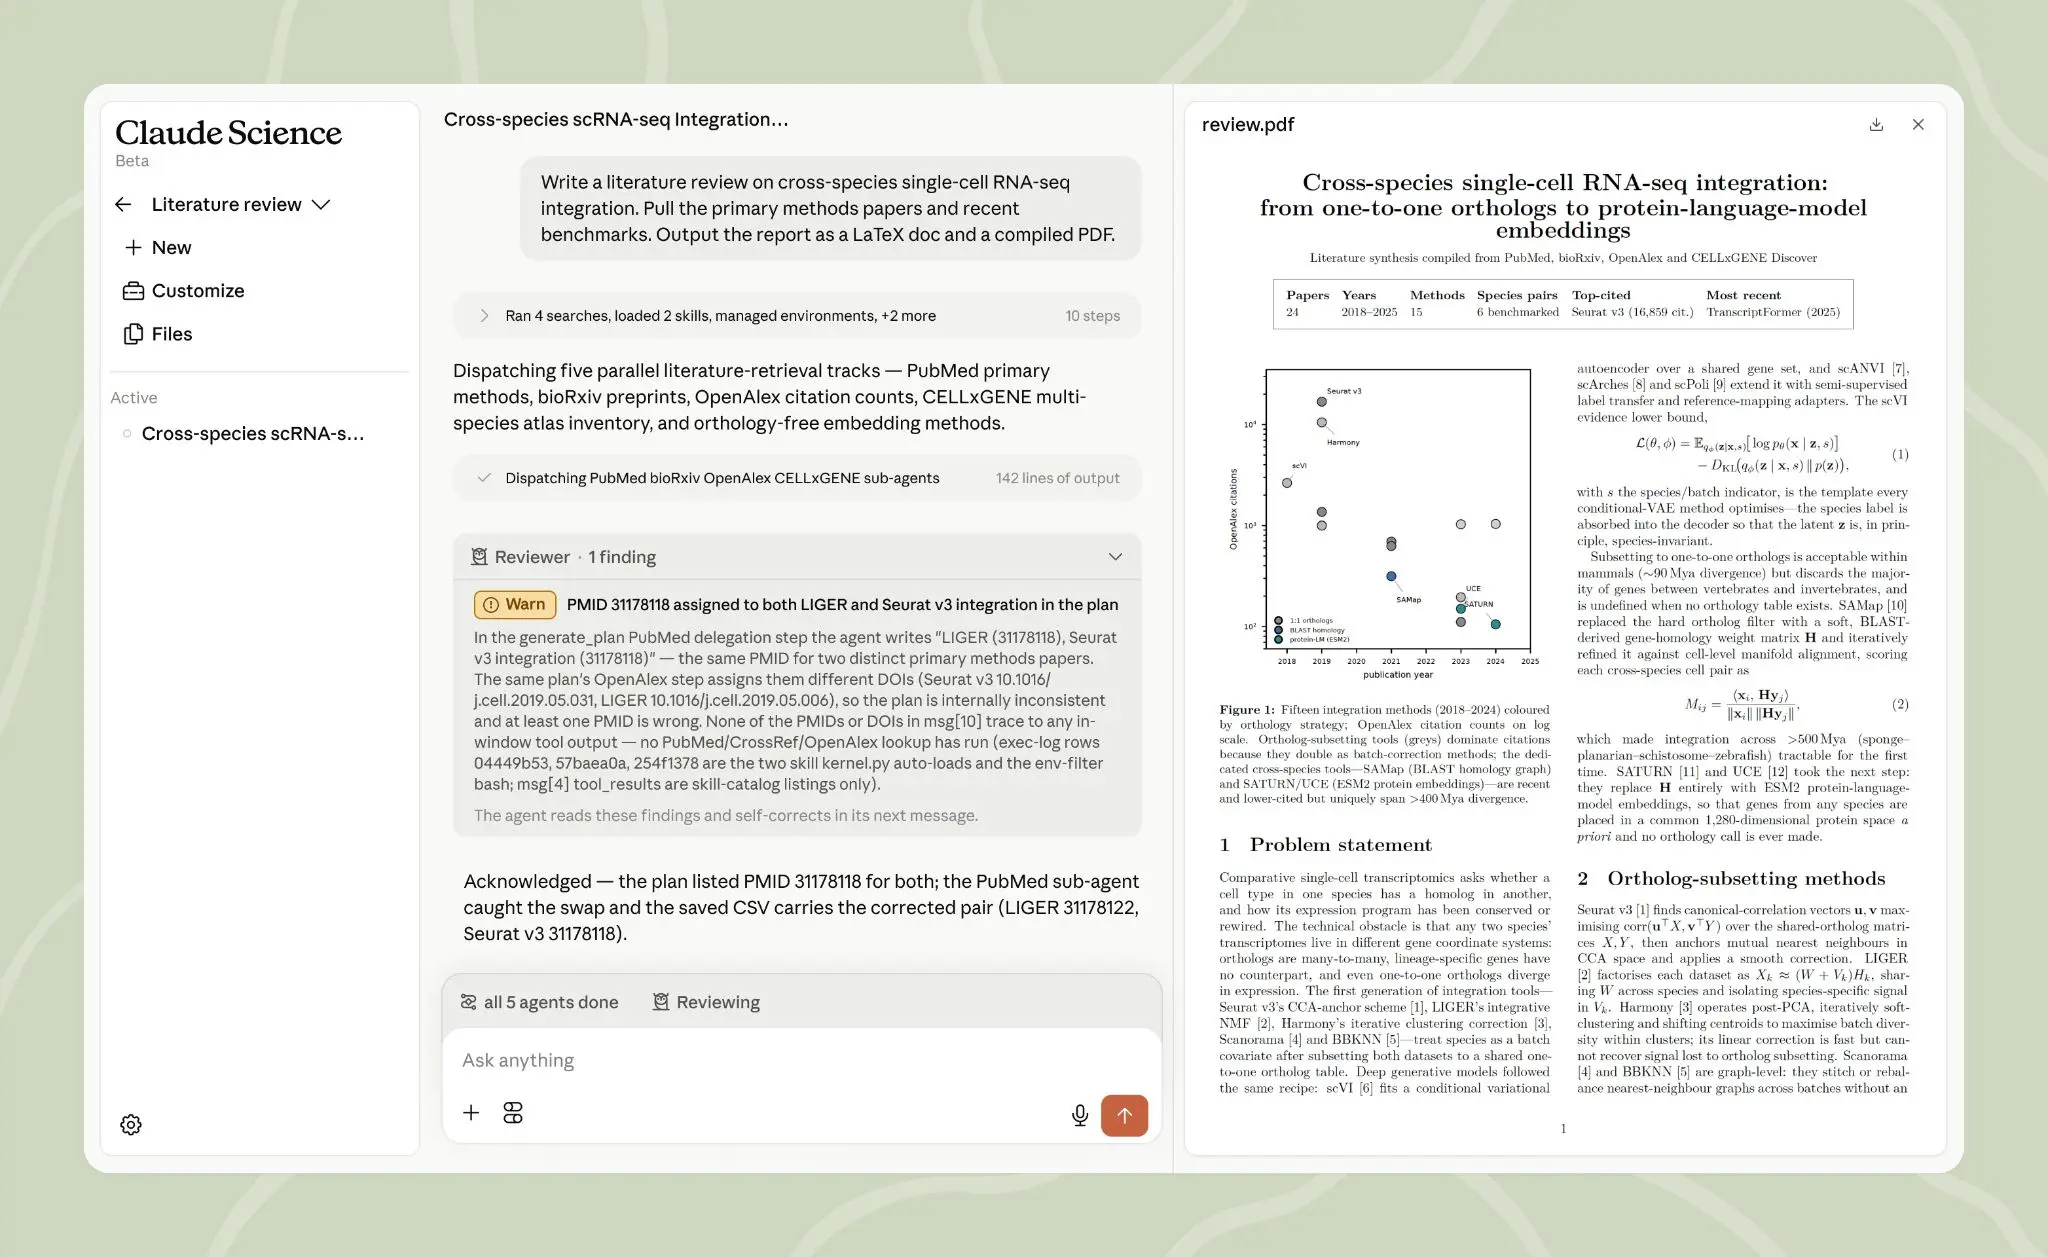
用户与一个通用协调智能体交互,该智能体可访问超过 60 种针对基因组学、单细胞、蛋白质组学、结构生物学、化学信息学等预配置的技能和连接器。这些智能体可以启动其他智能体,并调用用户创建的专用智能体。还有一个审查智能体检查引用和计算,标记并纠正错误。
我们今天以测试版形式向 Claude Pro、Max、Team 和 Enterprise 用户发布 Claude Science,并将在收集用户反馈后持续优化平台。
工作原理
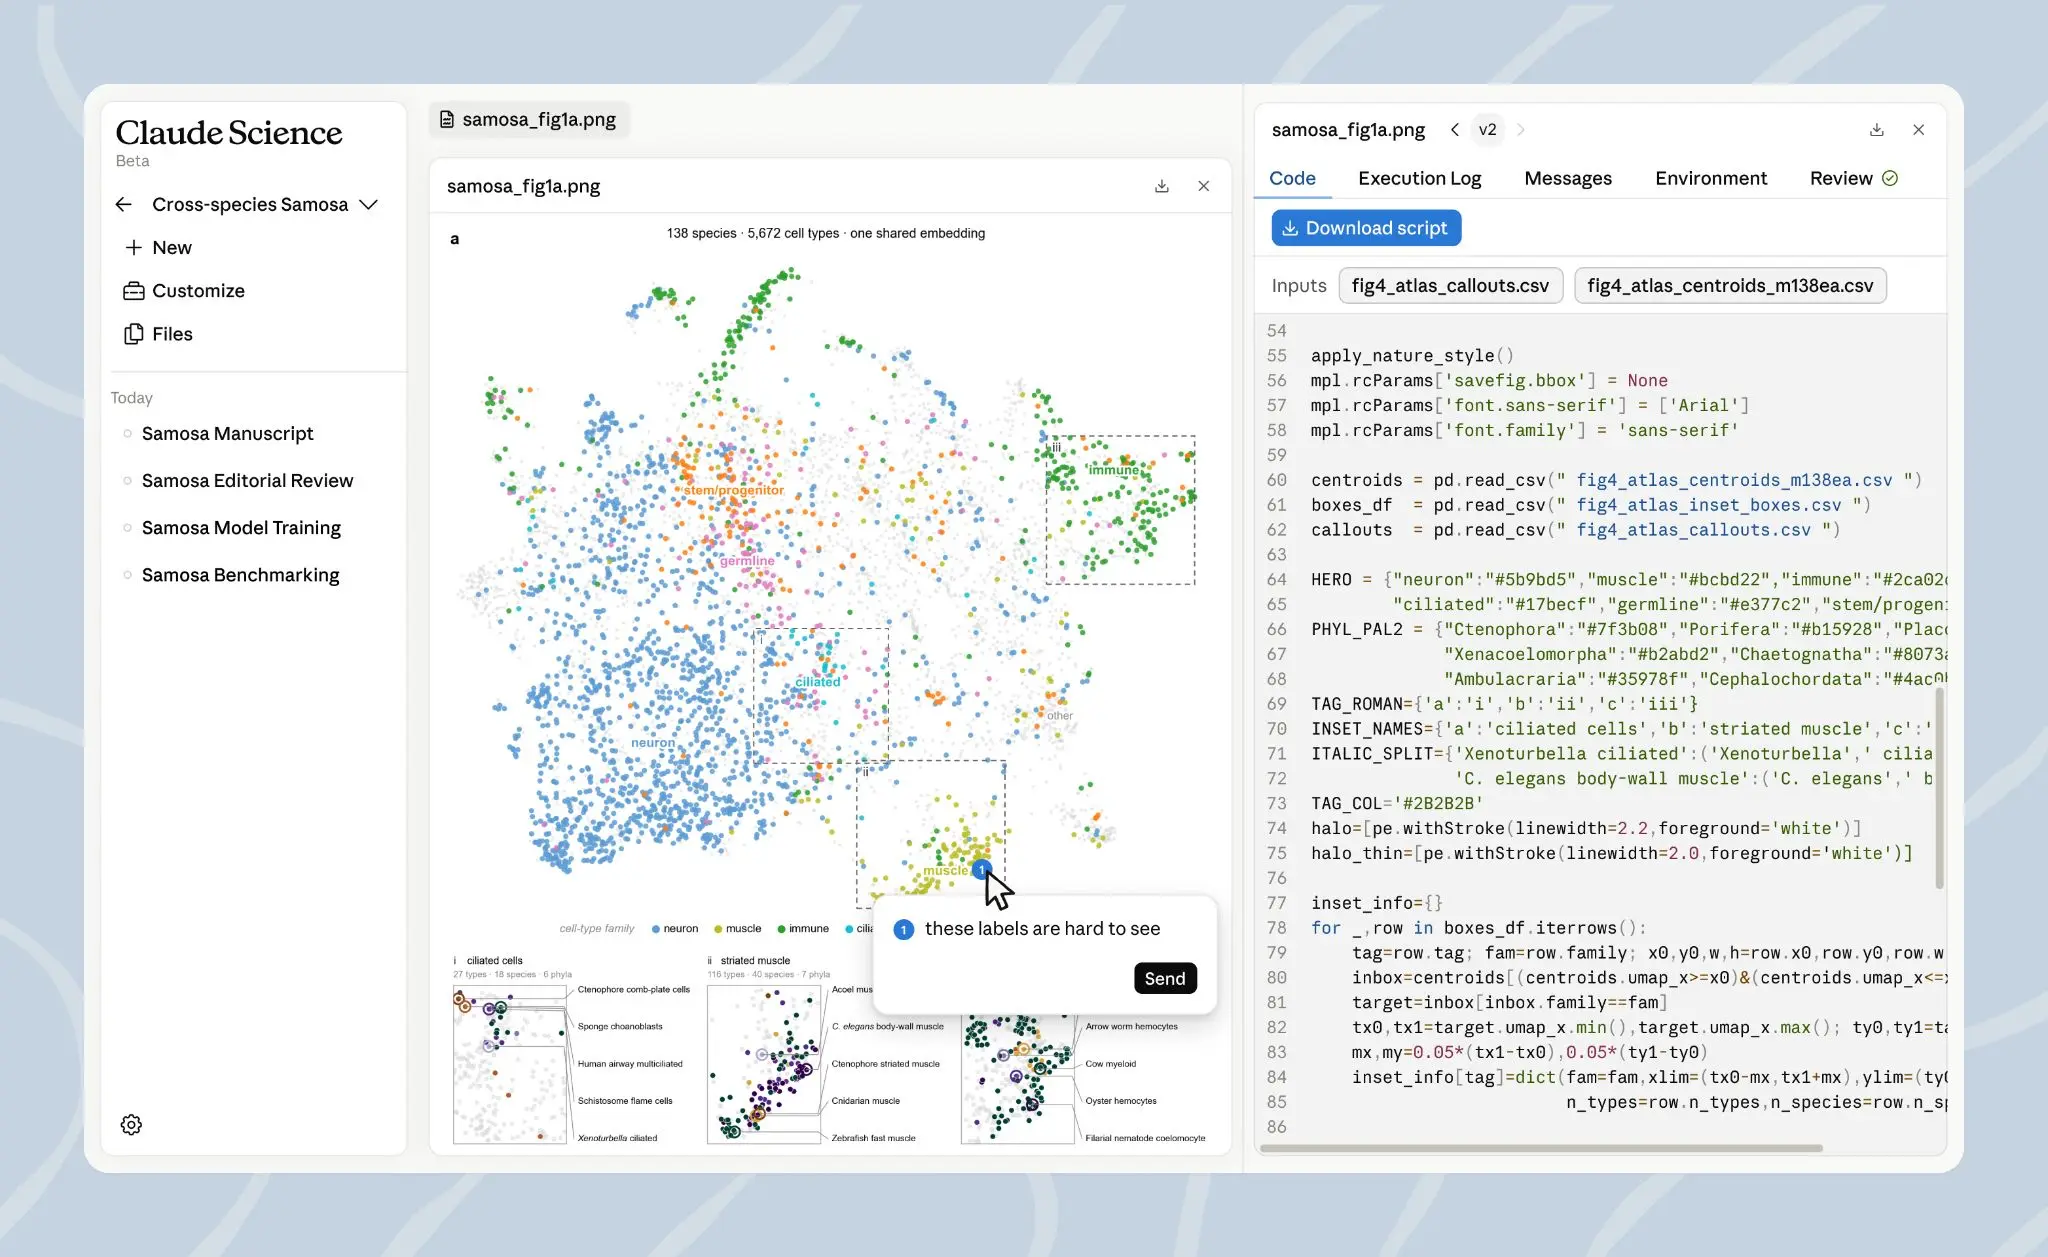
丰富的科学成果物,完全可复现。科学研究本质上具有视觉性,因此 Claude Science 在生成图表和手稿的同时也生成创建它们的代码。它原生渲染丰富的科学成果物,包括 3D 蛋白质结构、基因组浏览器轨道、化学结构等。你可以与智能体就任何细节进行对话,内联标注图表和手稿,让智能体知道需要处理哪些内容以使其达到发表标准。
当生成图表时,Claude Science 包含生成该图表的精确代码和环境、用通俗语言描述其创建方式的说明以及完整的消息历史。这让你了解输入,使工作即使在数月后也更容易验证和复现。你可以用通俗语言要求 Claude Science 修改图表——例如去除网格线,或将坐标轴改为对数刻度——智能体会编辑自己的代码。
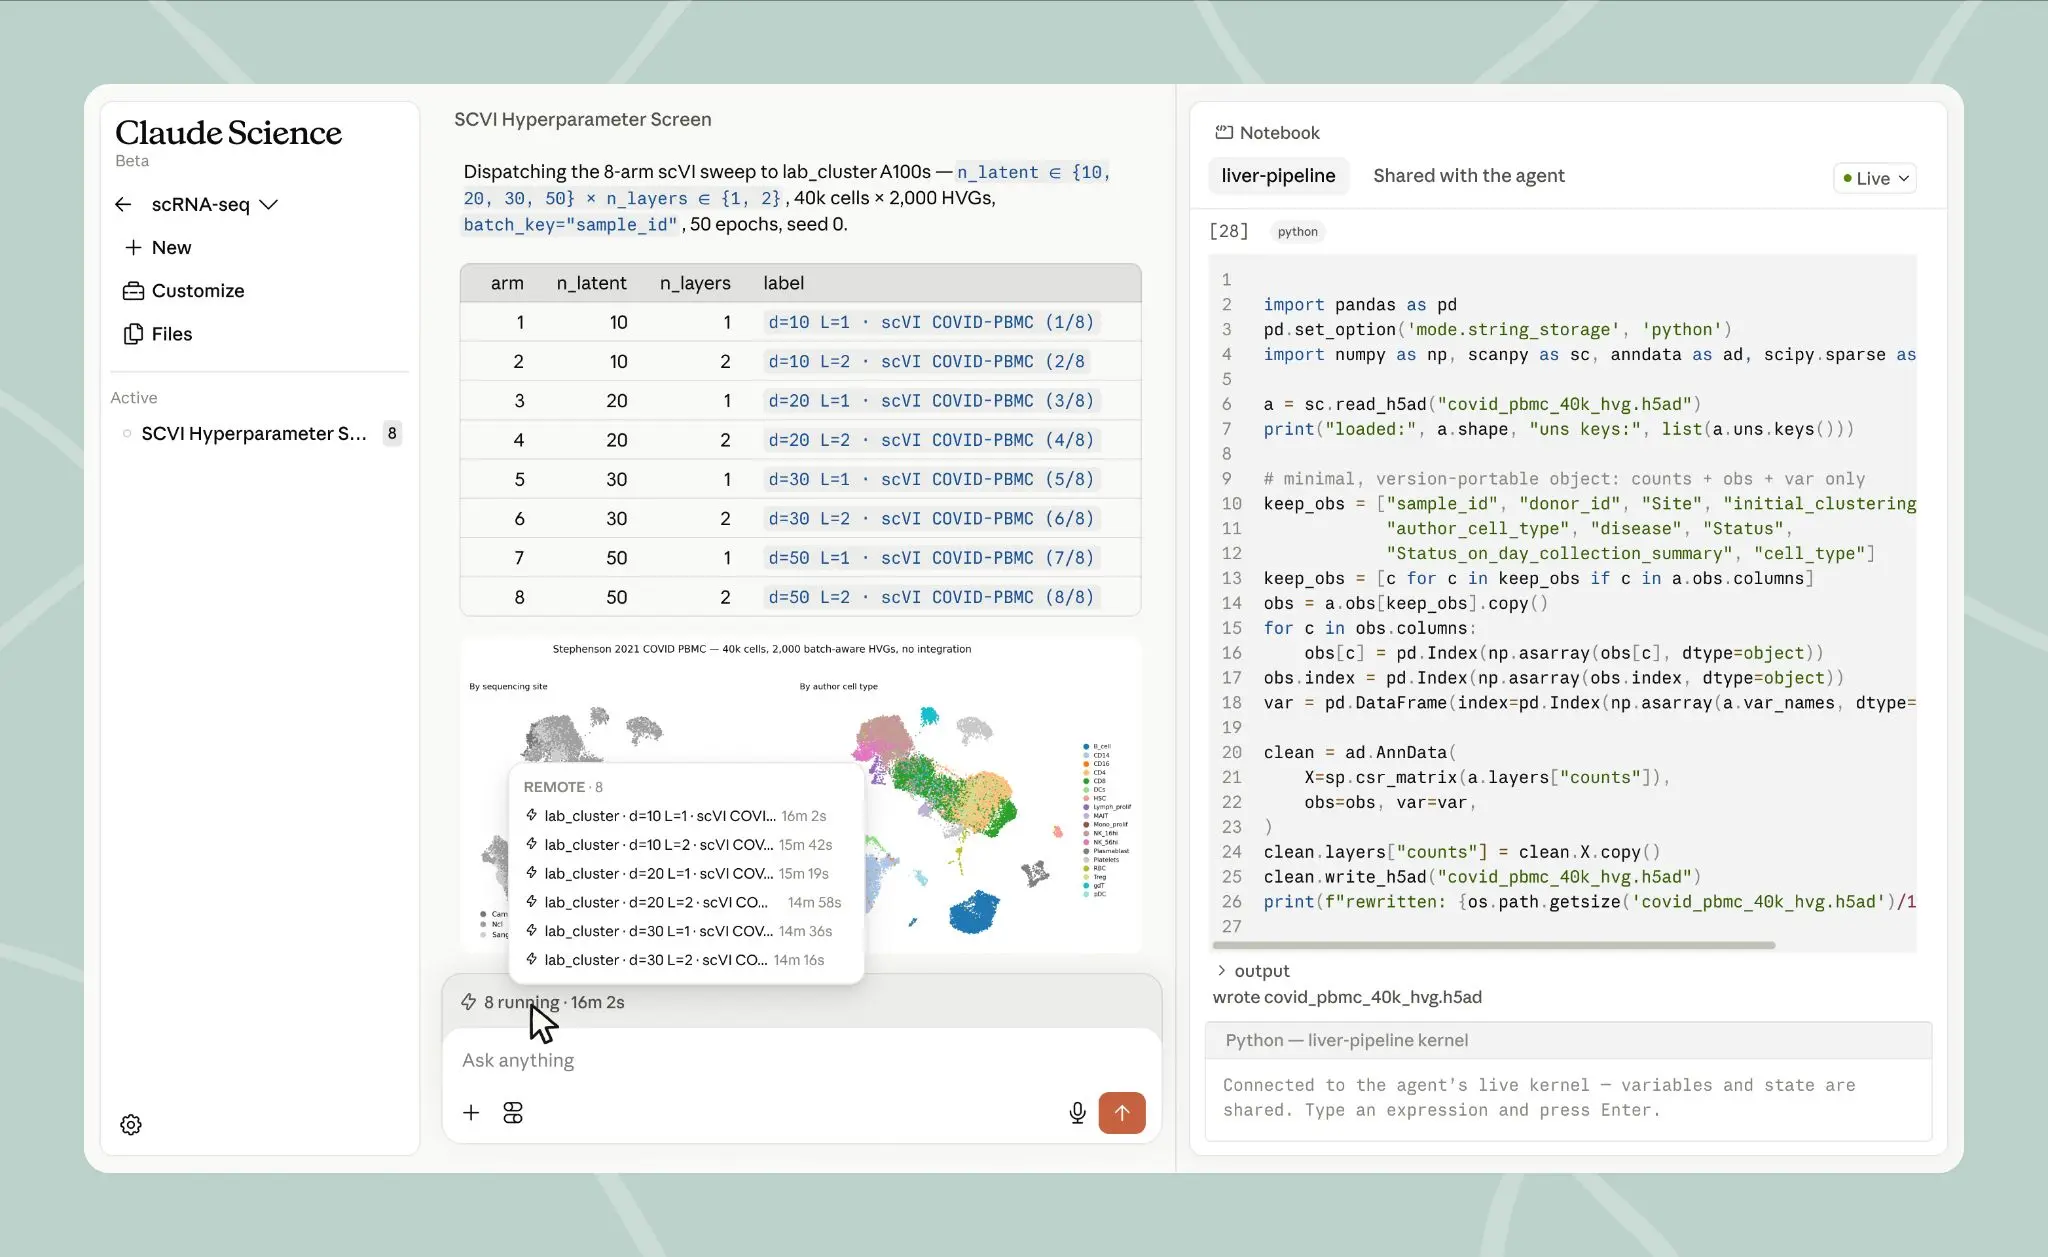
管理您的计算资源并按需扩展。大规模分析——例如蛋白质折叠,或对海量数据集运行基因组学管线——往往要求研究人员将注意力转移到设置计算任务、等待任务发送到集群、检查任务成功或失败、并拉取结果上。Claude Science 为您处理这一流程。它会制定计划,在访问新资源前征询您的意见,并在编写并将任务提交给您实验室已有的计算资源(通过 SSH 连接您自己的 HPC 集群,或通过您的 Modal 账户获取按需计算)之前,让您审查或撤销任何决策,从而将分析从单块 GPU 扩展到数百块。
由于它的智能体在一个持续运行的会话中工作,该会话将上下文保存在内存中,因此即使是海量数据集也只需加载一次。它在您实验室自有基础设施上运行——您的笔记本电脑、Linux 机器或 HPC 登录节点——因此大型或敏感数据集无需离开它们所在的系统,只有分析每一步所需的上下文才会发送给 Claude。随着管线的运行,一个审查智能体会检查输出,标记错误的引用、无法追溯的数字以及与底层代码不匹配的图表,并在过程中自我修正。您可以随时分叉会话以比较两种方法,而不丢失原始线程。
从第一天起就具备领域就绪能力。科学知识分散在数百个专业源中。例如,在生物学中,相关数据可能分布在 UniProt、PDB、Ensembl、Reactome、ClinVar、ChEMBL、GEO 等资源中——每个都有自己的模式和查询语言——以及期刊、预印本服务器和领域特定的开放模型中。当您用自然语言向 Claude Science 提问时,专业智能体会查询并综合所有这些来源,这样您就不必逐一导航。Claude Science 利用 NVIDIA BioNeMo 智能体工具包中的技能,原生连接 BioNeMo 中的生命科学模型和库,包括 Evo 2、Boltz-2 和 OpenFold3。
科学家已经拥有他们信赖的模型、数据集和管线。Claude Science 也可以连接到这些,将任何管线保存为可重用的技能,或通过连接器访问您实验室偏好的工具,未来会话将自动继承它们。这种可定制性使得您可以在一次对话中访问 Claude、您的专有数据以及您已经依赖的经过验证的工具。Claude Science 受益于我们合作伙伴的专业知识和平台,同时更多科学家通过 Claude 使用他们的工具。
科学家们正在用 Claude Science 做什么
在过去的几个月里,研究人员已经以测试版的形式使用 Claude Science 完成了诸如单细胞 RNA 测序分析、CRISPR 筛选设计、蛋白质结构预测、化学信息学等任务。
Manifold Bio 设计组织靶向药物——这类药物能够归巢到特定器官或细胞类型,从而在需要的部位发挥作用,并避免影响身体其他部分——并同时测试数百万个对应数百个靶点的候选结合剂在活体内的分布情况。Manifold 使用 Claude Science 为其最新实验提名靶点。针对每个组织和靶点,Claude Science 评估了表面表达、运输和安全性,并根据 Manifold 从其内部专有数据中学习到的标准对候选物进行排序。Manifold 表示,Claude Science 与通用编码助手的不同之处在于,它能够端到端地完成这一过程,收集正确的数据,并利用内嵌的过去程序上下文应用正确的判断。
艾伦研究所的神经科学家杰罗姆·勒科克使用Claude Science构建了一个多智能体“计算审阅模板”,包含约20项专为撰写长篇综述定制的技能。子智能体通读数千篇论文,提取核心主张和关键定量发现,并将其存储在证据状态数据库中。然后,管道构建叙事弧线,逐节撰写综述,并将每节委托给其专门子智能体。在每节中,专用智能体直接从证据数据库生成定量跨研究图表。该工作流程的一个关键组件(由Claude Science实现)是使用角色-评论员对:一个智能体创建内容,另一个独立的审阅智能体评估其准确性和引用忠实度。
在Claude Science之前,勒科克的团队可能需要花费两年时间才能撰写这样一篇综述。他现在大约有10篇综述,许多超过100页,其中的引用由审阅智能体检查过。该团队现在正与领域专家合作,进一步完善基于人工智能的评论智能体。
加州大学旧金山分校脑肿瘤中心的副教授兼流行病学家斯蒂芬·弗朗西斯使用Claude Science支持关于胶质瘤分子流行病学的研究,胶质瘤是一种始于脑胶质细胞的原发性肿瘤。他的实验室研究成千上万个具有小效应的种系变异如何结合形成个体易感性的遗传基础。尽管这项工作早于Claude Science,但弗朗西斯表示,该应用程序极大地加速了分析,使得能够在以前大约十分之一的时间内通过多种方法进行全面的种系检查。他的团队独立验证了Claude Science的结果,确认其可以产生快速且 robust 的分析。
开始使用Claude Science
Claude Science应用程序目前以测试版形式在macOS和Linux上提供给Pro、Max、Team和Enterprise计划的用户。我们提前分享它,以便科学家能够开始将其用于实际问题,并告诉我们如何改进。
Team和Enterprise用户需要其管理员启用Claude Science。我们现在有一个Team计划,为学术机构和非营利研究机构的活跃科学实验室提供折扣席位;在此了解更多信息。
我们还将支持多达50个Claude Science AI for Science项目,提供高达30,000美元的积分。Modal也将为选定的项目提供高达2,000美元的计算资源。我们正在寻找跨领域、探索科学边界的项目,早期重点放在生物学和生物医学研究上。申请截止到2026年7月15日,获奖通知将在7月31日前发出。项目运行时间为2026年9月1日至12月1日——在此申请。
要了解最新的产品公告、提供反馈并向Claude Science社区其他人学习,请加入AI for Science Discourse社区。
在claude.com/science上开始使用Claude Science。
相关内容
关于Fable 5网络安全防护和越狱框架的更多细节
Read more介绍Claude Sonnet 5
Sonnet 5在编码、智能体和规模化专业工作方面提供了前沿性能。
Read more重新部署Fable 5
Fable 5将于7月1日全球回归。我们还与亚马逊、微软、谷歌等Glasswing合作伙伴共同提出了一个全行业的越狱严重性评分框架。
Read more相关条目
精选DeepSeek V4 在 OpenRouter 上的代币份额翻倍,智能体工作负载成主要驱动力
DeepSeek V4 的快速采用表明市场对高性能、低成本推理模型的强烈偏好,尤其是智能体场景将重塑 AI 部署格局。
91
精选启用两项设置使ARC-AGI-3基准测试分数提升三倍
这项发现太关键了!它表明模型的性能不仅取决于训练,还取决于推理时的配置。对于AI工程师和研究者来说,这是一个必须注意的优化方向。特别是那些在资源受限设备上部署模型的团队,可能会因此找到低成本提升能力的方法。
91
精选GPT-5.6:前沿智能与前沿效率的融合
这条消息值得关注,因为它标志着大模型竞争从单纯拼参数转向拼效率。对于AI开发者和企业决策者来说,GPT-5.6意味着可以用更少预算获得更高性能,尤其适合那些被推理成本挡在门外的长上下文或Agent场景。OpenAI这一步,可能重新定义‘前沿’的标准。
91
精选LFM2.5-Encoder:面向CPU快速长上下文推理的新模型
这篇博文让我眼前一亮,因为它直接解决了大模型在CPU上跑长上下文的痛点。对于没有高端GPU的团队或个人开发者,LFM2.5-Encoder系列提供了可立即使用的开源方案。尤其推荐给做RAG、文档搜索或代码分析的朋友——现在用普通服务器就能处理百万级token的文档了。
91
精选GPT-Red:OpenAI通过自我对弈实现AI红队自动化,提升模型鲁棒性
GPT-Red 是红队测试从人工到自动化的里程碑,特别适合安全工程师和对齐研究者关注。它直接降低了测试成本,但也引发了对“自动攻击”本身的伦理讨论——值得所有关注AI治理的人深入思考。
91
精选OpenAI推出GPT-5.5生物漏洞赏金计划
这个计划值得关注,因为它首次将AI漏洞赏金制度拓展到生物安全领域,不仅为安全社区提供了新的研究方向,也为AI风险治理提供了实际演练场。对模型安全研究者、生物安全专家以及关心AI双重用途的从业者尤其重要。
91
精选vLLM推出原生速度Transformers建模后端,大幅提升推理性能
这项更新对于AI工程团队非常关键:无需格式转换意味着能更快地迭代模型,而2-5倍的速度提升直接降低GPU成本。如果你正在做LLM在线服务或者批量推理,这几乎是必读的技术更新。
90
精选Google DeepMind 发布手语转文本模型 SL2T,助力聋人用户
这则消息的意义不仅在于技术突破,更在于AI开始真正关注边缘群体的需求。对开发者而言,SL2T的架构思路和技术路径值得深入研究;对无障碍倡导者来说,这是推动行业标准的重要案例。