Anthropic 发布 Claude Sonnet 5:最强代理能力的 Sonnet 模型
评分
68精选理由
该模型在代理能力和编码智能上实现显著突破,且保持成本与速度优势,对开发者和企业具有高实用价值,但尚未达到前沿旗舰模型 AGI 级别。
AI 点评
「Claude Sonnet 5 标志着 AI 模型从被动响应向主动代理角色的关键演进,尤其为需要自主规划与执行的编码和办公场景提供了更高效率的解决方案。」
速览
Anthropic 正式发布 Claude Sonnet 5,定位为迄今为止代理能力最强的 Sonnet 系列模型,在编码和日常专业工作中具备顶级智能水平。该模型在复杂任务执行、工具调用和自主决策方面有显著提升,旨在为开发者和企业用户提供更高效的 AI 助手体验。Claude Sonnet 5 延续了 Sonnet 系列的速度与成本优势,同时在推理准确性和多步骤任务规划上实现突破。
- Claude Sonnet 5 是 Anthropic 发布的第三代 Sonnet 模型,专注于代理能力(Agentic)优化
- 在编码任务和日常专业工作中表现顶级智能水平,支持更复杂的工具调用和多步骤推理
- 延续 Sonnet 系列的速度与经济性,同时提升准确性和自主决策能力
- 面向开发者和企业场景,旨在作为高效的 AI 助手替代已有工作流
正文
介绍 Claude Sonnet 5
Jun 30, 2026
Claude Sonnet 5 旨在成为迄今为止最具代理能力的 Sonnet 模型。它能够制定计划、使用浏览器和终端等工具,并且以几个月前还需要更大、更昂贵模型才能达到的水平自主运行。
对于许多开发者而言,代理式 AI 时代始于 Sonnet 类模型:Claude Sonnet 3.5、3.6 和 3.7 是首批在编程和工具使用方面展现出令人印象深刻技能的模型。不过,近来代理能力最显著的提升出现在我们的 Opus 类模型中。
Sonnet 5 缩小了差距:其性能接近 Opus 4.8,但价格更低。相比前代 Sonnet 4.6,在代理性能的重要方面(如推理、工具使用、编程和知识工作)有了显著改进:
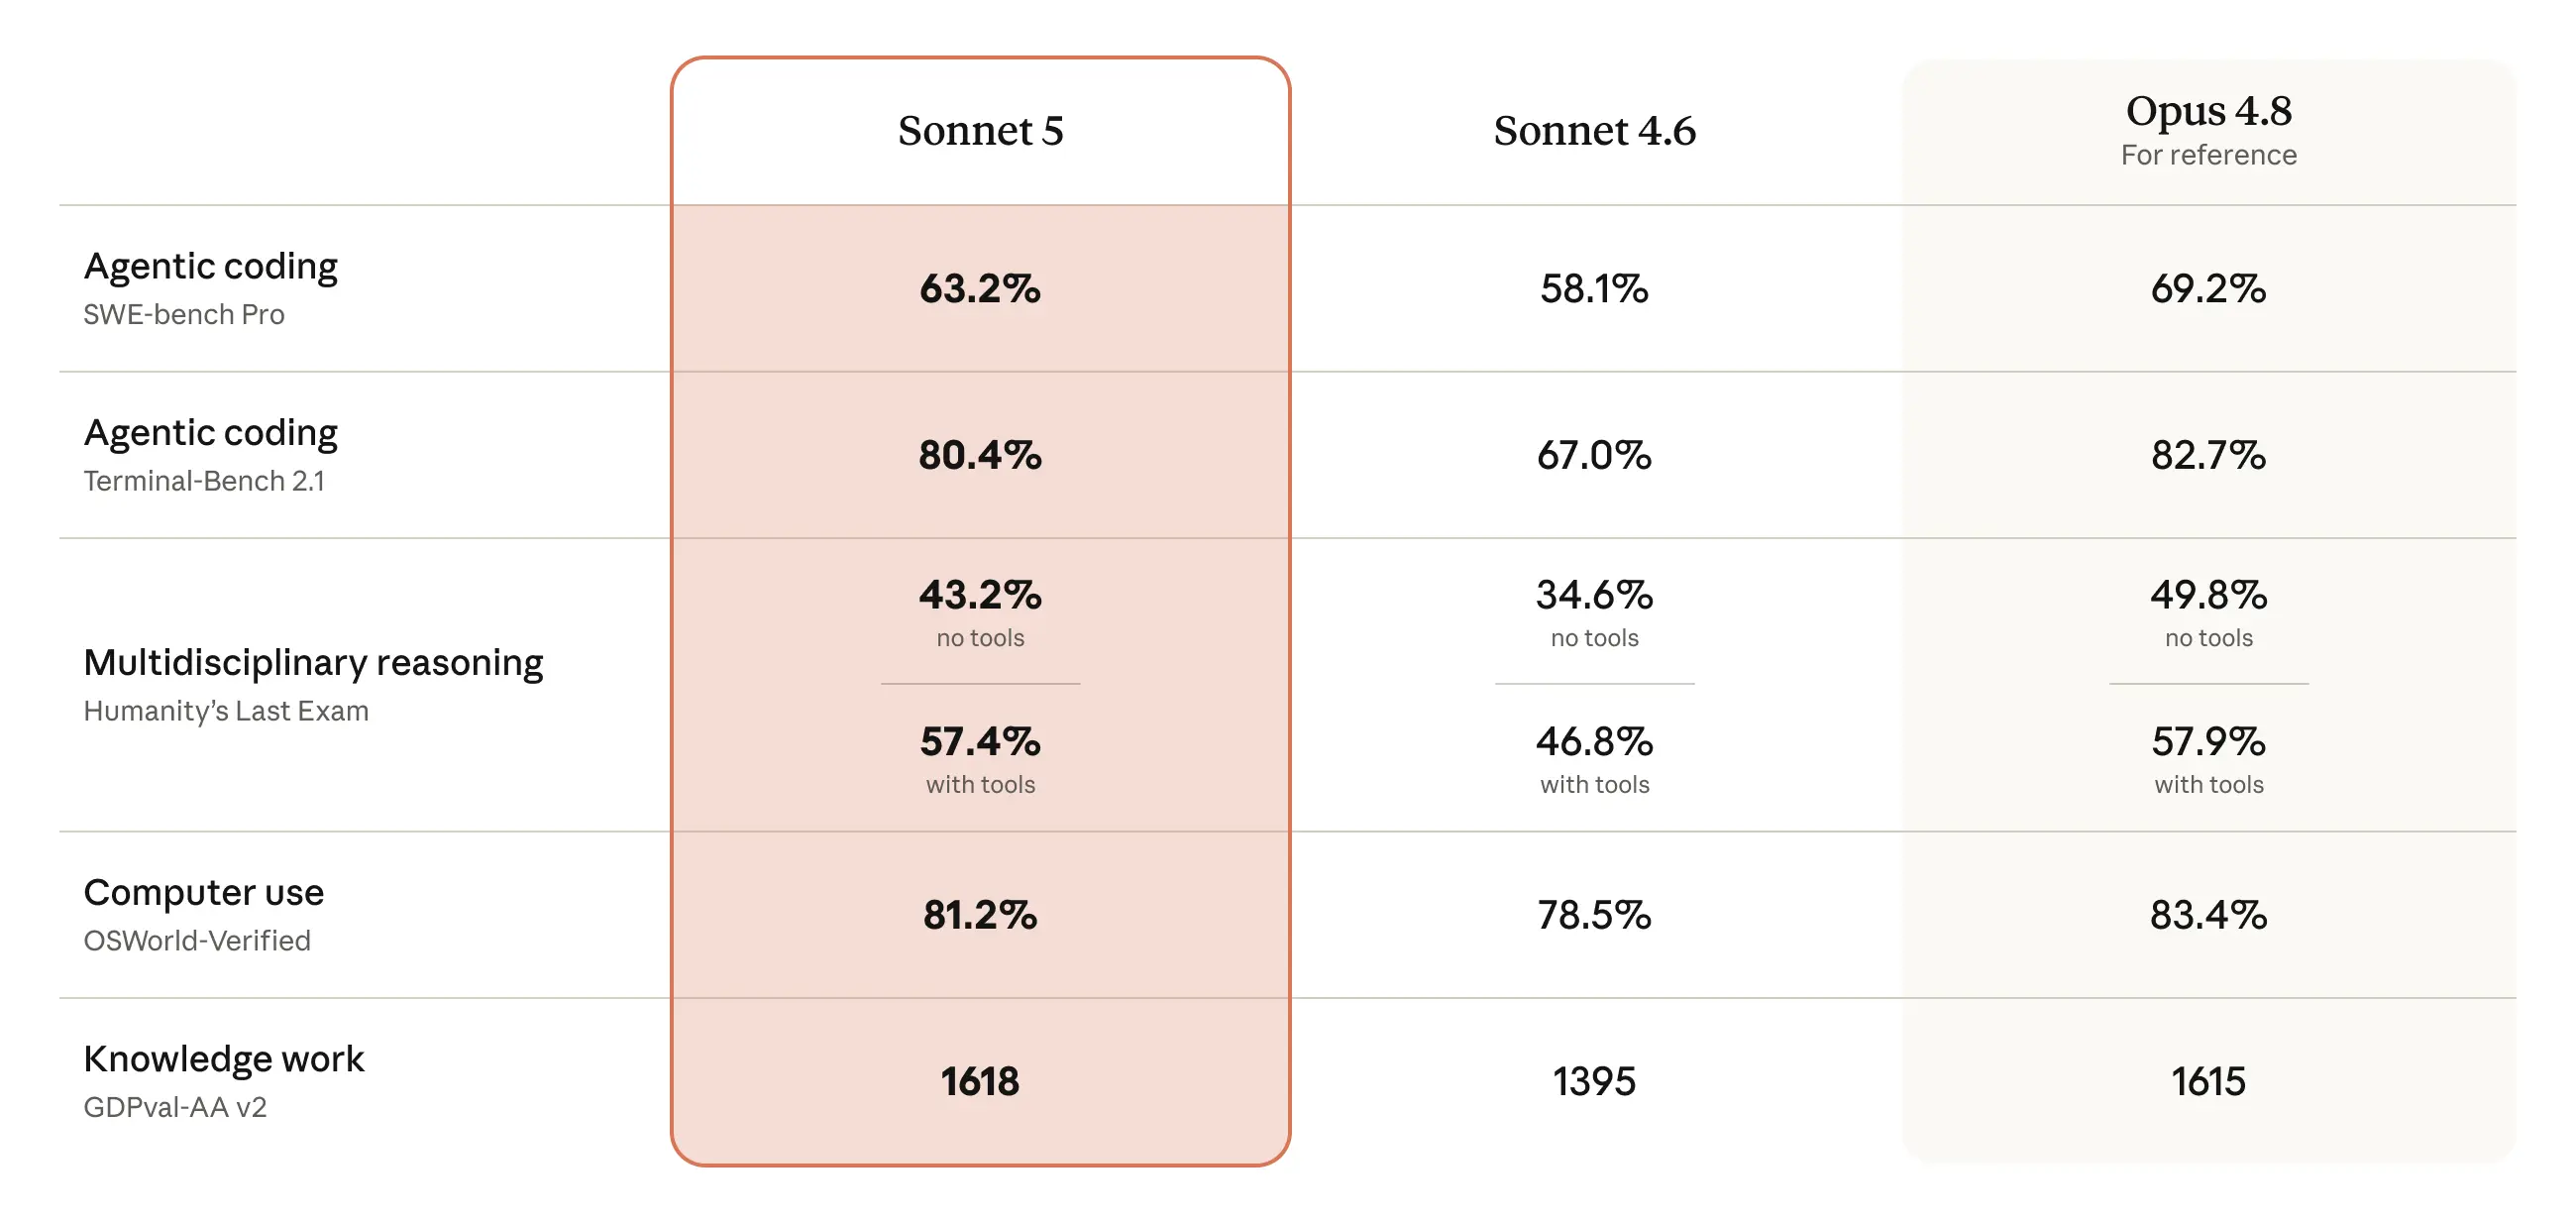
我们的安全评估发现,Sonnet 5 的不良行为发生率整体低于 Sonnet 4.6,并且在代理场景中通常更安全。评估还表明,其执行网络安全任务的能力远低于我们当前的 Opus 模型。
即日起,Claude Sonnet 5 在所有套餐中均可使用:它是 Free 和 Pro 套餐的默认模型,并且可供 Max、Team 和 Enterprise 用户使用。它也可以在 Claude Code 和 Claude Platform 上使用,初始定价为每百万输入 token 2 美元、每百万输出 token 10 美元(截至 2026 年 8 月 31 日),之后将定价为每百万输入 token 3 美元、每百万输出 token 15 美元。开发者可以通过 claude-sonnet-5 和 Claude API 使用它。
使用 Claude Sonnet 5
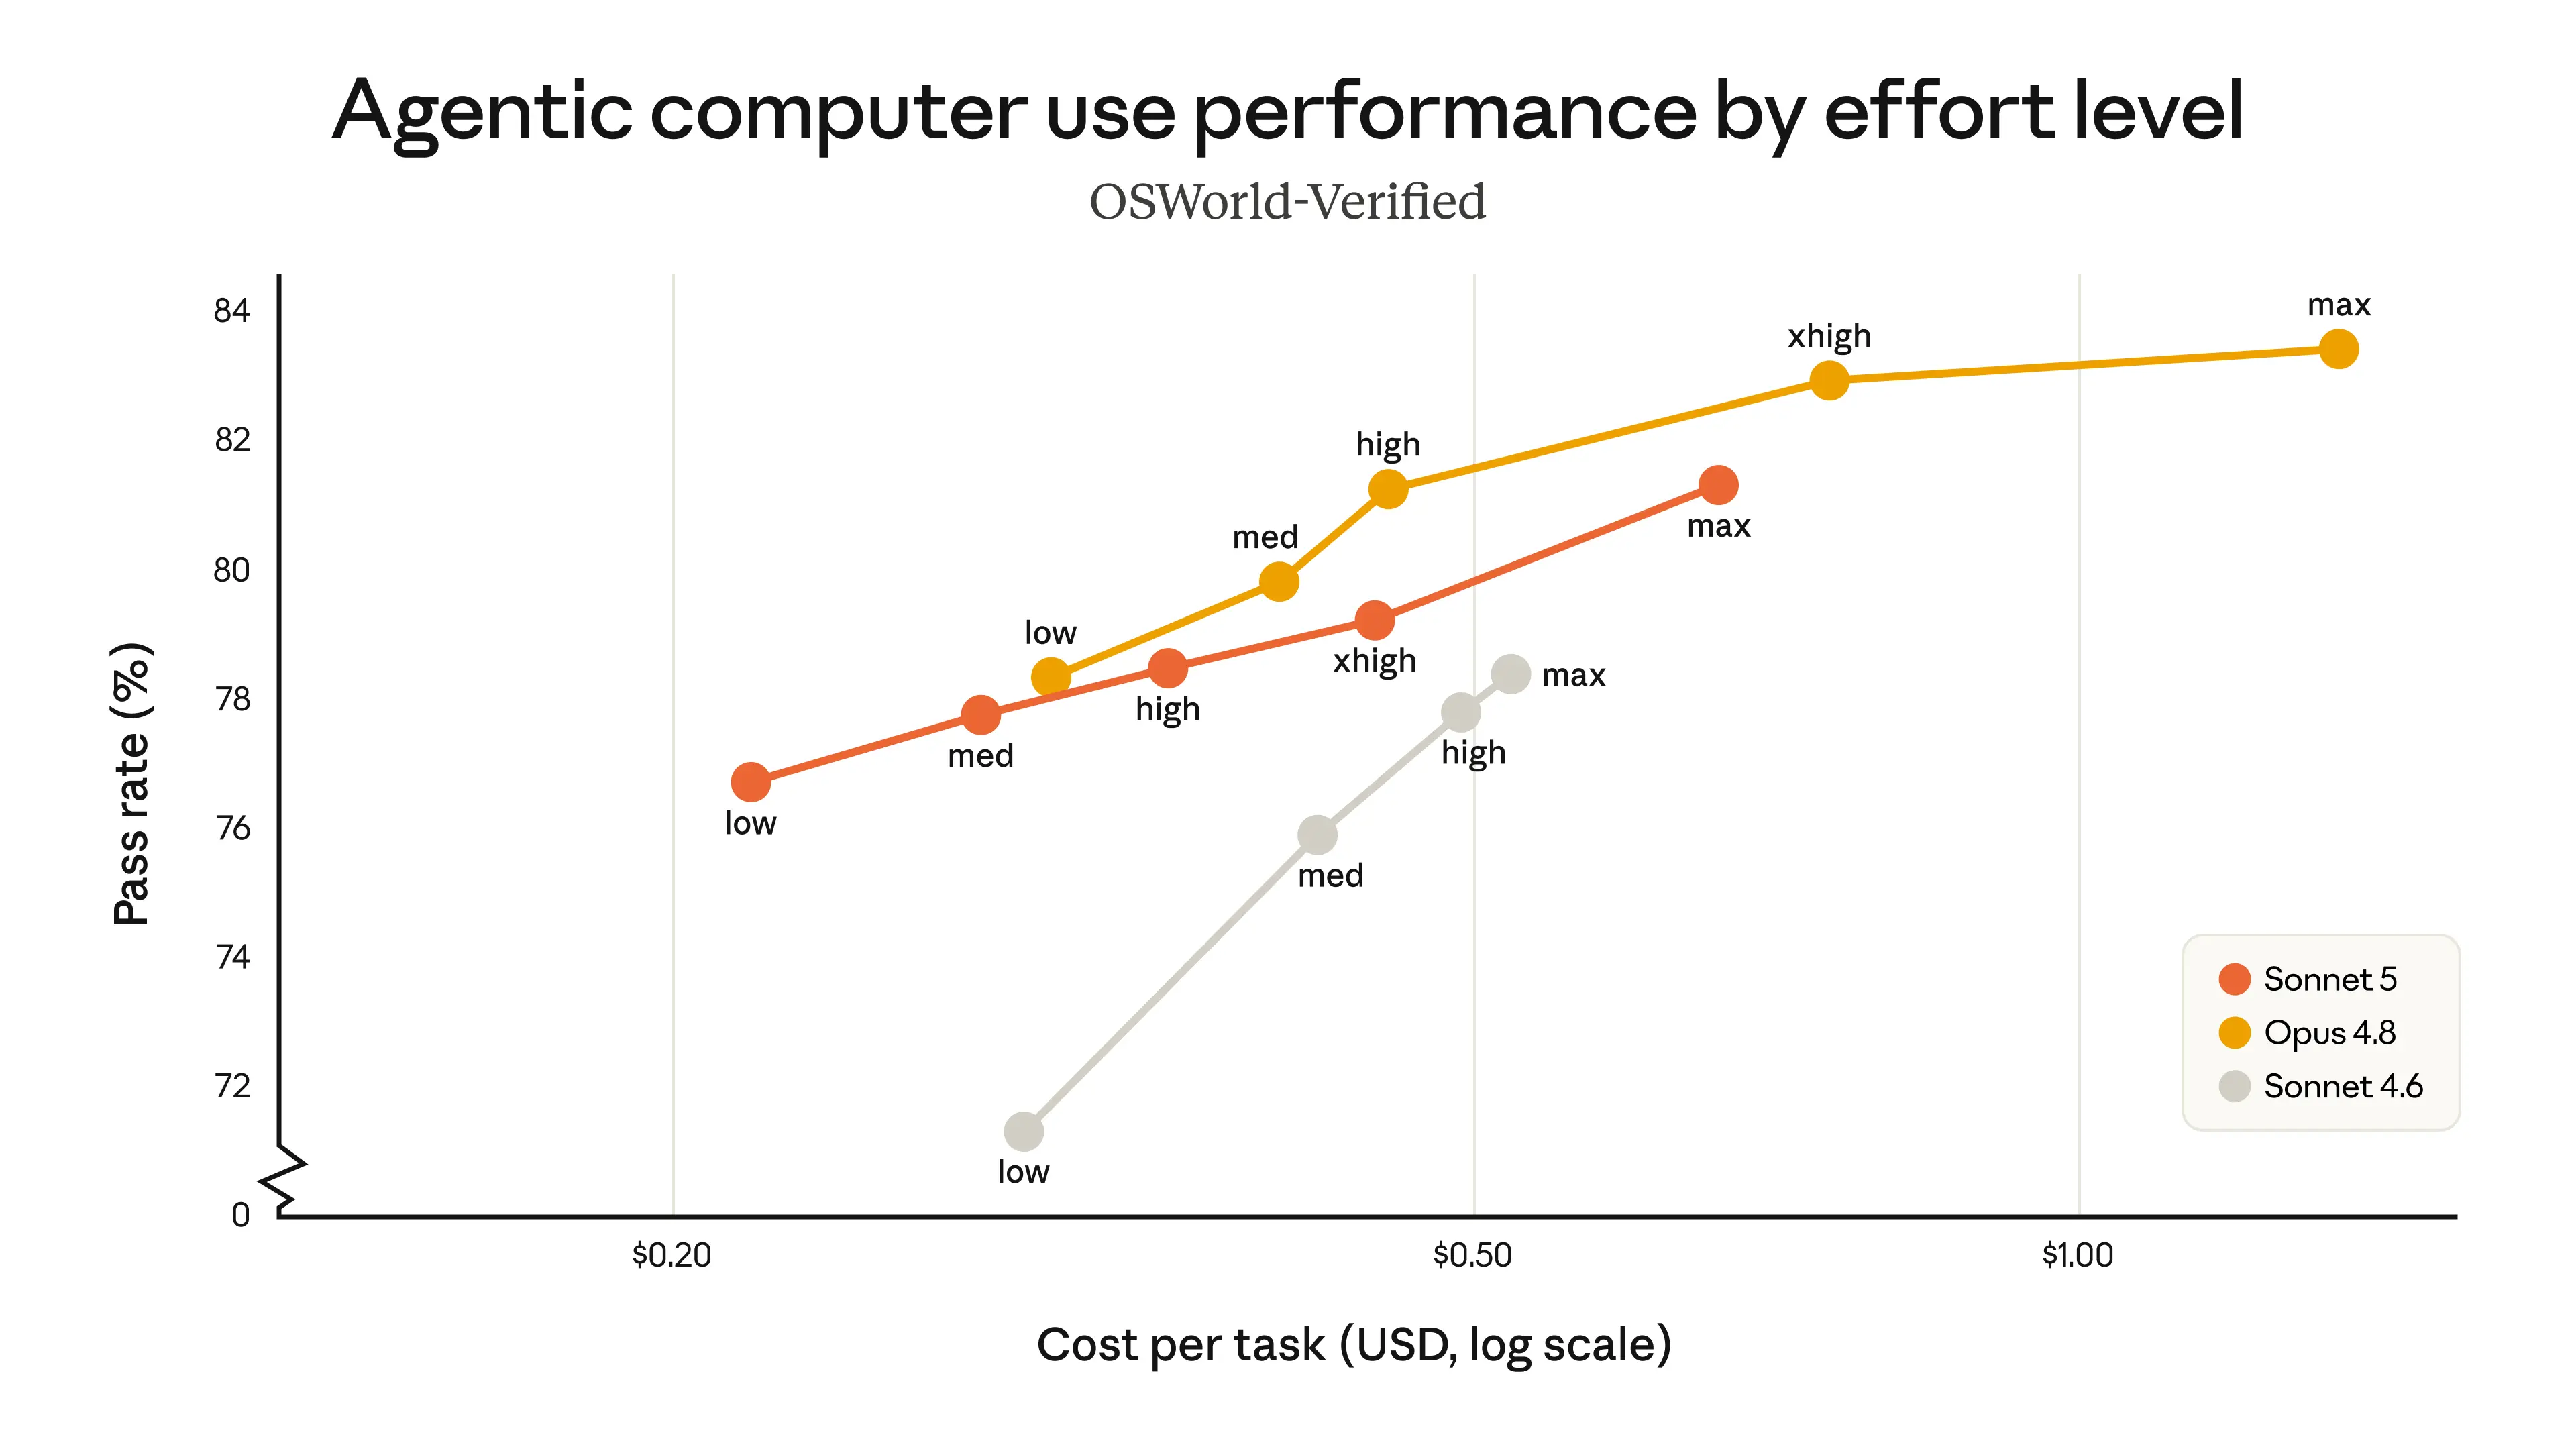
下图比较了 Sonnet 5 与 Sonnet 4.6 和 Opus 4.8 在不同 effort 水平下,在代理搜索评估 BrowseComp 和计算机使用评估 OSWorld-Verified 上的性能。Sonnet 5(橙色线)相比 Sonnet 4.6(灰色线)有严格提升,并且覆盖了比 Opus 4.8(黄色线)更广泛的性价比选项。它在中等 effort 水平下提供了显著提升的成本效率;在较高 effort 水平下,其性能可在某些任务上与 Opus 4.8 匹敌。在 Sonnet 5 和 Opus 4.8 之间,用户可以调整 effort 水平,以找到性价比的平衡点。
Agentic searchAgentic computer use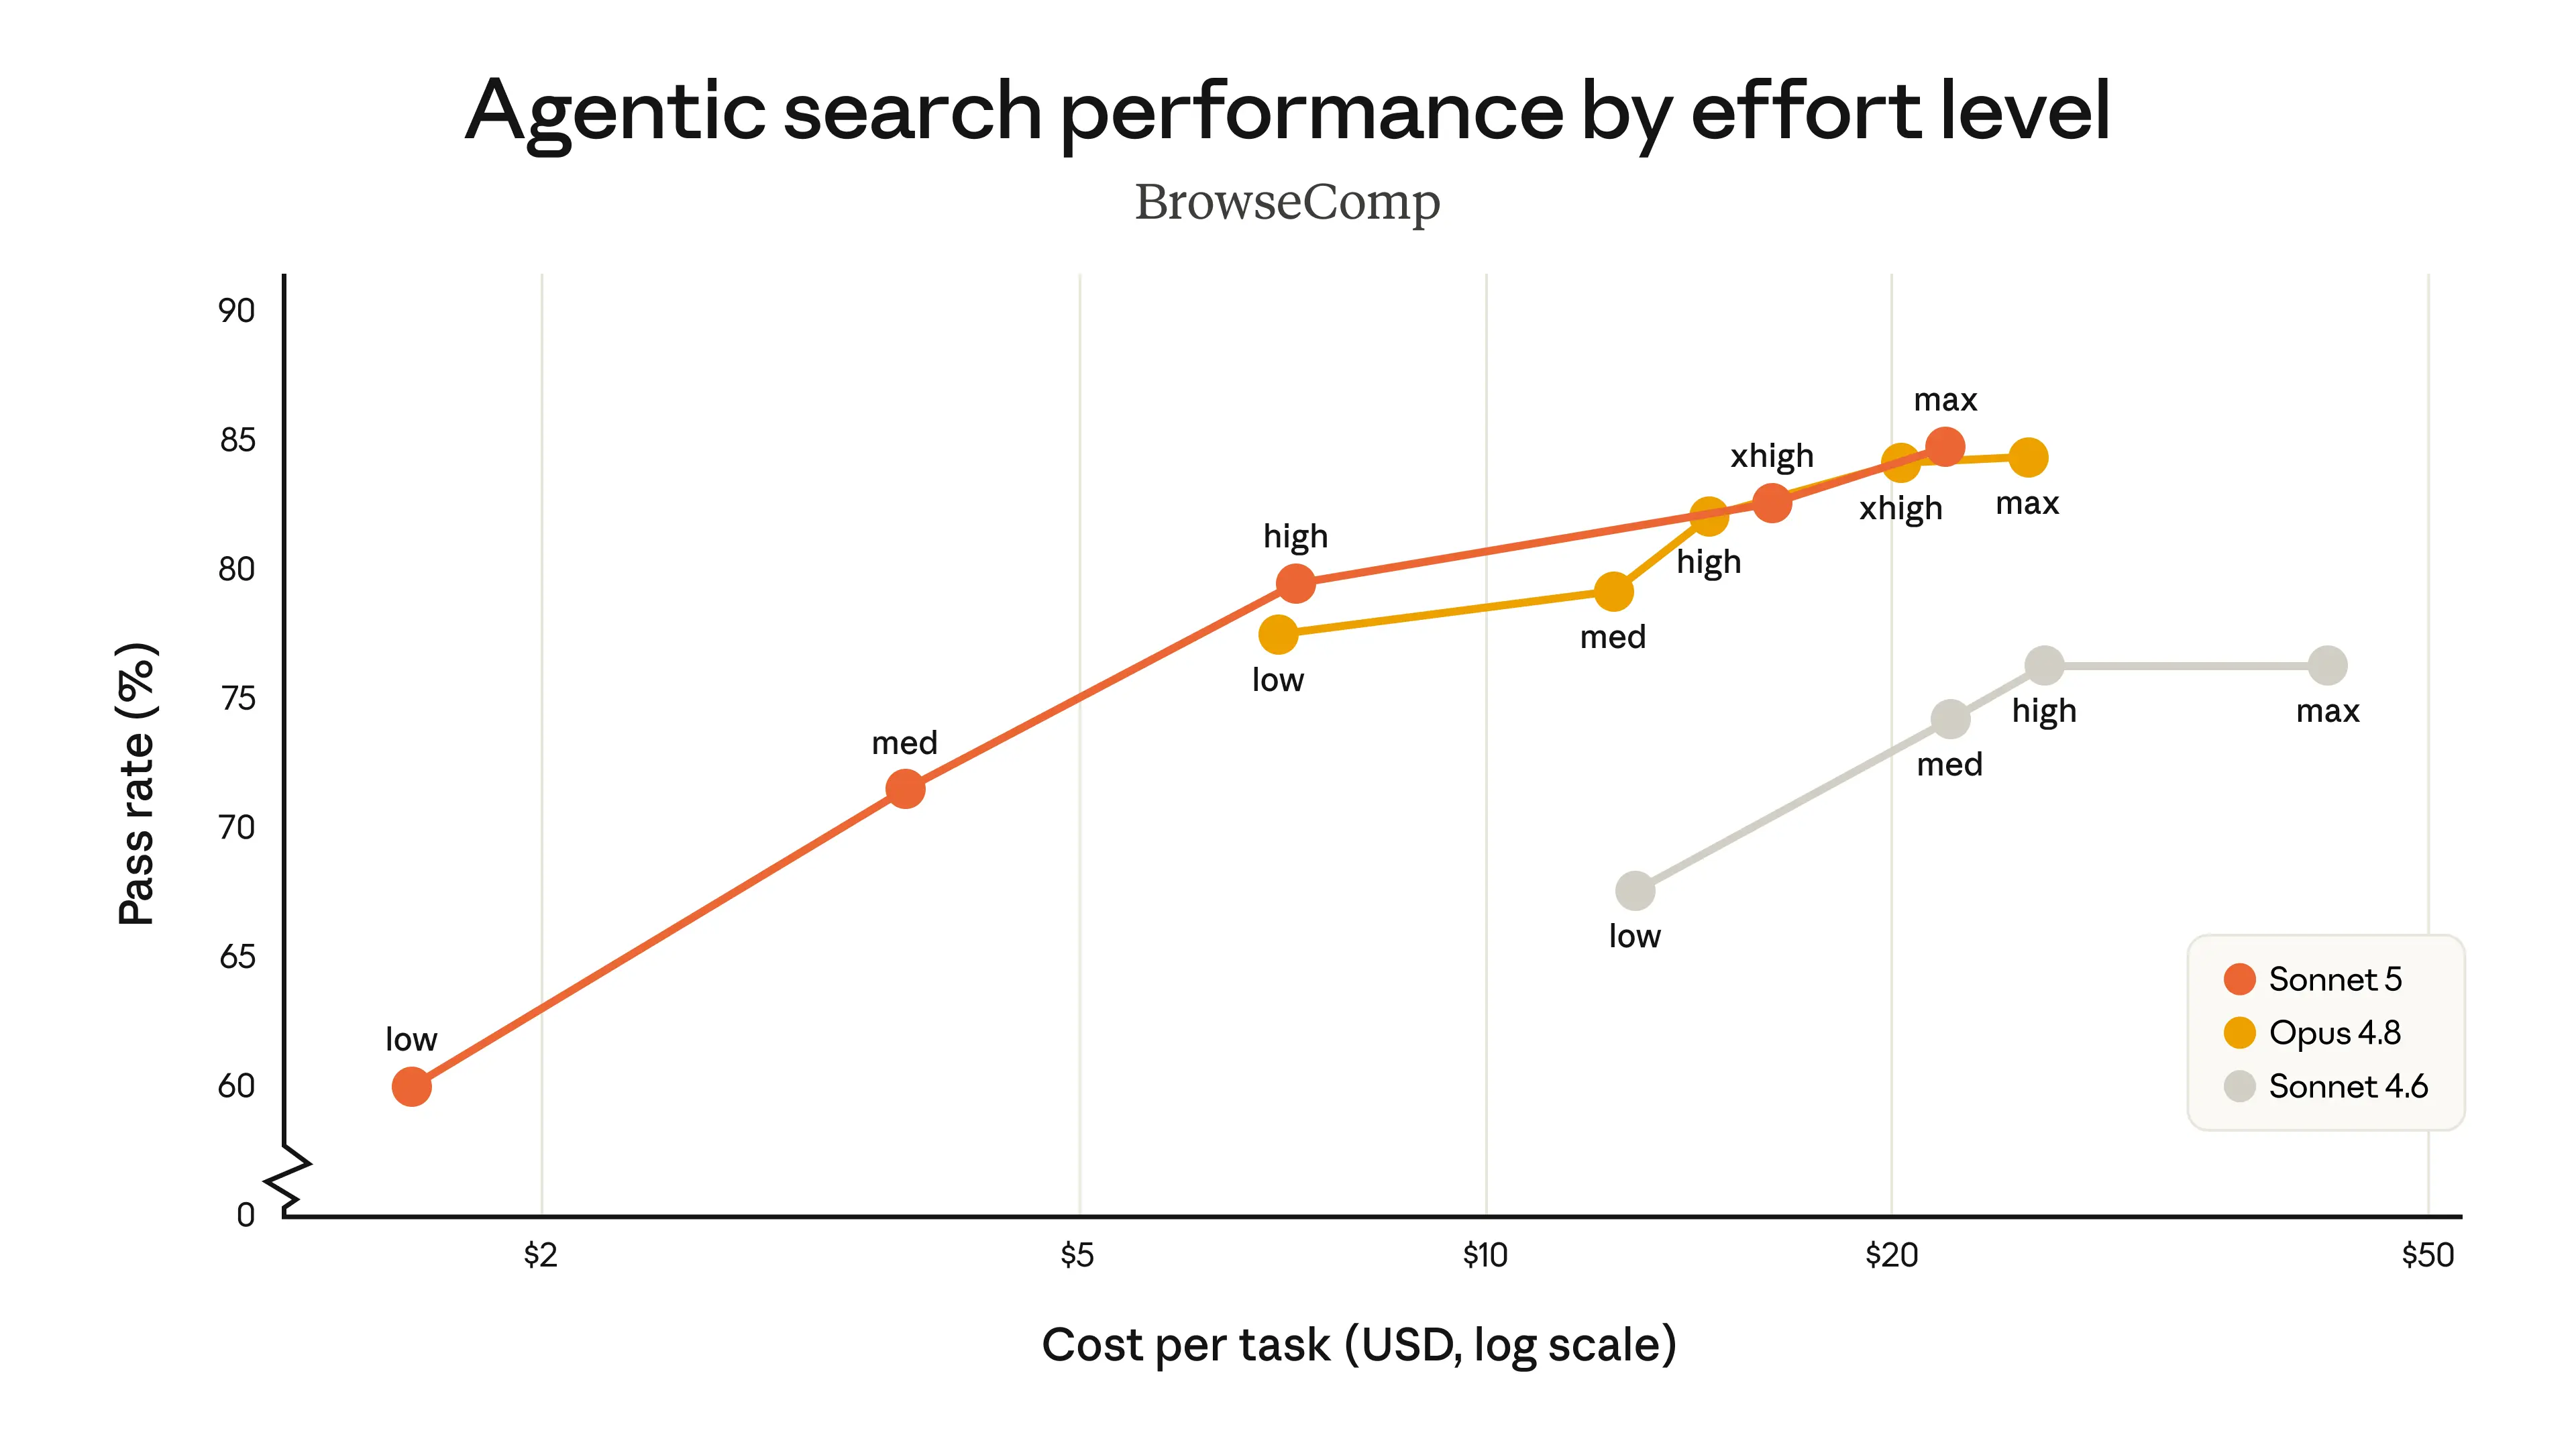
早期接入合作伙伴的反馈一致:Sonnet 5 比其前代更具自主性。测试人员描述它如何完成复杂任务——前代 Sonnet 模型会在中途停止,它如何在没有明确要求的情况下检查自己的输出,以及它如何以有吸引力的价格完成所有这些自主性工作:

Claude Sonnet 5 为我们的代理提供了强大的执行层,用于多步骤软件工程工作。它在混乱的技术环境中很好地处理了持续的编码、工具使用和调试,并且对于需要跟进和技术基础的工作流特别有用。Zimu Li 技术人员

我们交给 Claude Sonnet 5 一个两部分的工作——更新 Salesforce 账户层级,向企业联系人发送发布公告——它从头到尾完成了。以前这会在中途卡住。对于日常自动化来说,这是轻而易举的事。Daniel Shepard 高级工程师

Claude Sonnet 5 事半功倍。输出质量相同,但步骤更少。它还干净且一致地拒绝不安全请求。在 Lovable,我们正在将强大工具交到数百万构建者手中。一个知道何时说不的模型与一个知道如何构建的模型同样重要。Fabian Hedin 联合创始人

我们让 Claude Sonnet 5 处理数十个我们最具挑战性的真实拉取请求,它独立完成了每一个,并给出了经过测试和验证的结果——使我们的工程师能够专注于判断、决策和最终批准。Yusuke Kaji AI 业务总经理

我让 Claude Sonnet 5 调查一个 bug。无需提示,它编写了一个复现测试,实施了修复,然后将其暂存以确认没有该更改后 bug 会再次出现。全部在一次完成。Neel Chotai Rust 工程师兼软件工程师

使用 Claude Sonnet 5,代理遵循计划、遵守我们的约定,并交付干净的多步骤更改,且成本高效。Sualeh Asif 联合创始人

Claude Sonnet 5 在棕地代码上表现最佳——竞态条件、隐藏测试、没人想碰的部分。它能将故障追溯到实际根本原因,并发布持久修复,而不是修补症状。Dominic Elm 创始工程师

Claude Sonnet 5 在 Eve 的原告法律任务中处于帕累托前沿。我们在法律研究和分析中看到了最明显的收益,其性价比使迁移变得容易。Mauricio Wulfovich 职员机器学习工程师

ClickHouse 代理实时探索数据并即时产生洞察,因此在测试新模型时,洞察时间至关重要。Claude Sonnet 5 以更紧凑的步骤推理,让我们的用户显著更快地得到答案。这种速度是我们的客户能感受到的差异。Ryadh Dahimene AI/ML 产品管理总监

在 Pace,我们的计算机使用代理在运营团队已使用的系统上运行保险工作流——提交受理、首次损失通知、损失运行。Claude Sonnet 5 始终采取正确行动并快速完成,这正是真正保险工作所需。Eric He 技术人员

对于管理高容量、复杂工作负载的企业团队来说,Claude Sonnet 5 代表了一次真正的进步——在关键领域表现强劲,同时具备使扩展变得实用的速度和成本特征。在几个复杂任务上,它超越了当前前沿,同时以低成本提供快速响应。对于大规模运营的企业来说,这是一个真正的运营胜利。Ben Kus 首席技术官

Claude Sonnet 5 处理了我们测试的各种编码任务,同时解决了更多问题。这对质量和效率都是一个有意义的改进。Manav Khurana 首席产品营销官

Claude Sonnet 5 是一个强大的自主编码模型,提供与 Opus 类模型相媲美的一流准确性,并且相比 Sonnet 4.6 有明显的阶跃函数改进。它进行彻底的探索,并在复杂任务上显著更长时间地保持专注。Deepak Singh Kiro 副总裁01 / 13
安全评估
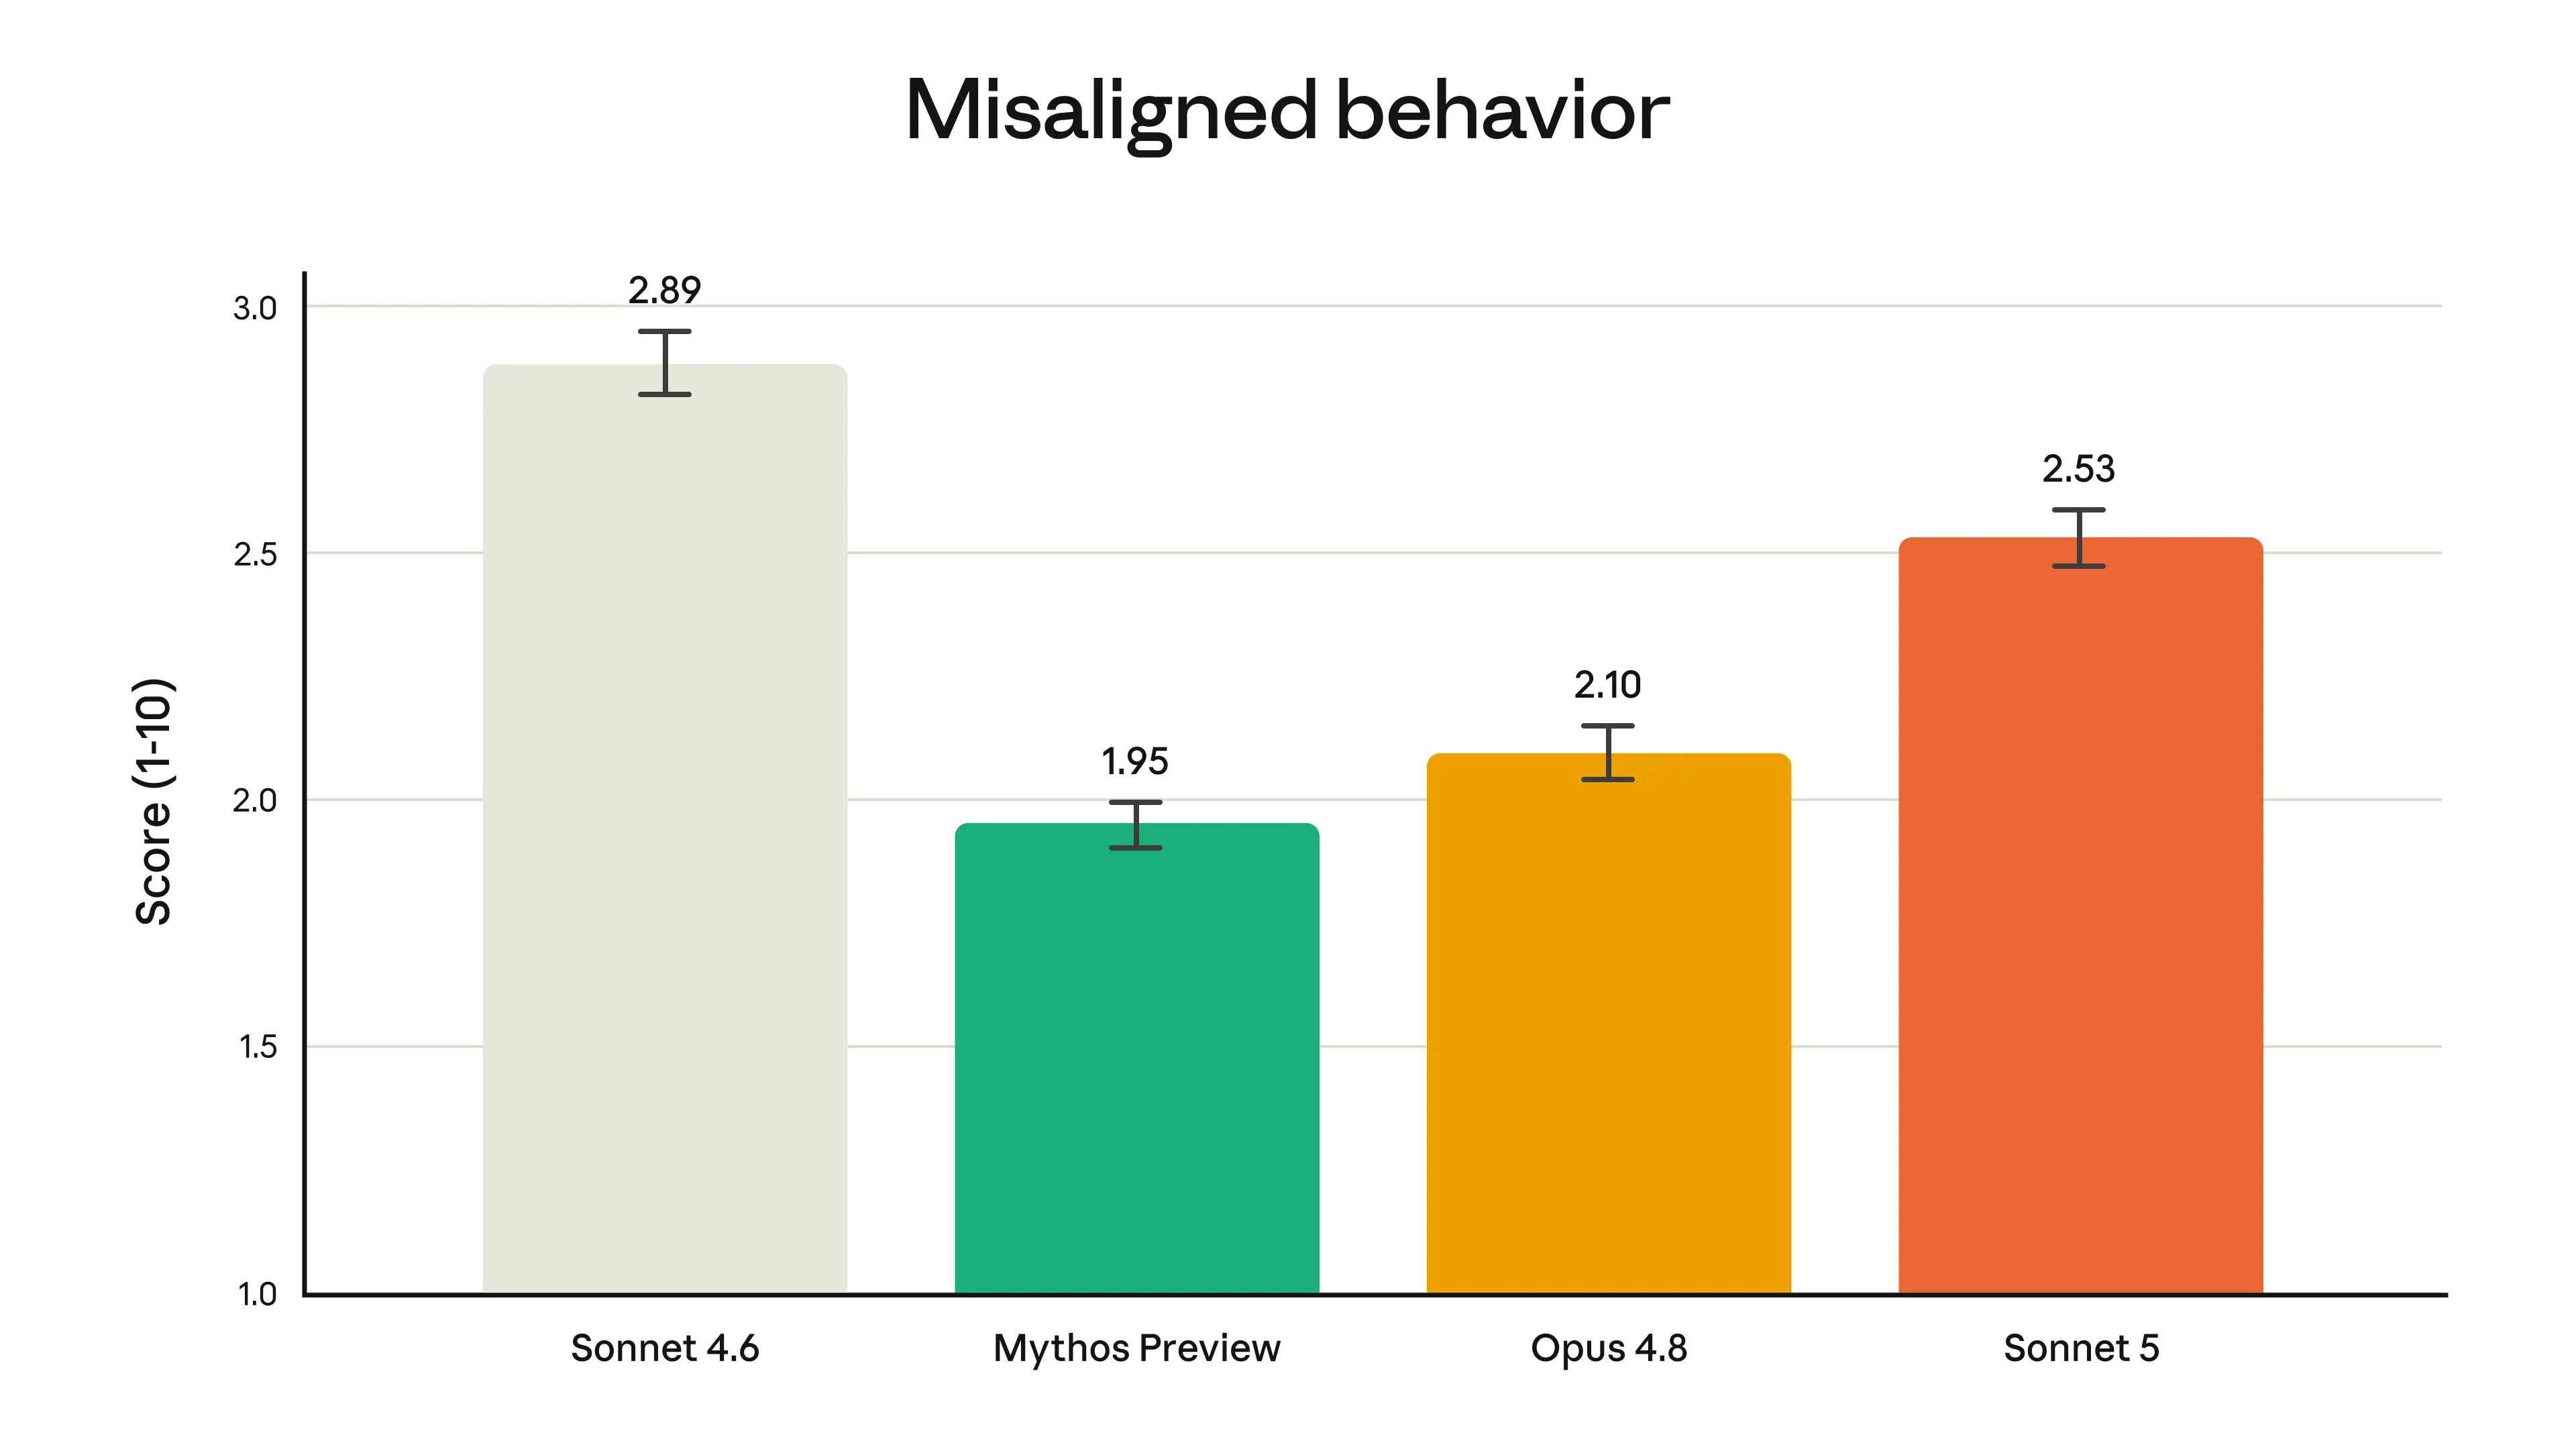
Our pre-deployment safety evaluations found that Sonnet 5 was overall an improvement on Sonnet 4.6. On agentic safety, the model is better at refusing malicious requests and resisting hijack attempts in prompt injection attacks. The model shows lower rates of hallucination and sycophancy than Sonnet 4.6. On our automated behavioral audit, which tests a wide range of misaligned behaviors such as cooperation with misuse and deception, Sonnet 5 scored lower (that is, safer) overall. However, it did show somewhat higher rates of misaligned behavior on this assessment compared to the more capable Opus 4.8 and Claude Mythos Preview.
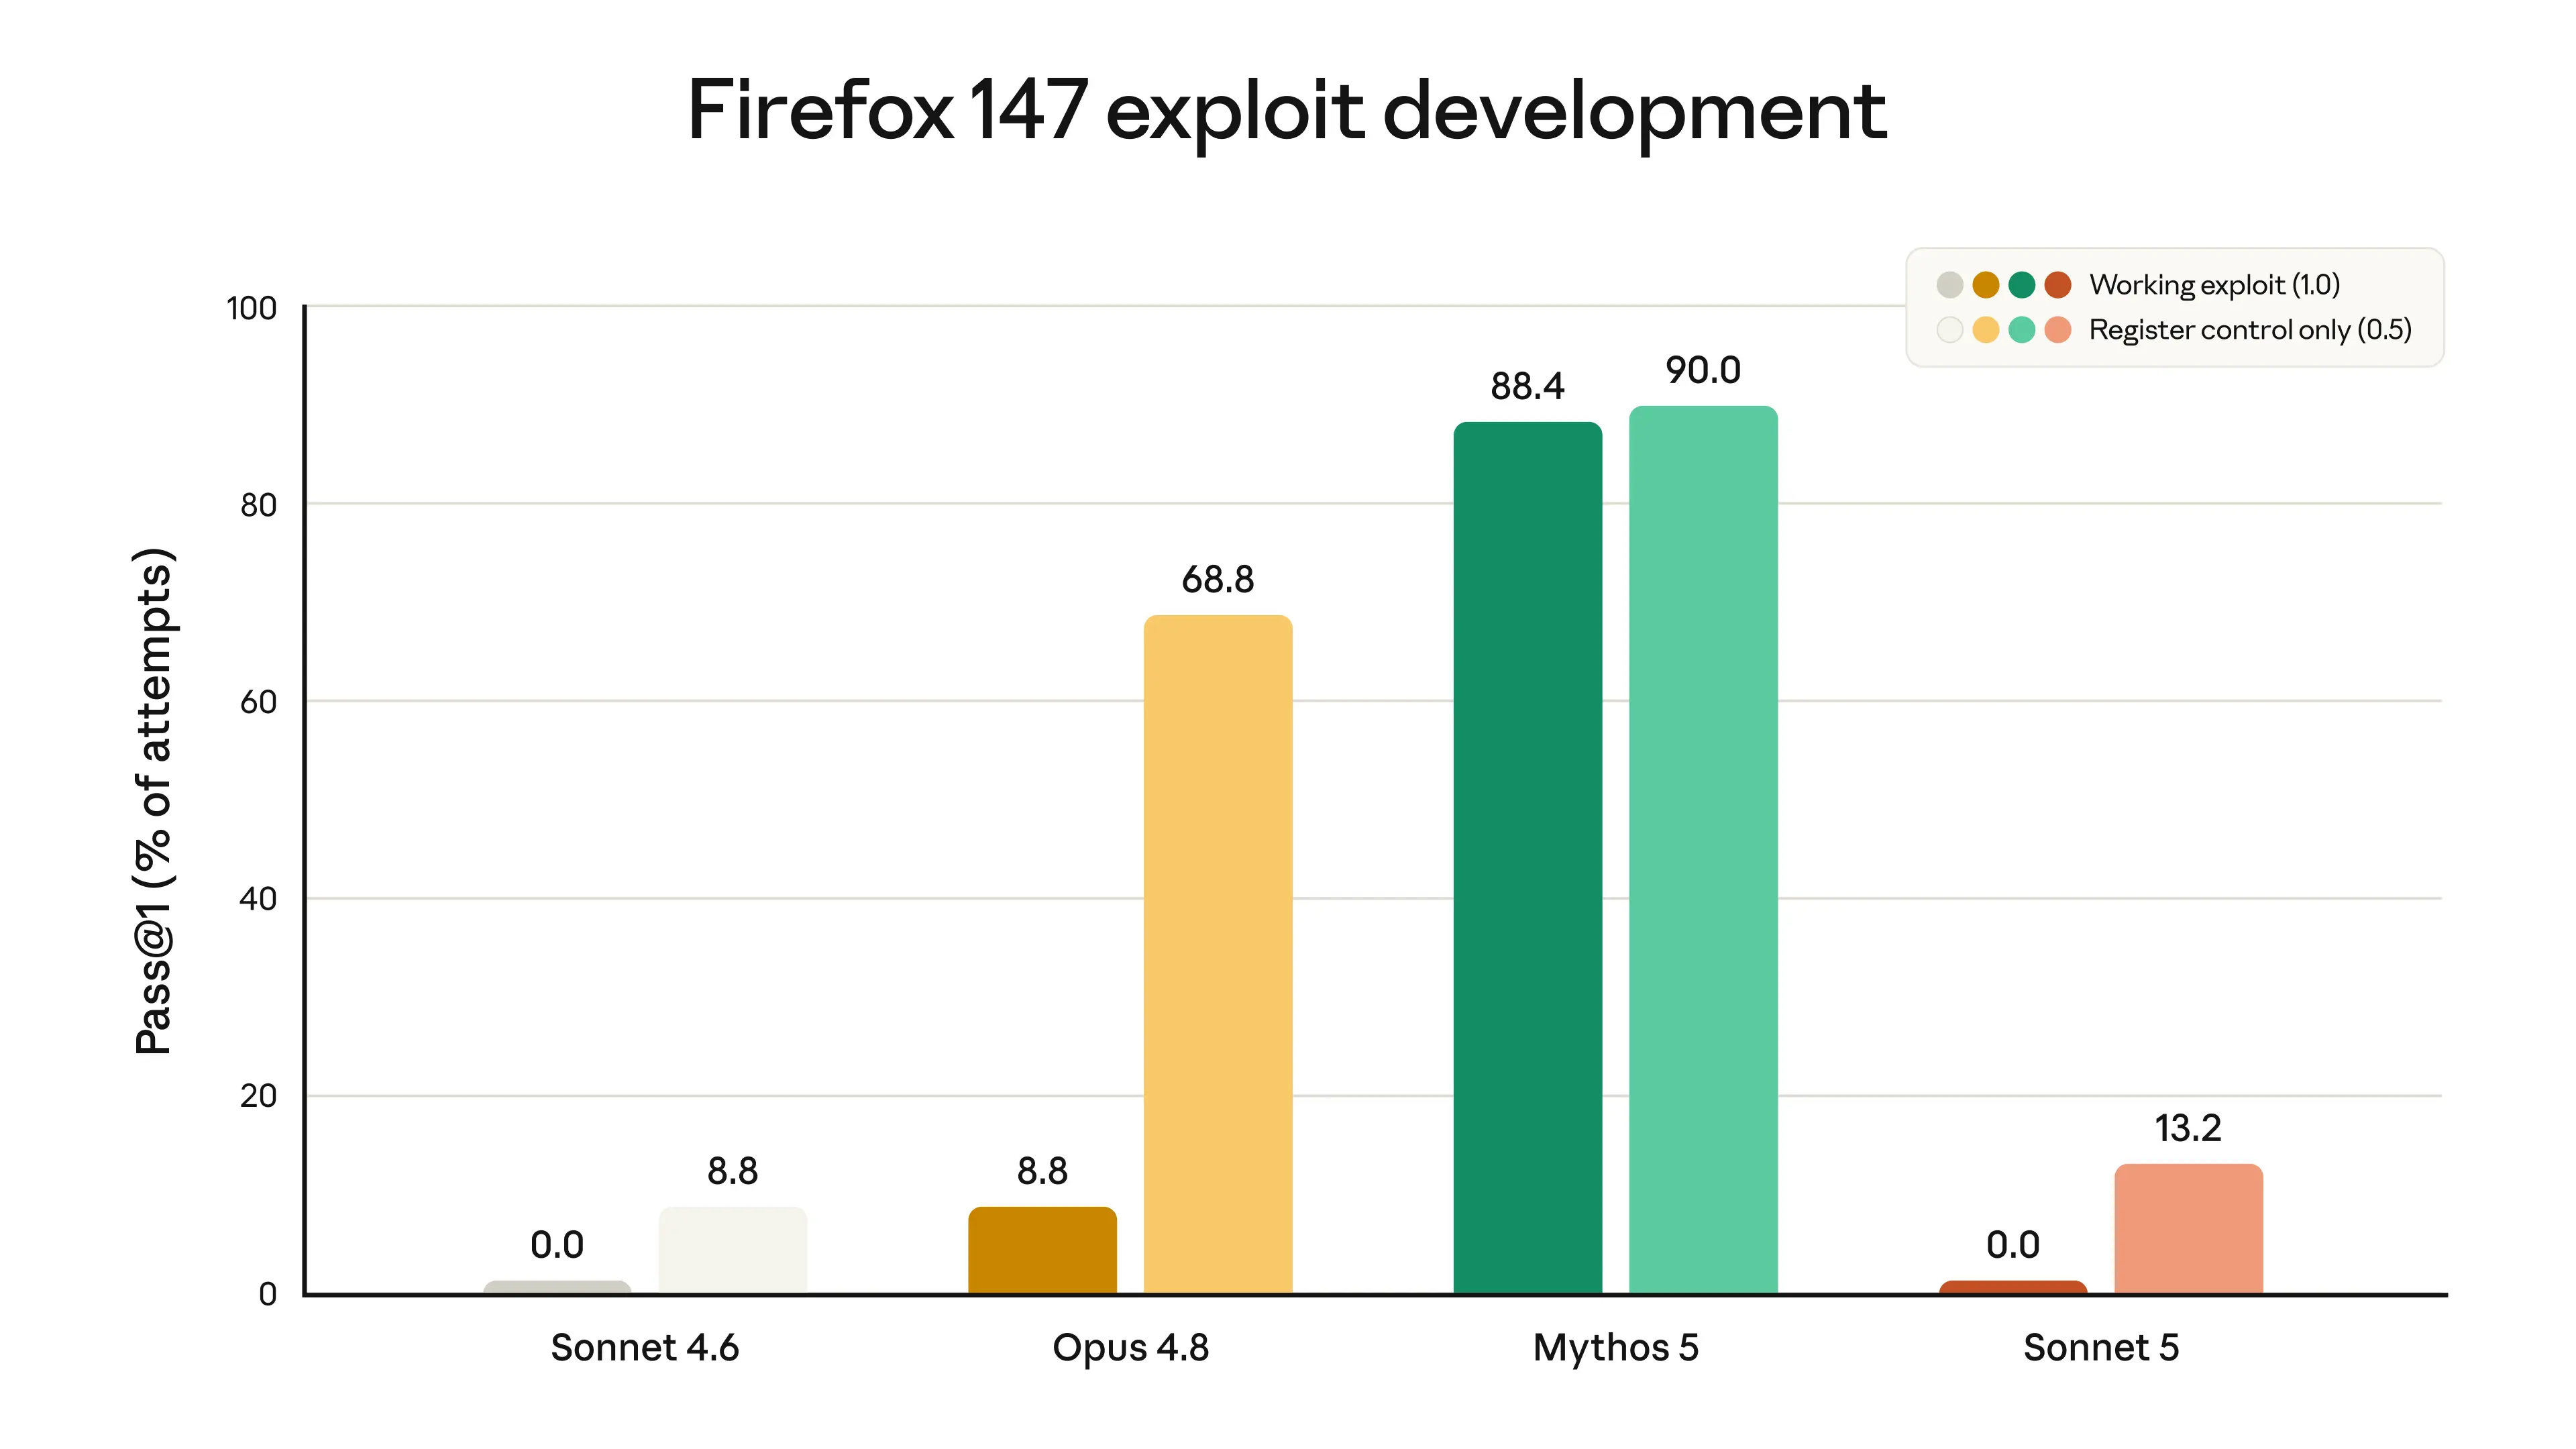
We did not deliberately train Sonnet 5 on cybersecurity tasks. It can perform some routine, non-harmful cyber tasks, but on evaluations testing potentially dangerous cyber skills, such as developing software exploits, it shows substantially poorer performance than models such as Opus 4.8 and Mythos 5. Scores from one evaluation, which tested models’ ability to develop exploits for vulnerabilities in the Firefox browser, are shown in the chart below. Sonnet 5 was never able to develop a full working exploit, but it does show a slightly higher rate of partial success than Sonnet 4.6. This latter change is likely due to improvements in general intelligence rather than specific training.
Since Sonnet 5 is somewhat stronger than its predecessor on these tasks, we’ve launched it with cyber safeguards enabled by default. These safeguards—which detect and block dangerous cyber usage in real time—are the same as those present in Claude Opus 4.7 and 4.8 (because we judged that the overall level of cybersecurity risk from Sonnet 5 was low, the safeguards are less strict than those launched with Fable 5, which block a much wider range of cybersecurity tasks).1
Our full assessment of Sonnet 5 across many safety and capability evaluations is reported in the Claude Sonnet 5 System Card.
可用性与定价
Claude Sonnet 5 现已全面上线,2026 年 8 月 31 日前享有每百万输入令牌 2 美元、每百万输出令牌 10 美元的优惠价格。之后将调整为标准定价:每百万输入令牌 3 美元、每百万输出令牌 15 美元。[2] 我们已提高 Chat、Cowork、Claude Code 和 Claude Platform[3] 的速率限制,以适应更高努力级别带来的更高令牌用量;用户可根据具体项目选择相应的级别。
更新日志
编辑于 2026 年 6 月 30 日:在本帖的原始版本中,我们包含了一张 BrowseComp 评估的成本-性能图表,该图表基于一种更简单的方法学数据,并未反映我们在智能体搜索评估中使用的 标准方法学。这导致低估了 Sonnet 5 在该评估中的表现。
我们现在已经更新了图表,使其与我们使用并讨论过的方法论相匹配,在Sonnet 5 system card中(该方法使用1000万token预算,配合压缩和编程工具调用)。我们还更新了周围的文本。
脚注
1 Sonnet 5是我们Cyber Verification Program的一部分,该计划现已在原生Claude平台、AWS上的Claude平台、Microsoft Foundry中的Claude(托管在Azure和Anthropic)上可用,即将在Google Vertex中的Claude上推出。已注册Cyber Verification Program的组织自动在Sonnet 5上享有相同的访问权限,无需重新申请。总体而言,对于需要减少护栏的网络安全工作,我们推荐Claude Opus 4.8。
2 Sonnet 5是Sonnet 4.6的升级版,但它使用了更新的分词器,改变了模型处理文本的方式以提升性能(这与我们在Claude Opus 4.7中引入的分词器变更类似)。其代价是相同的输入可能映射到更多的token:大约1.0-1.35倍,具体取决于内容类型。初始定价设置为使向Sonnet 5的过渡大致成本中性。
3 2026年4月26日,我们在每个使用层级提高了Sonnet和Haiku的速率限制,并在原生Claude平台上简化为三个层级(Start、Build和Scale)。您可以在Claude Console中查看您的层级和当前限制,或阅读文档了解更多信息。
- Humanity’s Last Exam: 我们更新了Humanity’s Last Exam的评分模型,并将Sonnet 4.6的分数更新为34.6%(无工具)和46.8%(有工具)。这就是该分数与Sonnet 4.6 launch blog中报告分数不同的原因。
- OSWorld-Verified: 我们更改了运行OSWorld-Verified评估的方式,以更准确地反映模型在现实世界中的表现,并将Sonnet 4.6的分数更新为78.5%。这就是该分数与Sonnet 4.6 launch blog中报告分数不同的原因。
相关内容
关于Fable 5的网络安全防护措施及我们的越狱框架的更多详情
Read more重新部署Fable 5
Fable 5将于7月1日全球回归。我们还在与亚马逊、微软、谷歌及其他Glasswing合作伙伴共同提出一个行业范围的越狱严重性评分框架。
Read moreClaude Science,一款面向科学家的AI工作台,现已可用
Claude Science是一款可定制的应用程序,集成了研究人员最常用的工具和软件包,生成可审计的成果,并提供对计算资源的灵活访问。
Read more同一事件的其他报道
- T1.5Claude Code:GitHub Releases(RSS)Claude Code v2.1.201 发布:Sonnet 5 会话取消中间系统角色提醒07:50
- T2Simon Willison 博客(Atom)Claude Sonnet 5.506:07
- T2TechCrunch:AI(RSS)Anthropic发布Claude Sonnet 5:更便宜的代理运行方案02:00
相关条目
精选DeepSeek V4 在 OpenRouter 上的代币份额翻倍,智能体工作负载成主要驱动力
DeepSeek V4 的快速采用表明市场对高性能、低成本推理模型的强烈偏好,尤其是智能体场景将重塑 AI 部署格局。
91
精选启用两项设置使ARC-AGI-3基准测试分数提升三倍
这项发现太关键了!它表明模型的性能不仅取决于训练,还取决于推理时的配置。对于AI工程师和研究者来说,这是一个必须注意的优化方向。特别是那些在资源受限设备上部署模型的团队,可能会因此找到低成本提升能力的方法。
91
精选GPT-5.6:前沿智能与前沿效率的融合
这条消息值得关注,因为它标志着大模型竞争从单纯拼参数转向拼效率。对于AI开发者和企业决策者来说,GPT-5.6意味着可以用更少预算获得更高性能,尤其适合那些被推理成本挡在门外的长上下文或Agent场景。OpenAI这一步,可能重新定义‘前沿’的标准。
91
精选LFM2.5-Encoder:面向CPU快速长上下文推理的新模型
这篇博文让我眼前一亮,因为它直接解决了大模型在CPU上跑长上下文的痛点。对于没有高端GPU的团队或个人开发者,LFM2.5-Encoder系列提供了可立即使用的开源方案。尤其推荐给做RAG、文档搜索或代码分析的朋友——现在用普通服务器就能处理百万级token的文档了。
91
精选GPT-Red:OpenAI通过自我对弈实现AI红队自动化,提升模型鲁棒性
GPT-Red 是红队测试从人工到自动化的里程碑,特别适合安全工程师和对齐研究者关注。它直接降低了测试成本,但也引发了对“自动攻击”本身的伦理讨论——值得所有关注AI治理的人深入思考。
91
精选OpenAI推出GPT-5.5生物漏洞赏金计划
这个计划值得关注,因为它首次将AI漏洞赏金制度拓展到生物安全领域,不仅为安全社区提供了新的研究方向,也为AI风险治理提供了实际演练场。对模型安全研究者、生物安全专家以及关心AI双重用途的从业者尤其重要。
91
精选vLLM推出原生速度Transformers建模后端,大幅提升推理性能
这项更新对于AI工程团队非常关键:无需格式转换意味着能更快地迭代模型,而2-5倍的速度提升直接降低GPU成本。如果你正在做LLM在线服务或者批量推理,这几乎是必读的技术更新。
90
精选Google DeepMind 发布手语转文本模型 SL2T,助力聋人用户
这则消息的意义不仅在于技术突破,更在于AI开始真正关注边缘群体的需求。对开发者而言,SL2T的架构思路和技术路径值得深入研究;对无障碍倡导者来说,这是推动行业标准的重要案例。