Meta 发布开源模型 Muse Glimmer,专注 Agent 任务完成
评分
79独家介绍新发布的 Muse Glimmer 并提供第一手实测细节,信息增量高。
包含模型定位、基准表现和实际运行案例,内容扎实但缺少体系化评估。
给出量化体积、内存需求和本地运行工具链,对开发者有直接操作参考价值。
报道紧贴模型发布当天,具有很强时效性。
Simon Willison 是知名开发者博主,信源可靠,但属于个人博客而非官方发布。
基础分 88 × T2 信源权重 ×0.9 = 79
精选线 70已入选精选
精选理由
新模型发布信息及时且经知名开发者博主实测,但缺少与其他模型的直接基准对比数据。
AI 点评
「这个模型最让我兴奋的不是参数规模,而是 Apache 2.0 许可和本地可运行的组合——它意味着开发者可以真正把 Agent 技术握在自己手里,而不是被平台绑定。对于正在做工具调用和长任务规划方向的人,Muse Glimmer 值得立刻拉下来跑一轮。」
速览
Meta 发布全新 30B 开源模型 Muse Glimmer,基于 Apache 2.0 许可,重回开放权重阵营。该模型针对端到端 Agent 任务完成优化,在 DeepSearch QA、MCP-Atlas、Tau-Bench 和 SWE-Bench 等完整任务基准上表现突出,支持可靠工具调用、长程多步推理及视觉输入。Simon Willison 试用 18.16 GB 量化版,在 32GB 内存机器上可流畅运行,并验证了其代码库探索与图像描述能力。
- Muse Glimmer 是一个 30B 参数的全新开源模型,采用 Apache 2.0 许可,比 Llama 的授权更宽松。
- 针对端到端 Agent 任务完成优化,在 DeepSearch QA、MCP-Atlas、Tau-Bench、SWE-Bench 等基准上表现优异。
- 支持可靠工具调用、长程多步推理和视觉理解,适合构建本地代理。
- 18.16 GB 量化版可在 32GB 内存设备上运行,作者已用 LM Studio 和 llm-coding-agent 插件完成实测。
正文
他们声称针对我在本地模型中寻找的那类需求进行了优化:
端到端代理任务完成。Muse Glimmer 在完整任务基准测试中取得了很高的成功率,包括 DeepSearch QA、MCP-Atlas、𝛕-Bench 和 SWE-Bench,这些基准测试衡量了它在脚手架内工作、编写和调试代码以及从头到尾解决多轮请求的能力。 可靠的工具使用。该模型处理各种函数调用,在扩展工作流中以精确的模式调用工具。 多步推理。Muse Glimmer 在长时间跨度内进行链式推理,在复杂、扩展的工作流中维持连贯的计划。[...]
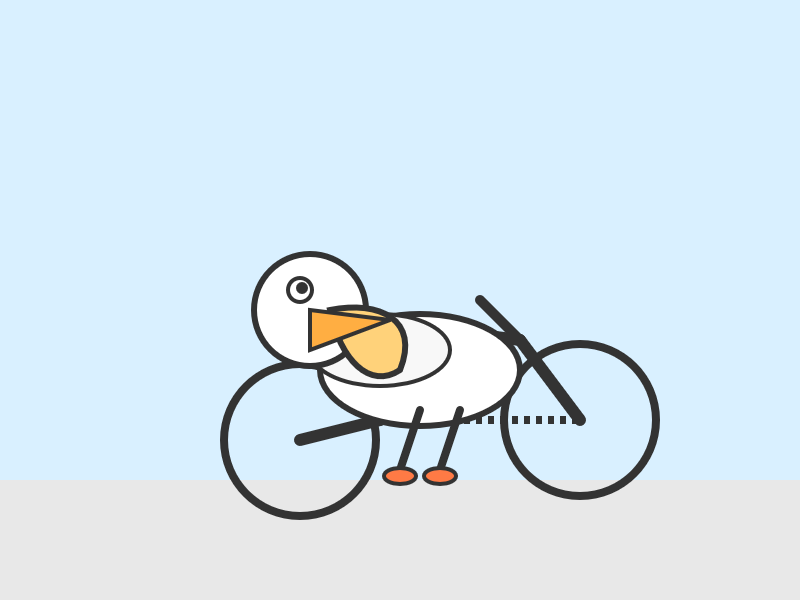
这是一只鹈鹕,是我使用 LM Studio 的18.16 GB 版本模型生成的:
我还用我的 llm-coding-agent 插件试了试,针对 Datasette 的全新检出运行,提示词为:
身份验证是如何工作的?
以下是回复,位于一长串显示它探索代码库时所有工具调用的记录末尾。我使用 llm-lmstudio 并应用了 此补丁 来运行,以升级其与 LLM 0.32 的兼容性。
我非常喜欢这个尺寸的模型,因为如果一台机器有 32 GB 或更多内存(我的有 128GB),它就能留出充足的空间同时运行其他应用程序。
Glimmer 是一个视觉模型,所以我让它描述这张图片:
llm -m lmstudio/meta/muse-glimmer -a https://static.inaturalist.org/photos/714731804/large.jpg 'describe image'
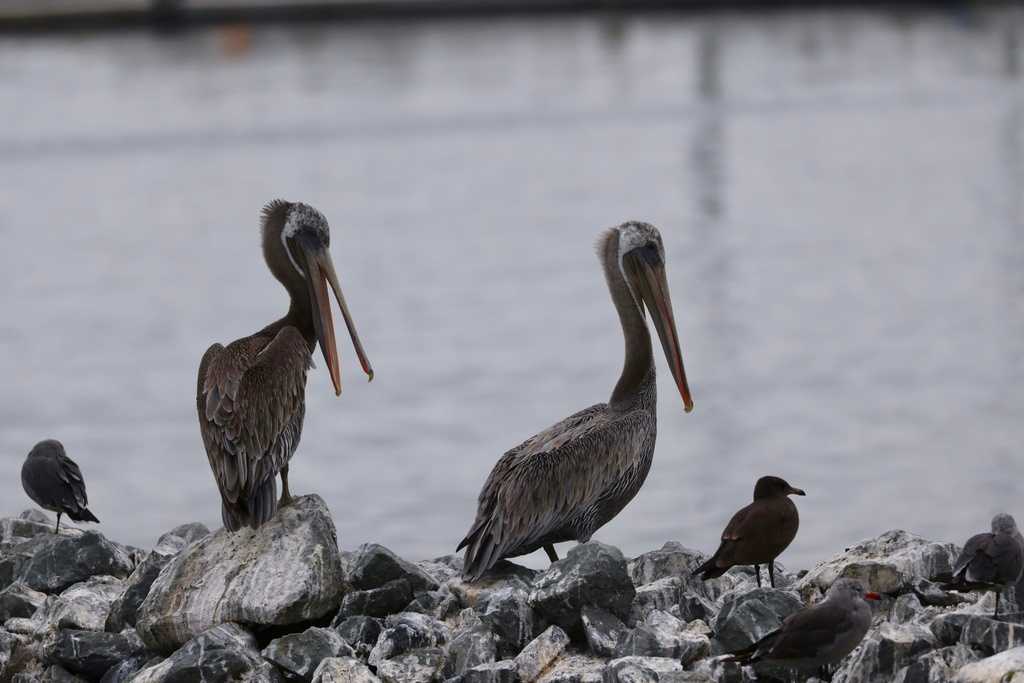
这张照片展示了一个岩石防波堤式的海岸线,在一个阴天,水面平滑呈灰色,背景虚化中有一条隐约的码头/栈桥线。 前景中,两只大型褐鹈鹕(Pelecanus occidentalis)栖息在杂乱的白灰色石块上。它们具有该物种特有的长而下弯的黄橙色喙,带有大喉囊,长而纤细的脖子,背部与翅膀上有斑驳的灰褐色羽毛。左侧的鹈鹕微微转向镜头,似乎在梳理羽毛或将喙靠在胸前;头顶和后颈可见一片淡白的斑块,并竖起一小撮羽冠。右侧的鹈鹕面向前方/右方,头抬起,喙指向下方和右侧,同样有淡色头部斑纹,翅膀上带有清晰可见的深色横斑。 两只鹈鹕周围的岩石间散落着一些更小的深色鸟类——灰褐色羽毛的海鸥/燕鸥类鸟。一只深色鸟坐在最左侧的岩石上,另一只棕色的鸟站在右侧鹈鹕的右边,一只带红色喙的灰色鸟在右下角前景,还有一只小深色鸟在画面的最右边缘。 整体光线平坦而漫射,使水面和天空呈现柔和、近乎单色的色调,与多岩石的纹理和鹈鹕细致的羽毛形成对比。构图将两只大鸟作为主导主体,以平静的水面和低矮的岩石栖息地为背景。
Via Hacker News
Tags: ai, generative-ai, llama, local-llms, llms, llm, vision-llms, meta, llm-release
同一事件的其他报道
- T2TechCrunch:AI(RSS)Meta 发布开源权重模型 Muse Glimmer,窥见扎克伯格个人超级智能愿景00:20
相关条目
精选DeepSeek V4 在 OpenRouter 上的代币份额翻倍,智能体工作负载成主要驱动力
DeepSeek V4 的快速采用表明市场对高性能、低成本推理模型的强烈偏好,尤其是智能体场景将重塑 AI 部署格局。
91
精选启用两项设置使ARC-AGI-3基准测试分数提升三倍
这项发现太关键了!它表明模型的性能不仅取决于训练,还取决于推理时的配置。对于AI工程师和研究者来说,这是一个必须注意的优化方向。特别是那些在资源受限设备上部署模型的团队,可能会因此找到低成本提升能力的方法。
91
精选GPT-5.6:前沿智能与前沿效率的融合
这条消息值得关注,因为它标志着大模型竞争从单纯拼参数转向拼效率。对于AI开发者和企业决策者来说,GPT-5.6意味着可以用更少预算获得更高性能,尤其适合那些被推理成本挡在门外的长上下文或Agent场景。OpenAI这一步,可能重新定义‘前沿’的标准。
91
精选LFM2.5-Encoder:面向CPU快速长上下文推理的新模型
这篇博文让我眼前一亮,因为它直接解决了大模型在CPU上跑长上下文的痛点。对于没有高端GPU的团队或个人开发者,LFM2.5-Encoder系列提供了可立即使用的开源方案。尤其推荐给做RAG、文档搜索或代码分析的朋友——现在用普通服务器就能处理百万级token的文档了。
91
精选GPT-Red:OpenAI通过自我对弈实现AI红队自动化,提升模型鲁棒性
GPT-Red 是红队测试从人工到自动化的里程碑,特别适合安全工程师和对齐研究者关注。它直接降低了测试成本,但也引发了对“自动攻击”本身的伦理讨论——值得所有关注AI治理的人深入思考。
91
精选OpenAI推出GPT-5.5生物漏洞赏金计划
这个计划值得关注,因为它首次将AI漏洞赏金制度拓展到生物安全领域,不仅为安全社区提供了新的研究方向,也为AI风险治理提供了实际演练场。对模型安全研究者、生物安全专家以及关心AI双重用途的从业者尤其重要。
91
精选vLLM推出原生速度Transformers建模后端,大幅提升推理性能
这项更新对于AI工程团队非常关键:无需格式转换意味着能更快地迭代模型,而2-5倍的速度提升直接降低GPU成本。如果你正在做LLM在线服务或者批量推理,这几乎是必读的技术更新。
90
精选Google DeepMind 发布手语转文本模型 SL2T,助力聋人用户
这则消息的意义不仅在于技术突破,更在于AI开始真正关注边缘群体的需求。对开发者而言,SL2T的架构思路和技术路径值得深入研究;对无障碍倡导者来说,这是推动行业标准的重要案例。