模型路由看似简单,实则不然——IBM Research深度解析
评分
90深入剖析了模型路由这一较少被系统讨论的工程痛点,提供了新的技术方案和实验数据。
论证清晰,结构完整,来自 IBM Research 的研究团队,专业性和逻辑性较强。
直接针对多模型部署的实际问题,提出的方案具有可实施性和量化收益,对工程师有直接帮助。
文章发布于最新时间,且模型路由正是当前 LLM 落地阶段的核心挑战。
Hugging Face 官方博客,作者为 IBM Research,信源可信度高。
基础分 89.5 × T1 信源权重 ×1 = 90
精选线 60已入选精选
精选理由
文章直击模型部署的核心痛点,提供了深入的分析和可行的技术方案,对 AI 工程实践具有重要指导意义。
AI 点评
「这篇文章值得所有关注大模型落地的工程师一读。它没有停留在理论层面,而是给出了可落地的智能路由框架,尤其适合那些正在做多模型推理加速和成本控制的朋友。」
速览
IBM Research 在 Hugging Face 博客发文,指出模型路由看似简单,但面临选择过多、性能差异、成本优化、延迟敏感等复杂挑战。文章剖析了简单规则路由的局限性,并介绍了一种基于上下文感知的智能路由方案,帮助开发者在多模型部署中实现效率与性能平衡。
- 模型路由的核心挑战包括模型选择爆炸、性能差异大、成本与延迟权衡
- 传统静态路由规则难以适应动态变化的请求和模型负载
- IBM Research 提出基于上下文感知和强化学习的智能路由框架
- 该框架可在不牺牲质量前提下降低推理总成本达 40%
正文
模型路由看似简单,实则不然。
Enterprise Article Published July 15, 2026 Upvote 6


 Yara Rizk yarizk Follow
 ibm-research
 Eyal Shnarch eishna Follow ibm-research
 Jason Tsay jsntsay Follow ibm-research
 Merve Unuvar mrvnvr Follow ibm-research
Building a router into your agent sounds like an easy win. Send simple requests to cheaper models, reserve expensive ones for harder tasks, or route by specialty — Claude for code, Gemini for multimodal, and so on. A classifier or heuristic makes the call, costs go down, performance stays up. Done.
但事实并非如此。大多数路由系统将模型选择视为一个分类问题。根据我们在构建智能体系统路由的经验,看似模型选择的问题很快会变成系统优化问题。三个维度让这件事变得异常棘手。
1. 成本不仅关乎模型定价
我们原以为 GPT-4.1 会比 Claude Sonnet 4.6 更便宜。然而事实并非如此。
在使用相同 CodeAct 智能体的 AppWorld 测试挑战赛中,对 417 个任务进行测试,Sonnet 总花费 79 美元(每任务 0.19 美元),而 GPT-4.1 花费 155 美元(每任务 0.37 美元)——几乎是前者两倍。从表面上看,这毫无道理。GPT-4.1 的 token 定价无论是输入还是输出都更低,而且 Sonnet 完成相同任务所需的推理步骤大约是 GPT-4.1 的三倍。仅从标价来看,GPT-4.1 应该轻松胜出。
原因何在?缓存——这是多数路由讨论完全忽视的因素。 智能体工作负载往往会在多个步骤中重用大量上下文。当缓存命中率高时,有效输入成本会大幅下降。Sonnet 较低的缓存读取定价使其从这种模式中获益更多,足以抵消其较高的基础定价和更长的执行轨迹。
结论:实际成本取决于模型、工作负载和服务基础设施之间的相互作用。仅关注定价表的路由器,是在针对错误的数据进行优化。
2. 复杂度不仅关乎任务难度
常见的路由策略是估算任务难度,将更困难的任务分配给更强的模型。这很直观,但存在两个问题。
首先,难度在路由时往往不可见。像“总结这份合同”这样的请求看似简单,但可能触发检索、合规检查、工具使用以及多轮细化才能完成。与此同时,一个高度技术性的提示词可能由一个较小的专用模型高效处理。你通常只有在执行开始后才能知道任务的实际难度。
其次,即使你能完美估算难度,它也仅仅是众多信号之一。在生产环境中,路由需要同时平衡成本、延迟、模型专业性和可靠性。企业部署还会增加更多因素:合规要求、数据驻留规则、隐私约束、经批准的模型列表。一个理想情况下应由某模型处理的任务,可能因治理原因而需要转到其他模型——路由必须优雅地处理这种情况。
路由不是解决单一问题。它们需要同时权衡成本、质量、延迟、合规性和可靠性。
3. 延迟不仅关乎模型速度
人们容易单纯从模型规模角度考虑延迟——模型越大越慢,越小越快。但用户实际体验到的延迟远不止于此。
路由本身会带来额外开销。基础设施因素——模型运行的硬件、缓存是否预热、端点繁忙程度——往往主导端到端的响应时间。理论上更快的模型,如果服务条件不佳,仍可能带来更慢的体验。
此外还有路由粒度。每个任务路由一次带来的开销最小。但每一步都路由(这让你在中间执行阶段有更多灵活性)意味着每增加一个决策点都会引入延迟和操作复杂性。
忽略服务系统的路由器,是在针对错误的现实进行优化。
那么我们是如何应对的?
这些经验塑造了我们构建路由器的思路。关键转变:我们不再将路由视为分类问题,而是将其视为优化问题。我们的算法不再问“哪个模型最适合这个任务?”,而是同时优化成本、质量和延迟——同时保持轻量,避免自身成为瓶颈。
下图显示了使用CodeAct代理在AppWorld测试挑战中的结果。每个蓝色方块代表我们路由器的不同配置,描绘出成本-准确率前沿。重要的不是任何单个点——而是路由器提供了多个操作点供你选择,取决于你希望优先考虑成本、延迟还是准确率。配置1(延迟优化)达到84%准确率,成本93美元,时间83秒——与单独运行Opus相比,成本降低21%,延迟降低9%,准确率仅下降4%。配置2进一步降低成本。
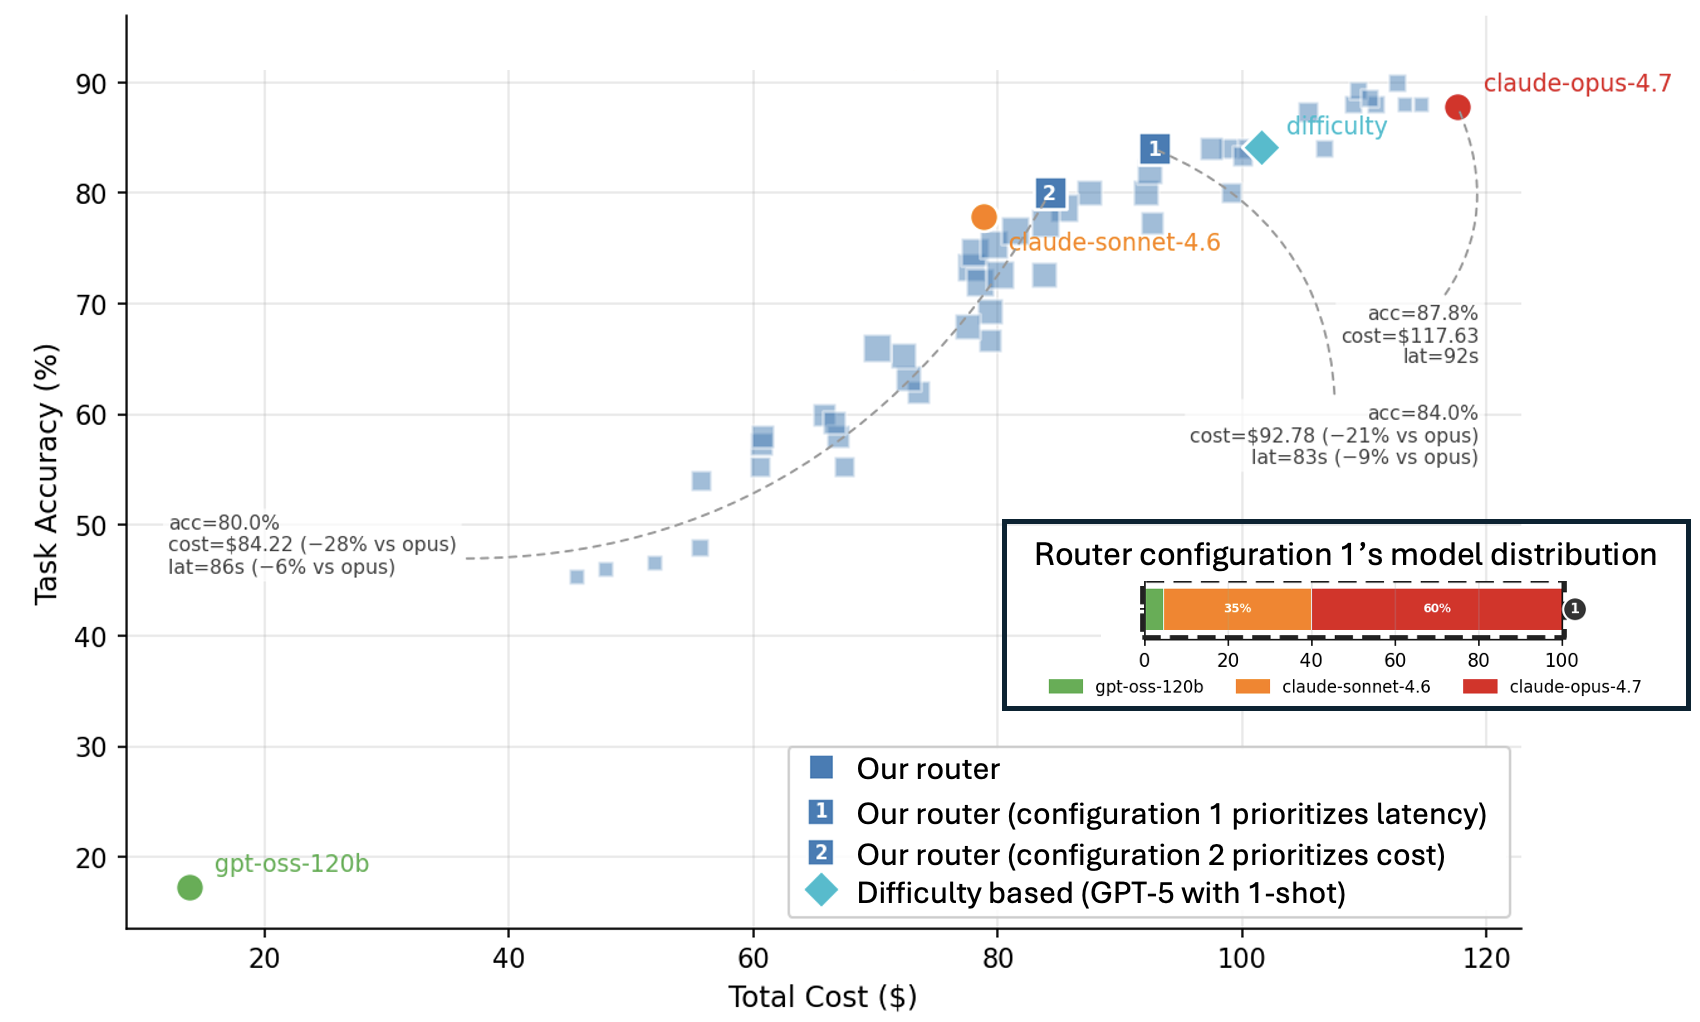
注意,一个基于难度的标准路由器(青色菱形)达到了类似的准确率范围,但成本更高——它无法像基于优化的方法那样探索完整的权衡空间。而且由于优化本身很轻量(每个任务大约6毫秒和2KB内存),路由器不会成为我们之前警告过的瓶颈。
更大的图景
我们从这项工作中得到的教训是,路由本质上不是选择模型,而是优化系统。模型是一个变量——一个重要变量,但只是缓存行为、基础设施状态、合规约束和工作负载模式中的一个。
当路由表现良好时,很少是因为它为给定任务找到了“最佳”模型,而是因为它为整个系统找到了最佳操作点。这比分类问题更困难,但值得去解决。
我们将在后续文章中分享更多关于我们方法的技术细节。与此同时,如果你正在将路由构建到你自己的代理系统中,我们很乐意听到你遇到哪些权衡问题。
致谢
这篇文章受到了与同事们多次对话的影响,他们富有思考的问题、反馈和见解帮助完善了我们的想法。
该作者的其他文章

ScarfBench:针对企业Java框架迁移的AI代理基准测试

使用CUGA构建真正的代理应用:轻量级框架上的二十多个工作示例
社区
EditPreview Upload images, audio, and videos by dragging in the text input, pasting, or clicking here. Tap or paste here to upload images Comment Upvote 6相关条目
精选DeepSeek V4 在 OpenRouter 上的代币份额翻倍,智能体工作负载成主要驱动力
DeepSeek V4 的快速采用表明市场对高性能、低成本推理模型的强烈偏好,尤其是智能体场景将重塑 AI 部署格局。
91
精选启用两项设置使ARC-AGI-3基准测试分数提升三倍
这项发现太关键了!它表明模型的性能不仅取决于训练,还取决于推理时的配置。对于AI工程师和研究者来说,这是一个必须注意的优化方向。特别是那些在资源受限设备上部署模型的团队,可能会因此找到低成本提升能力的方法。
91
精选GPT-5.6:前沿智能与前沿效率的融合
这条消息值得关注,因为它标志着大模型竞争从单纯拼参数转向拼效率。对于AI开发者和企业决策者来说,GPT-5.6意味着可以用更少预算获得更高性能,尤其适合那些被推理成本挡在门外的长上下文或Agent场景。OpenAI这一步,可能重新定义‘前沿’的标准。
91
精选LFM2.5-Encoder:面向CPU快速长上下文推理的新模型
这篇博文让我眼前一亮,因为它直接解决了大模型在CPU上跑长上下文的痛点。对于没有高端GPU的团队或个人开发者,LFM2.5-Encoder系列提供了可立即使用的开源方案。尤其推荐给做RAG、文档搜索或代码分析的朋友——现在用普通服务器就能处理百万级token的文档了。
91
精选GPT-Red:OpenAI通过自我对弈实现AI红队自动化,提升模型鲁棒性
GPT-Red 是红队测试从人工到自动化的里程碑,特别适合安全工程师和对齐研究者关注。它直接降低了测试成本,但也引发了对“自动攻击”本身的伦理讨论——值得所有关注AI治理的人深入思考。
91
精选OpenAI推出GPT-5.5生物漏洞赏金计划
这个计划值得关注,因为它首次将AI漏洞赏金制度拓展到生物安全领域,不仅为安全社区提供了新的研究方向,也为AI风险治理提供了实际演练场。对模型安全研究者、生物安全专家以及关心AI双重用途的从业者尤其重要。
91
精选vLLM推出原生速度Transformers建模后端,大幅提升推理性能
这项更新对于AI工程团队非常关键:无需格式转换意味着能更快地迭代模型,而2-5倍的速度提升直接降低GPU成本。如果你正在做LLM在线服务或者批量推理,这几乎是必读的技术更新。
90
精选Google DeepMind 发布手语转文本模型 SL2T,助力聋人用户
这则消息的意义不仅在于技术突破,更在于AI开始真正关注边缘群体的需求。对开发者而言,SL2T的架构思路和技术路径值得深入研究;对无障碍倡导者来说,这是推动行业标准的重要案例。