月之暗面发布 Kimi K3:2.8 万亿参数开源模型,性能超越多数竞品
评分
76提供了 K3 详细参数、定价、基准对比及实际测试结果,信息增量较高
作者基于第一手测试和第三方评测,分析深入且客观
对开发者选型有参考价值,但鹈鹕测试的意义有限
发布时间与博客日期一致,为最新动态
Simon Willison 是权威的 AI 技术博客作者,信源可信度高
基础分 84.5 × T2 信源权重 ×0.9 = 76
精选线 70已入选精选
精选理由
基于作者亲测与第三方评测,信息详实且具有实操参考价值
AI 点评
「Kimi K3 的发布标志着中国 AI 实验室在超大参数开源模型上的突破,2.8T 参数和承诺的开源时间表令人期待。对于开发者来说,定价是选择的关键因素——虽然 $3/$15 比前代贵不少,但相比 Opus 4.8 仍然便宜一半。不过,实际测试显示其推理 token 消耗巨大,长期使用成本可能超预期。值得关注的是它在前端代码领域的表现超越 Fable 5,这可能暗示其在代码生成方面的独特优势。」
速览
月之暗面(Moonshot AI)于 2026 年 7 月 16 日发布 Kimi K3,宣称拥有 2.8 万亿参数,是目前最大的开源模型。模型在多项基准测试中超越 Claude Opus 4.8 和 GPT-5.5,仅次于 Claude Fable 5 和 GPT-5.6 Sol。定价为每百万输入 token 3 美元、输出 token 15 美元,高于前代 K2.6,但仍低于 Opus 4.8。作者 Simon Willison 通过自创的“鹈鹕骑自行车”测试发现,K3 推理开销巨大,单次生成成本 25 美分,但视觉能力出色。该模型计划于 2026 年 7 月 27 日开源权重。
- 参数规模 2.8T,是目前最大的开源模型,计划于 7 月 27 日开源
- 自报基准超越 Claude Opus 4.8 和 GPT-5.5,仅次于顶级模型
- 定价显著高于前代,成本约 $3/$15 每百万 token,但仍比 Opus 4.8 便宜一半
- 实际测试显示推理 token 消耗巨大(13k+),单次鹈鹕 SVG 生成成本 25 美分
正文
中国AI实验室Moonshot AI今天早上发布了Kimi K3,称其为“迄今为止最强模型,拥有2.8万亿参数”。目前可通过其网站和API使用,但承诺在“2026年7月27日”前开放权重发布。
Moonshot称这是首个“开放3T级模型”(我猜他们是将2.8万亿四舍五入到3万亿),从DeepSeek的1.6T v4 Pro手中夺得桂冠。他们的自报基准测试显示,K3大部分击败了Claude Opus 4.8 max和GPT-5.5 high,但输给了Claude Fable 5和GPT-5.6 Sol。
以下是来自Artificial Analysis报告中关于该模型的一些亮点:
- “在我们私有的长期知识工作评估中,Kimi K3的总Elo达到1547,比Kimi K2.6高出732分,仅次于Claude Fable 5。”
- “每任务成本($0.94)与GPT-5.6 Sol($1.04)相近,约为Opus 4.8($1.80)的一半,但高于开放权重同类产品”
- “Kimi K3在Artificial Analysis Intelligence Index上的token使用量显著下降,输出token比K2.6少了21%。”
该模型现在也是Arena.ai的Frontend Code arena上领先的模型,甚至超过了Claude Fable 5。
新模型的价格引人注目:每百万输入token $3,每百万输出token $15,使其与Anthropic的Claude Sonnet系列处于同一水平,并成为迄今为止中国AI实验室发布的最昂贵模型。相比他们早期的模型如Kimi K2.6(价格为$0.95/$4)有了大幅提升。2.8万亿参数也是那个1T模型的两倍多。
但是它在鹈鹕测试中表现如何?
我使用OpenRouter(以避免注册Moonshot API密钥)和llm-openrouter插件生成了一个骑自行车的鹈鹕的SVG:
llm -m openrouter/moonshotai/kimi-k3 'Generate an SVG of a pelican riding a bicycle'
这是转录内容。它看起来是这样的:
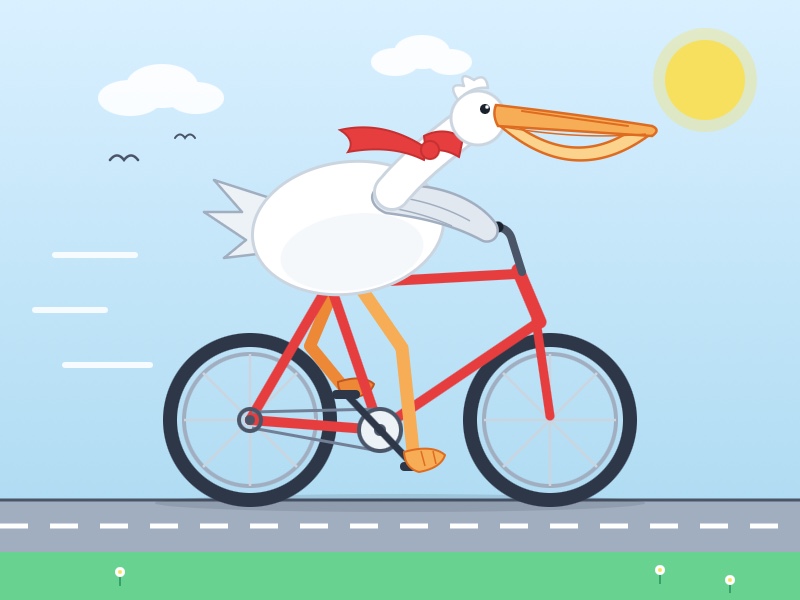
那个鹈鹕测试使用了95个输入token和16,658个输出token(其中13,241个是推理token),总成本为25美分!
由于K3接受图像输入,我将上面生成的SVG输入给它(使用我的alt文本提示),得到了(花费0.6美分):
卡通插图:一只白色鹈鹕戴着红色围巾,沿着一条带有白色虚线的灰色道路骑红色自行车;鹈鹕有橙色的大喙和带蹼的橙色脚在蹬踏板,身后有白色运动线条;背景是浅蓝色天空缀着白云,黄色太阳,两只黑色小鸟飞翔,前景是绿色草地和白色小野花。
我们能从鹈鹕中学到什么?
我的生成一个骑自行车的鹈鹕的SVG测试现在已经21个月了。它从来都不是一个特别好的基准测试。起初它只是一个关于比较这些模型有多么荒谬困难的玩笑,但在第一年里,它却与模型的实际表现有了惊人的相关性。
这种联系现已基本断裂。GPT-5.6和Claude Fable 5的鹈鹕测试结果已被GLM-5.2超越,尽管我很喜欢GLM,但我不认为它属于Fable级别的模型。
(我仍然不相信实验室会为了基准测试而训练——如果是这样,我会期待更好的结果。不过Gemini有可能针对任何动物骑交通工具的组合进行了优化!)
鹈鹕测试的最大局限性在于它完全没有触及当今模型最重要的能力:智能化工具调用以及在对话长度增长时可靠操作工具的能力。
所以不要再用鹈鹕来比较模型了!
尽管如此,我自己运行基准测试仍然获得了相当多的价值。
首先,它是一个实际尝试模型的强制机制。如果我向你展示一只pelican,那就意味着我成功通过它运行了一个提示。如果模型有官方API,我会使用它;如果它是开放权重的(并且足够小,适合128GB M5 MacBook Pro),我会尝试在自己的机器上运行,通常通过llama.cpp或LM Studio或Ollama。我经常使用OpenRouter,因为它通常提供官方API的代理,而无需我获取新的API密钥。
我的大多数pelican是使用我的LLM CLI工具生成的,这有助于鼓励我确保最新模型被该工具支持(通过其插件之一)。
但更重要的是,即使是单个提示“Generate an SVG of a pelican riding a bicycle”这样的行为也能揭示有趣的模型特征。
考虑今天Kimi K3的结果。运行这些简单的提示有助于强调关于该模型的几个要点。
- 它目前只有一个推理努力级别,“max”——它确实如此。该模型消耗了13,241个推理token来输出3,417个response token。这很昂贵——这只pelican花费了25美分!
- 提示语“Generate an SVG of a pelican riding a bicycle”如何累计到95个输入token?OpenAI的tokenizer计数为10,Anthropic的计数为Opus 4.6的10个,Opus 4.7的30个,Sonnet 5/Fable 5的25个。提示“hi”给Kimi K3计数了86个token,表明可能存在85个token的隐藏系统提示。不过它拒绝泄露它。
- 视觉功能很好:它生成的替代文本非常好。
K3目前只有一个思考努力级别,但我最近从在不同努力级别上运行相同的pelican提示中获得了相当多的价值,以快速了解它们的影响。例如,这是我的关于GPT-5.6模型族的矩阵。
但实际上,我从pelican测试中获得的主要是:
- 这是一个用于提示模型的“hello world”练习
- 对简单任务的粗略成本和推理估计
- 确认模型可以输出有效的SVG,并具有基本的几何和空间意识。对于在我的笔记本电脑上运行的较小模型来说,这是一个更大的问题。
- 比较同一模型家族中不同版本之间的pelican仍然很有趣。K3的pelican相对于Kimi 2.5有显著改进。
- 这是我可以分享的东西,证明我已经尝试过了。另外,带有pelican的评论在Hacker News上已经成为一种传统,每当我迟到时,都会有人问它在哪!
标签:ai,generative-ai,llms,llm-pricing,pelican-riding-a-bicycle,llm-release,ai-in-china,artificial-analysis,moonshot,kimi
同一事件的其他报道
- T2TechCrunch:AI(RSS)月之暗面Kimi 3预计2-3万亿参数,缩小与Anthropic Opus 4.8差距22:26
相关条目
精选DeepSeek V4 在 OpenRouter 上的代币份额翻倍,智能体工作负载成主要驱动力
DeepSeek V4 的快速采用表明市场对高性能、低成本推理模型的强烈偏好,尤其是智能体场景将重塑 AI 部署格局。
91
精选启用两项设置使ARC-AGI-3基准测试分数提升三倍
这项发现太关键了!它表明模型的性能不仅取决于训练,还取决于推理时的配置。对于AI工程师和研究者来说,这是一个必须注意的优化方向。特别是那些在资源受限设备上部署模型的团队,可能会因此找到低成本提升能力的方法。
91
精选GPT-5.6:前沿智能与前沿效率的融合
这条消息值得关注,因为它标志着大模型竞争从单纯拼参数转向拼效率。对于AI开发者和企业决策者来说,GPT-5.6意味着可以用更少预算获得更高性能,尤其适合那些被推理成本挡在门外的长上下文或Agent场景。OpenAI这一步,可能重新定义‘前沿’的标准。
91
精选LFM2.5-Encoder:面向CPU快速长上下文推理的新模型
这篇博文让我眼前一亮,因为它直接解决了大模型在CPU上跑长上下文的痛点。对于没有高端GPU的团队或个人开发者,LFM2.5-Encoder系列提供了可立即使用的开源方案。尤其推荐给做RAG、文档搜索或代码分析的朋友——现在用普通服务器就能处理百万级token的文档了。
91
精选GPT-Red:OpenAI通过自我对弈实现AI红队自动化,提升模型鲁棒性
GPT-Red 是红队测试从人工到自动化的里程碑,特别适合安全工程师和对齐研究者关注。它直接降低了测试成本,但也引发了对“自动攻击”本身的伦理讨论——值得所有关注AI治理的人深入思考。
91
精选OpenAI推出GPT-5.5生物漏洞赏金计划
这个计划值得关注,因为它首次将AI漏洞赏金制度拓展到生物安全领域,不仅为安全社区提供了新的研究方向,也为AI风险治理提供了实际演练场。对模型安全研究者、生物安全专家以及关心AI双重用途的从业者尤其重要。
91
精选vLLM推出原生速度Transformers建模后端,大幅提升推理性能
这项更新对于AI工程团队非常关键:无需格式转换意味着能更快地迭代模型,而2-5倍的速度提升直接降低GPU成本。如果你正在做LLM在线服务或者批量推理,这几乎是必读的技术更新。
90
精选Google DeepMind 发布手语转文本模型 SL2T,助力聋人用户
这则消息的意义不仅在于技术突破,更在于AI开始真正关注边缘群体的需求。对开发者而言,SL2T的架构思路和技术路径值得深入研究;对无障碍倡导者来说,这是推动行业标准的重要案例。