Claude Opus 5 发布:长运行代理与编码能力大幅提升
评分
83官方披露了新模型的详细能力提升方向,此前只有传闻,因此信息增量较高。
官方新闻稿内容简洁明确,但技术细节有限,综合质量良好。
对于开发者和企业用户选择自动化模型具有直接参考意义。
刚刚发布的新闻,时效性满分。
Anthropic 官方渠道发布,可信度高。
基础分 82.5 × T1 信源权重 ×1 = 83
精选线 60已入选精选
精选理由
该信息直接来自官方,内容明确且及时,对于关注 AI 模型迭代的专业读者有很高的参考价值。
AI 点评
「我认为这次升级最大的亮点在于对长运行代理的优化,这直接回应了业界对 AI 自动任务执行可靠性的迫切需求。如果你正在构建需要持续数小时的自动化流程,Opus 5 值得重点测试。不过要注意,具体效果还需结合实际场景验证。」
速览
Anthropic 正式发布 Claude Opus 5,作为 Opus 系列的阶跃性升级,该模型针对长时间运行的代理任务进行优化,同时在代码生成、理解及专业工作处理上取得显著进步,旨在赋能更复杂的自动化工作流与企业级应用。
- Opus 5 是 Opus 系列的“阶跃变化”升级,重点强化长运行代理的稳定性与效率。
- 在编码任务(代码生成、调试、理解)和专业工作(文档撰写、分析)上表现显著提升。
- 面向企业级自动化场景,可支持持续数小时的复杂代理任务。
正文
介绍 Claude Opus 5
Jul 24, 2026
Claude Opus 5 现已可用。这是一款深思熟虑且积极主动的模型,其智能水平接近 Claude Fable 5 的前沿水平,而价格仅为后者的一半。
在编码和知识工作评估中,如 Frontier-Bench 和 GDPval-AA,Opus 5 是新的最先进模型,但在网络安全任务上仍落后于 Mythos 5。
Opus 5 旨在日常使用:它比其他模型更高效。它是 Claude Max 上的新默认模型,也是 Claude Pro 上最强的模型。
性能与成本效益
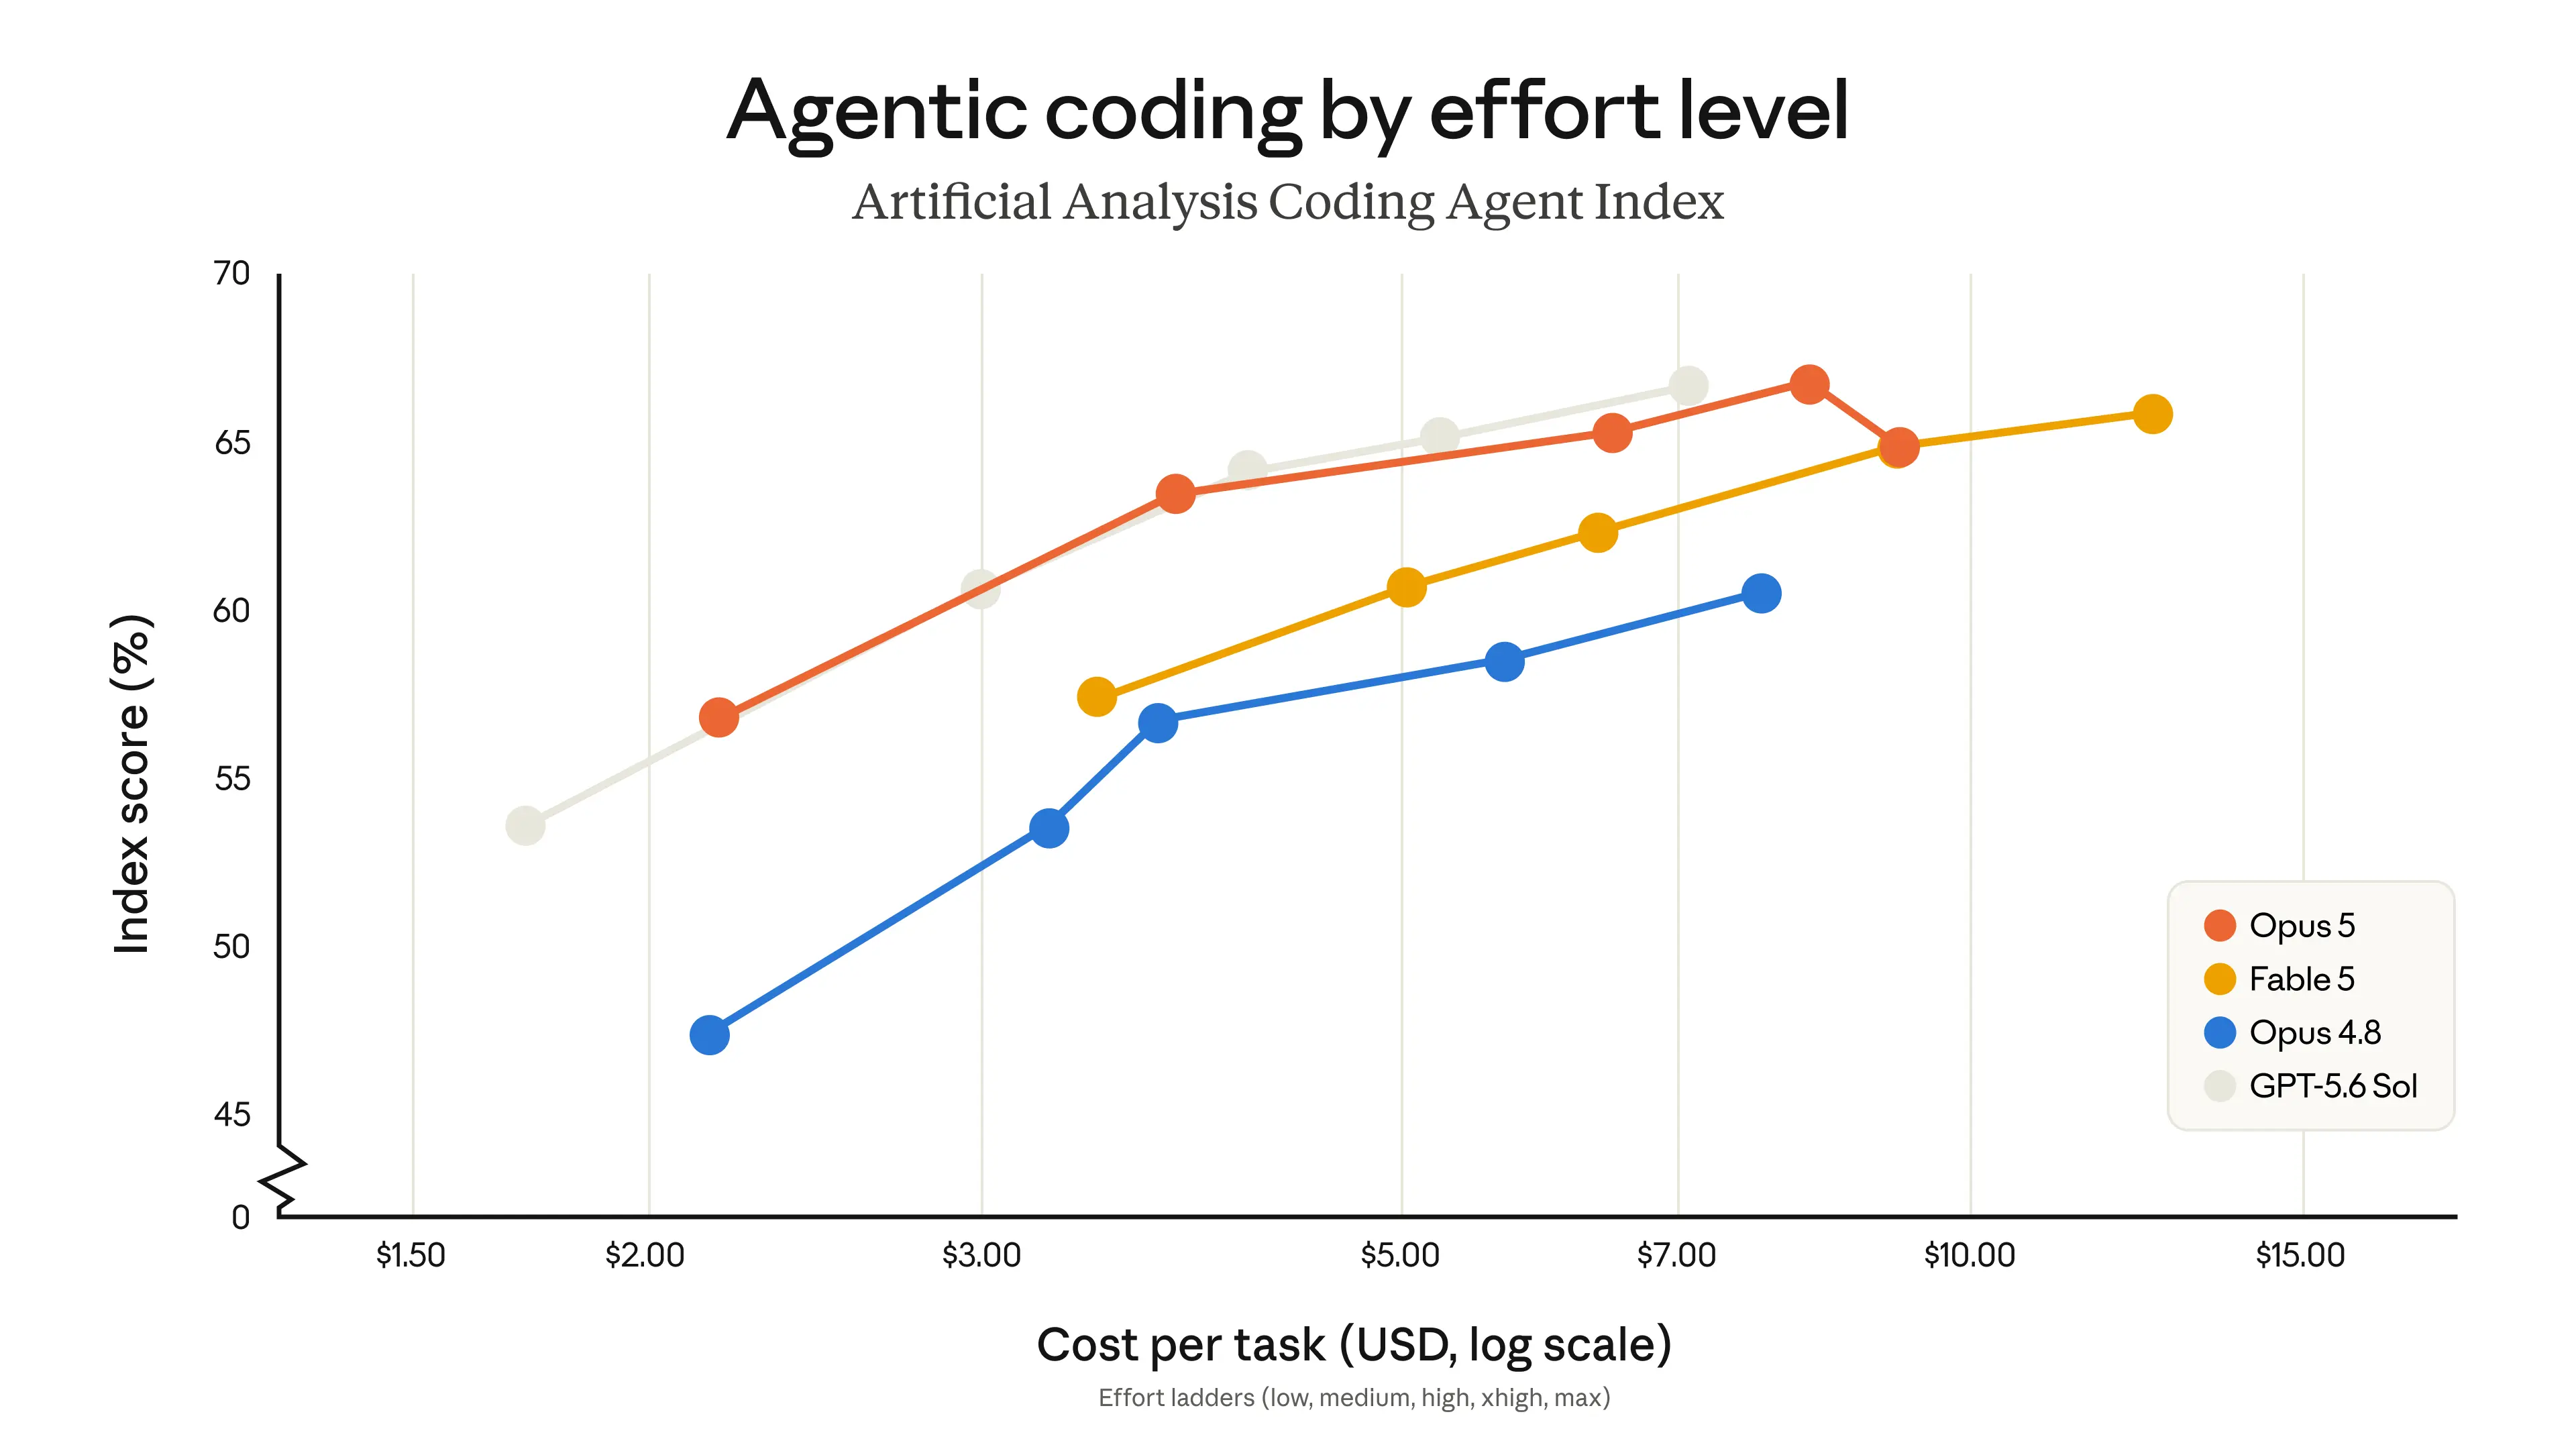
Claude Opus 5 在成本与其前身 Opus 4.8 相同的情况下,性能大幅提升。本节图表展示了性能如何根据模型的努力程度设置而变化,客户可利用该设置在智能性上进行优化,或节省令牌以获得更快、更便宜的结果。
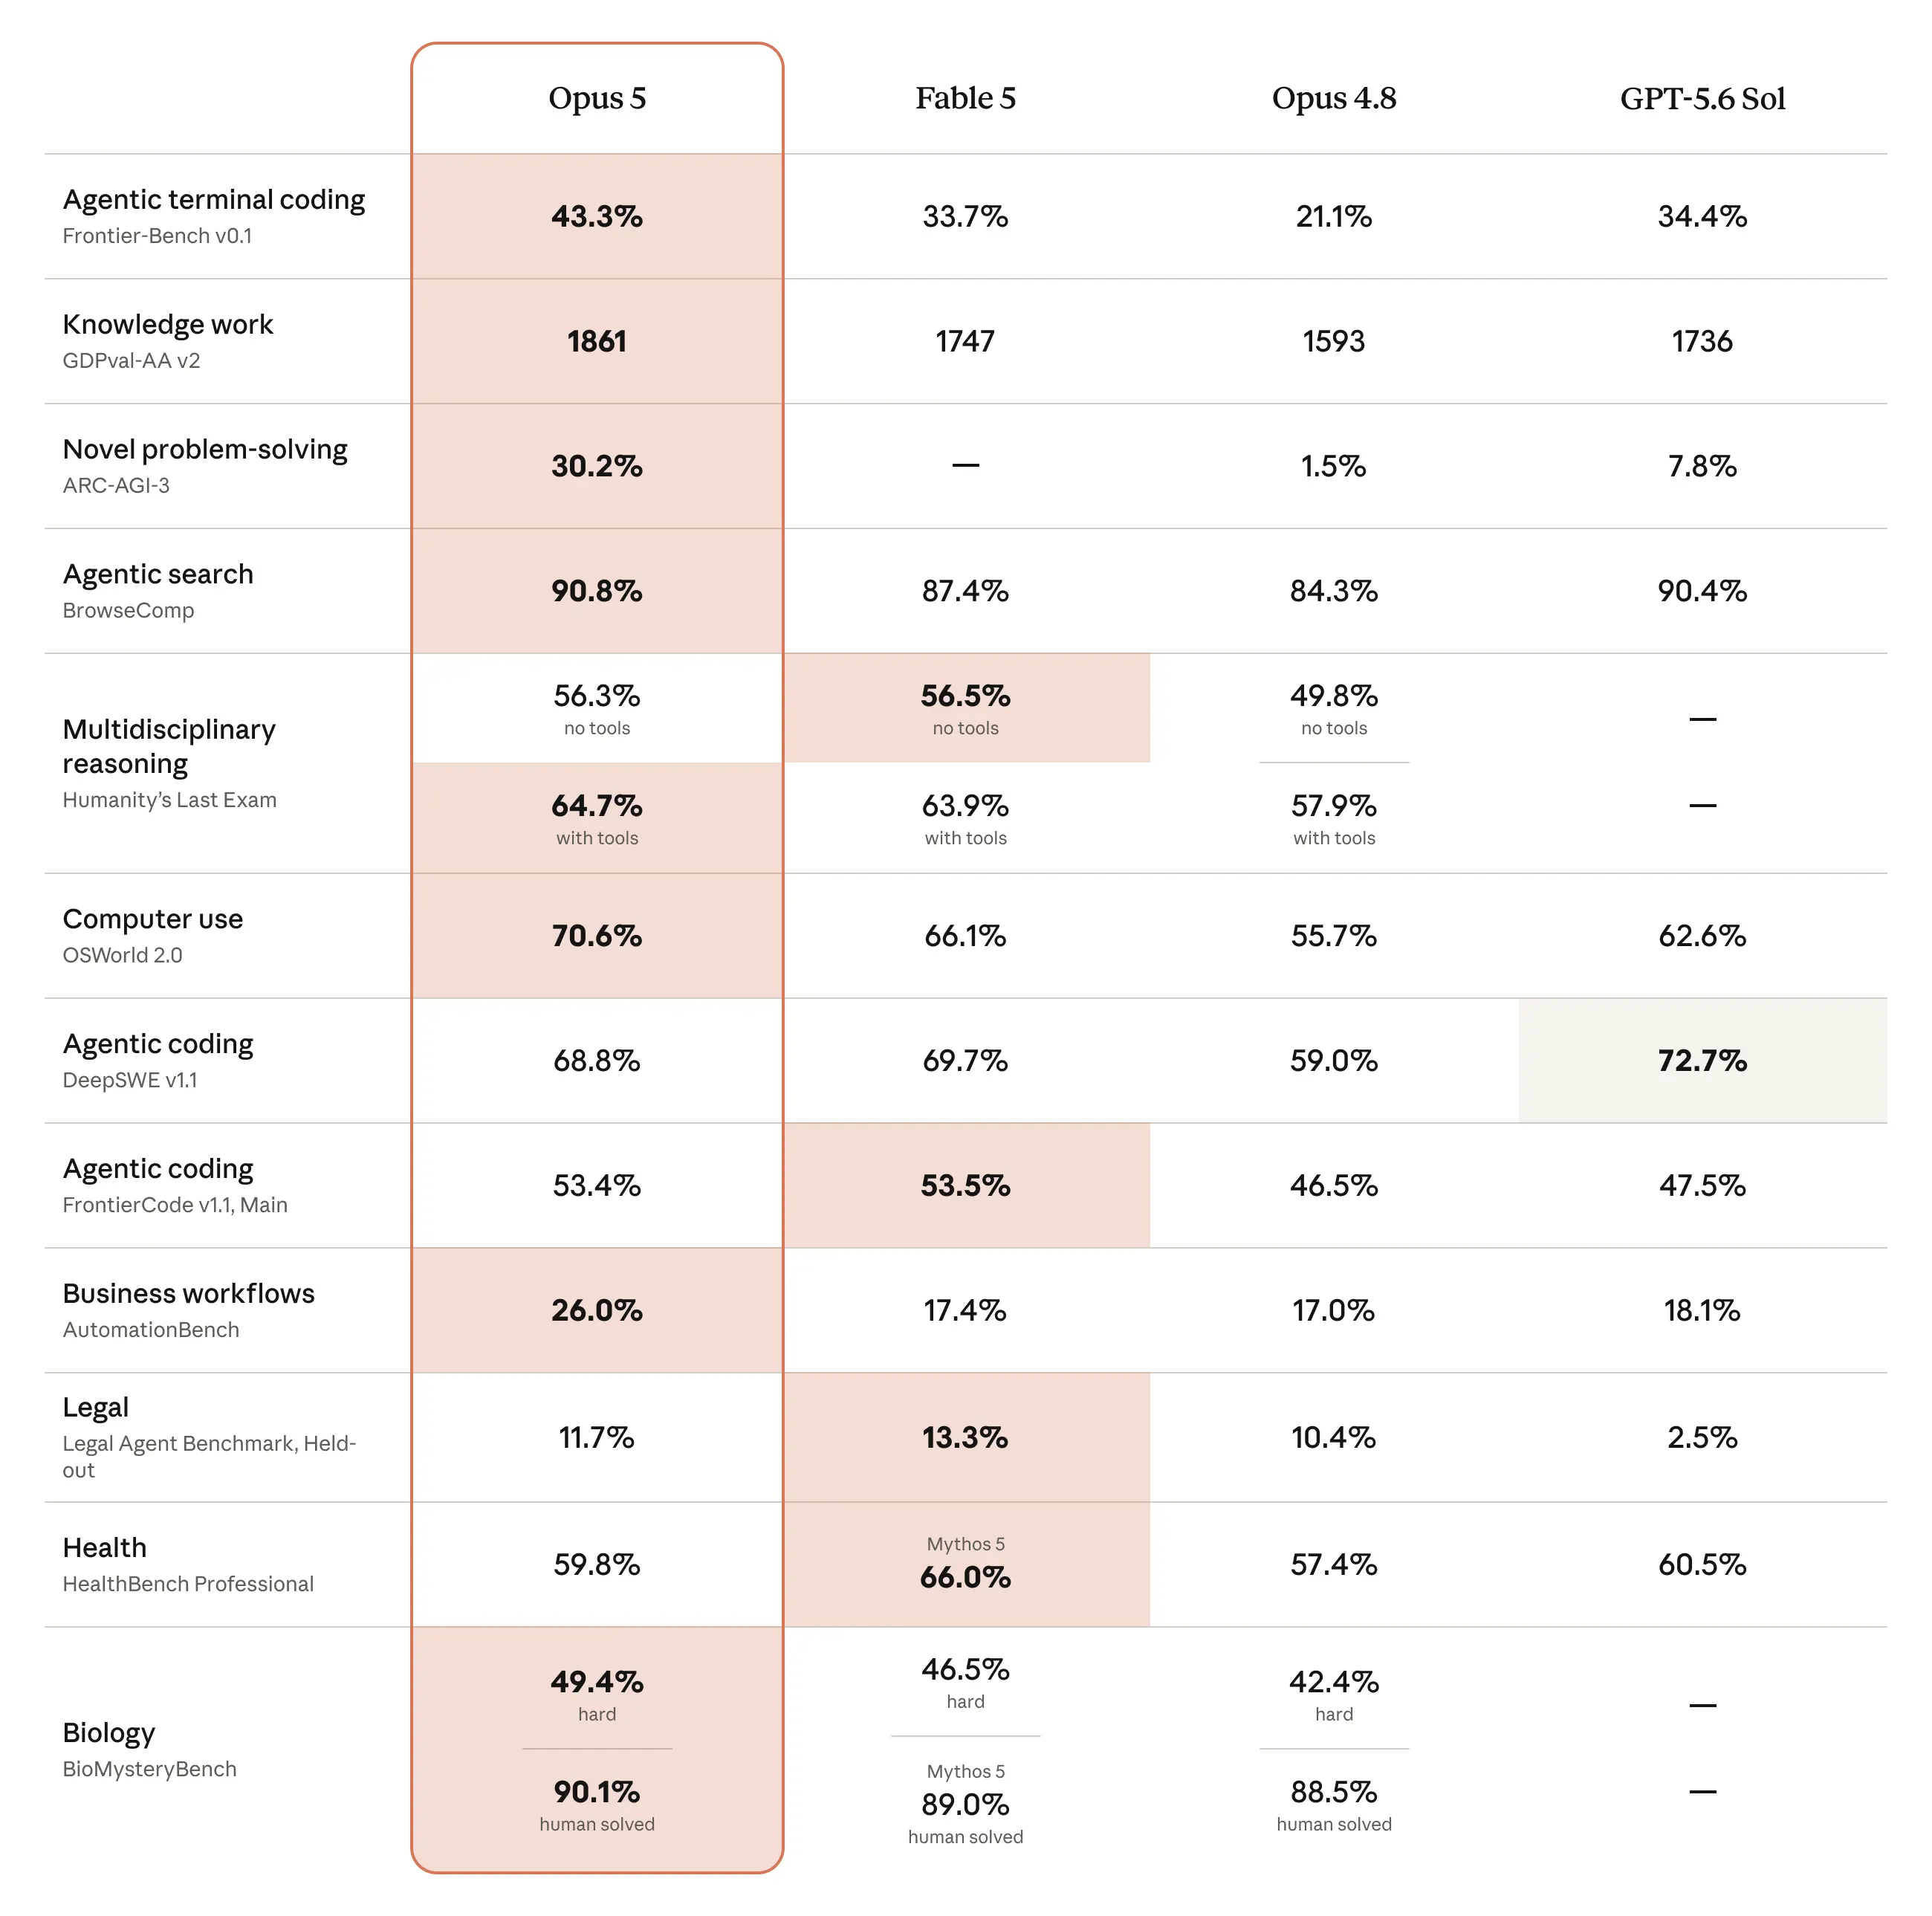
Opus 5 在重要的软件工程任务上表现出色。例如,在 Frontier-Bench v0.1, Opus 5 超越了所有其他模型,并且以更低的每次任务成本实现了 Opus 4.8 两倍以上的性能。在 CursorBench 3.2 上,在最大努力设置下,该模型的表现只比 Fable 5 的最高得分低 0.5%,但每次任务成本只有一半;而且,在 high、xhigh 和 max 努力设置下,它都能在给定成本下实现比其他所有模型更高的性能。
Frontier-Bench v0.1CursorBenchAA Coding Agent Index

我们在知识工作和问题解决任务上看到了类似的结果。例如:
- 在 ARC-AGI 3 上,这是一个模型必须解决新问题的评估,Opus 5 的得分是次优模型的三倍。
- 在 Zapier AutomationBench 上,该评估衡量模型是否能从头到尾完成业务任务,Opus 5 的通过率是次优模型的 1.5 倍左右,且每次任务成本相同。即使在最低努力设置下,Opus 5 也能通过比任何其他模型都多的任务。
- 在 OSWorld 2.0 上,这是一个计算机使用基准测试,Opus 5 在任何给定成本下都优于其他所有模型,以略高于三分之一成本就超越了 Fable 5 的最佳结果。
它也是我们在多项相关评估中最好且最具成本效益的模型:
ARC-AGI 3GDPval-AA v2OSWorld 2.0HLEAutomationBenchDeepSearchQA


Opus 5 在科学研究方面相较于 Opus 4.8 有显著改进。在我们所有的生命科学评估中,包括结构生物学、有机化学和生物信息学等主题,它都表现出比 Opus 4.8 更好的性能。其改进在有机化学任务上最为显著,例如从光谱数据推断分子结构(在我们的内部基准测试中,它比 Opus 4.8 高出 10.2 个百分点),以及蛋白质相关任务,例如预测蛋白质序列变异如何影响其功能(在此方面,它高出 7.7 个百分点)。
最后,Opus 5 能够生成更强的视觉输出:
Wind tunnelCell artifact与 Claude Opus 5 合作
Claude Opus 5 在验证自身工作并仔细迭代直至成功方面要强大得多。在评估和早期访问测试中,我们和用户发现了许多 Opus 5 的主动性和彻底性的例子:
- 在一个 Frontier-Bench 任务中,Opus 5 被给予一张机器零件图纸,并被要求编写代码将其重建为 3D FreeCAD 模型。然而,在这个任务中,模型被故意限制了无法直接 查看 图纸。Opus 5 的回应是编写自己的计算机视觉管线,从原始像素中提取几何形状,然后重建了整个机器零件。它反复成功完成了这一任务;在相同设置下,没有其他竞争模型能在五次尝试后解决该问题。
- 给定一个流行的开源包管理器中的一个真实漏洞,Opus 5 找到了根本原因并修复了社区补丁遗漏的一个边界情况。一个竞争模型只修复了表面症状(而非根本原因),然后报告漏洞已解决。
- 一家交易公司的工程师使用 Opus 5 在单次会话中构建了一个新交易所的市场数据 feed。之前的模型即使有工程师提供的详尽计划,也完全无法完成此任务。由于没有实时的 feed 可供验证,Opus 5 甚至自行构建了测试框架来检查其代码是否正确解析了交易所的数据。
以下是我们的早期访问客户关于使用 Opus 5 体验的更多报告:

在 FrontierCode 1.1 上,Claude Opus 5 以一半的成本达到了接近 Fable 级别的性能。在 Devin 中,它在困难的调试和根本原因分析任务上也表现出色。 Scott Wu CEO

Claude Opus 5 以 Opus 的速度和成本提供了接近 Fable 5 的智能。在 CursorBench 上,它略低于 Fable 5,但具有许多相同的行为。我们很期待看到开发者在 Cursor 中如何使用它。 Sualeh Asif Co-Founder

Claude Opus 5 在 Zapier 的 AutomationBench 排行榜上位居榜首,且消耗的 token 数量并未超过之前的 Claude 模型。它接收了一个原始的账户健康工作簿,并端到端地运行了完整的流失预防序列:标记高风险账户、提醒正确的负责人、并为留存运营团队生成摘要。之前的模型未能通过测试,而 Opus 5 达到了 100%。 Wade Foster CEO

在我们的基因组学分析工作中,Claude Opus 5 的行为比我们运行过的任何模型都更像一位严谨的科学家。它会选择正确的统计测试来排除混杂因素,通过独立方法交叉验证自己的结果,并在冗长的多步骤分析中保持专注。 Alfredo Andere CEO

Claude Opus 5 在我们内部评估中超越了同系列的所有模型。它不仅在我们最困难的智能体编码任务上表现更佳(比 Opus 4.7 提升 22%),而且更稳定,每次运行之间的方差大大降低。对于 Lovable 上的数百万构建者而言,这种一致性就是决胜关键。可靠的成果,构建再构建。 Fabian Hedin Co-Founder

Claude Opus 5 是 Opus 系列自 4.5 以来最大的飞跃。在相同的全栈应用构建中,前端首先体现了这一点:这是我们见过的 Opus 模型中最好的动画、游戏和 3D 作品。 Madhav Jha Co-Founder and CTO

我们非常喜欢 Claude Opus 5。对于我们的智能体所处理的开放式分析工作,它是对 Opus 4.8 的严格升级,而且改进最大的地方正是最关键的领域:更困难、更模糊的任务。响应更清晰、更简洁,在更高努力水平下效率也得到提升。 Izzy Miller AI Research Lead

对于我们的分析师每天运行的金融研究工作流程,Claude Opus 5 是对 Opus 4.8 的显著改进。它在数值推理、表格工作以及需要精确度的更敏锐的批判性思维方面表现突出。 Shirley Zhang Senior AI Engineer, Applied AI

Claude Opus 5 提供了分析专业企业内容所必需的行业智能和准确性。Box 发现 Opus 5 比 Opus 4.8 性能提升 8%,并且在数据分析(提升 11%)和尽职调查(提升 17%)工作流程中取得了显著进步,这些流程是技术、医疗和公共部门组织日常依赖的。 Ben Kus CTO

Claude Opus 5 是相对于 Opus 4.8 的明确代际提升。在一个周末,我让它承担了我开发环境中的参谋长角色:它构建了自己的监控器,驱动每个盒子,只在需要判断时才拉我进来。 Cristian Rivera Staff Software Engineer
Claude Opus 5 对我们的基础研究助手代码库进行了大规模变更,在智能体工作流程中根据反馈进行调整,并且比我们使用过的任何模型都更清晰地解释其推理过程。它处理了我们通常会分解成更小片段的工作。 Conor Kiernan CTO
在我们一些最难的金融建模任务中,Claude Opus 5 在准确性和效率上都明显优于 Opus 4.8。它的性能下限显著更高,尤其是在深度金融领域逻辑方面。在不同努力水平上,它的平均准确率提高了9个百分点,而轮次和工具调用减少了三分之一,时间减少了60%。Richard Pham,评估与产品负责人

Claude Opus 5 像真正的前端开发者一样检查自己的工作。在我们的基准测试中,它会在浏览器中以桌面和手机宽度打开页面,发现了隐藏在移动设备折叠区下方的产品和一个屏幕外的结账按钮,并在返回工作之前修复了这两个问题。AJ Orbach,联合创始人兼CEO

与之前的 Opus 模型相比,Claude Opus 5 在法律代理工作中的性能明显提升,我们在公司治理和仲裁等实践领域看到了最大的收益。我们还对 Opus 5 在较低推理级别上保持质量的能力印象深刻,在最大推理水平下,与 Opus 4.8 相比,平均生成的 token 减少了 26%,同时实现了相似性能。Niko Grupen,应用研究主管

对我们来说,Claude Opus 5 最大的进步在于长期工作:构建完整演示文稿,然后进行修订。工件质量决定了我们最终选择哪个模型,这是我们见过的最明显的提升——更好的视觉理解,更清晰的格式,更少的幻灯片问题。Alex Wang,应用AI

Claude Opus 5 的判断力非常突出。在交接 PR 时,它不会急于发布:它会验证分支、检查模板,并思考测试影响,以确保交接干净利落。旧模型往往急于推进,并在我们的检查中被发现问题。Zimu Li,技术员工

在一次重构会议中,Claude Opus 5 对我提出的设计提出了反对意见,当我坚持时它没有屈服。相反,它准确解释了我的想法中有价值的部分,将反对意见缩小到一个设计问题,并提出了一个折衷方案,保留了好的部分同时修复了缺陷。正是这种判断力让我们可以在较少监督下信任它。Marquis Wang,首席AI工程师

在首次修改红线条款方面,Claude Opus 5 在我们测试的所有模型中得分最高,几乎是 Opus 4.8 的两倍。评论功能也更好:在保密协议上,它用更少的时间和更少的轮次达到红线,准确性维持或更高。Ryan Tanenholz,技术员工

Claude Opus 5 编写干净、紧凑的 diff,没有死代码,并且对于代码库特有的细微问题,它是更强的危险发现者。我们正在将其用于生产工作负载。Neeraj Deshmukh,工程总监

我们肯定会在统一代理平台 Cosmos 中迁移大量用例。我们期待越来越多地使用 Claude Opus 5 进行代码审查,我很有信心地说,我们更希望人们使用 Opus 5 而不是 Opus 4.8。Igor Ostrovsky,联合创始人兼CTO
Claude Opus 5 的突出之处在于判断力。它在写一行代码之前更深入地思考,在规划阶段而非事后发现自身的逻辑错误,并推理答案为什么是正确的,而不仅仅是它是否有效。这是我们见过从一个 Claude 模型到下一个模型在问题解决方面最清晰的飞跃,我们期待它在 JetBrains IDE 中被采用。Denis Shiryaev,IDE AI 负责人

Claude Opus 5 是我们交易基准测试中测试过的最强的 Opus 模型,它使用了大约七分之一的推理 token 和不到 Opus 4.8 一半的延迟达到了这个水平。用更少的计算资源获得更好的答案。Matt Nassr,全球数据工程与AI转型主管01 / 22
对齐与安全
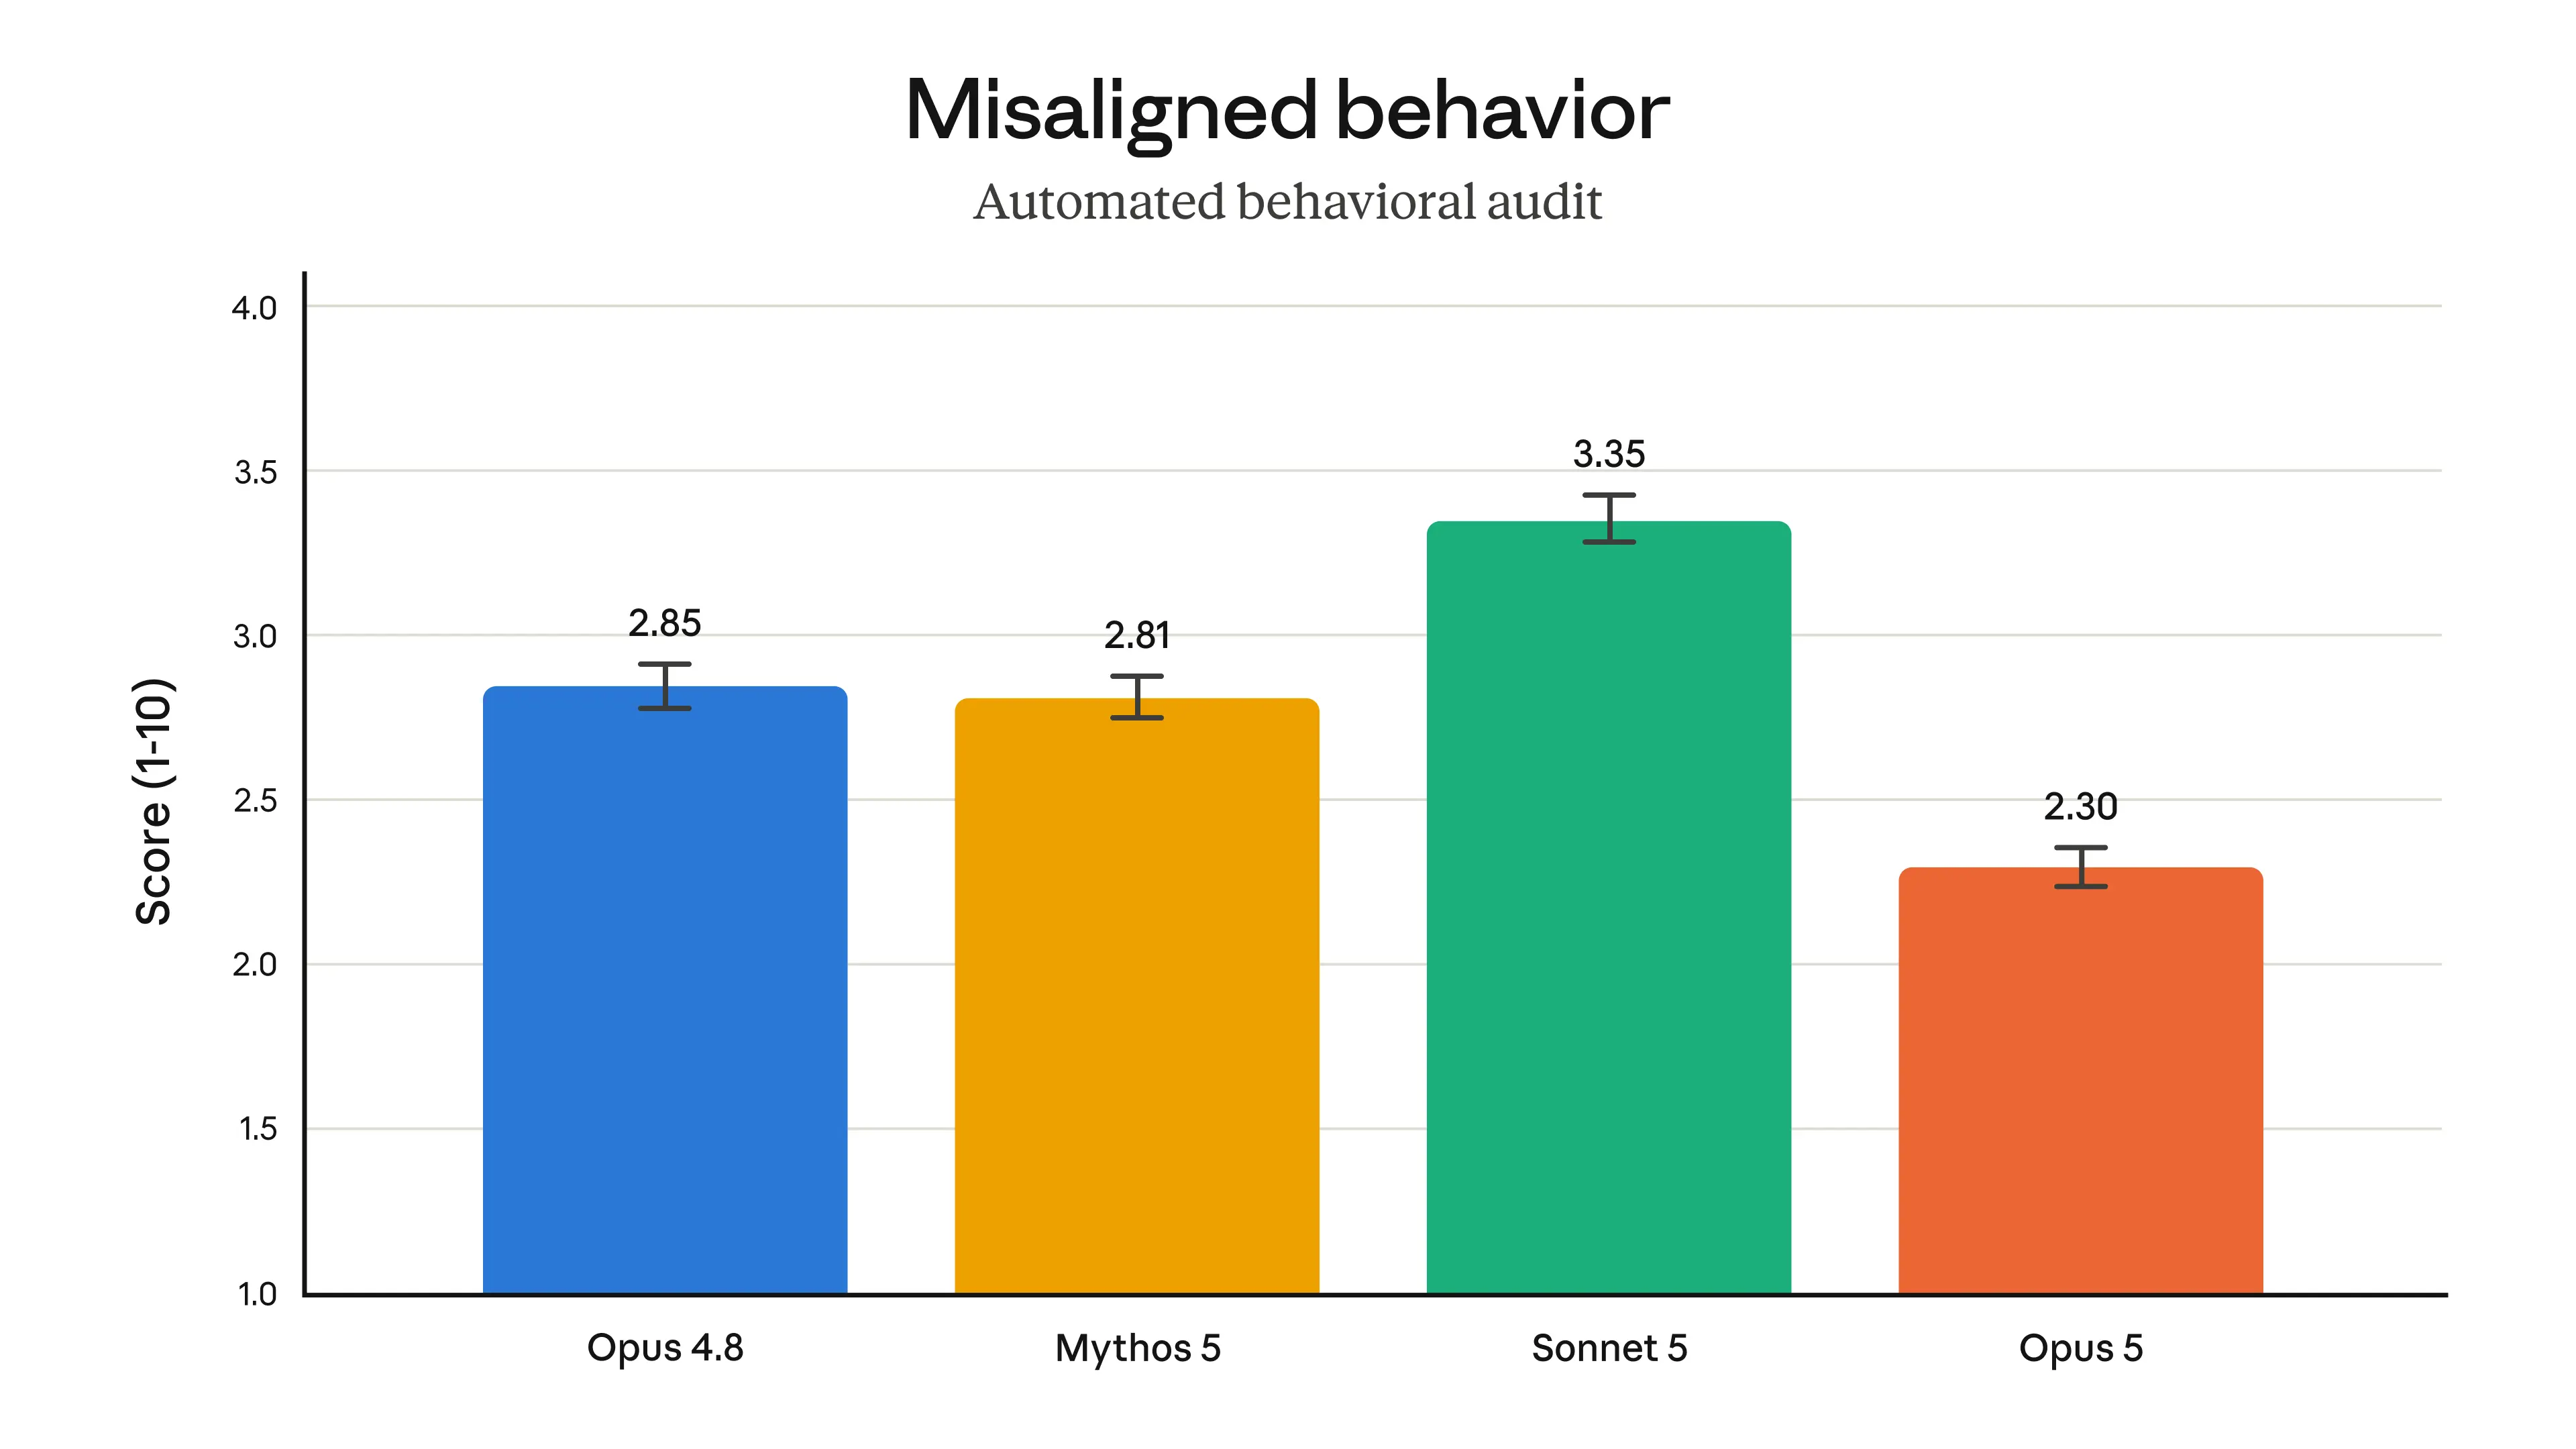
对齐。在部署前的测试中,我们的自动化行为审核发现Opus 5是我们迄今为止最对齐的模型(如下图所示)。它比Opus 4.8、Sonnet 5或Fable 5更遵守Claude’s Constitution;表现出最低的欺骗行为率;且最不容易被诱导滥用。在避免可能导致难以逆转副作用的鲁莽行为方面,它也是我们迄今为止最安全的模型。
安全性。Opus 5在危险的双重用途能力方面并未推进前沿。在与私营部门和政府合作伙伴共同进行的严格评估中,我们发现它在生物学研究和进攻性网络安全方面仍然落后于Mythos 5。有关这些评估的更多信息,请参阅我们的System Card。
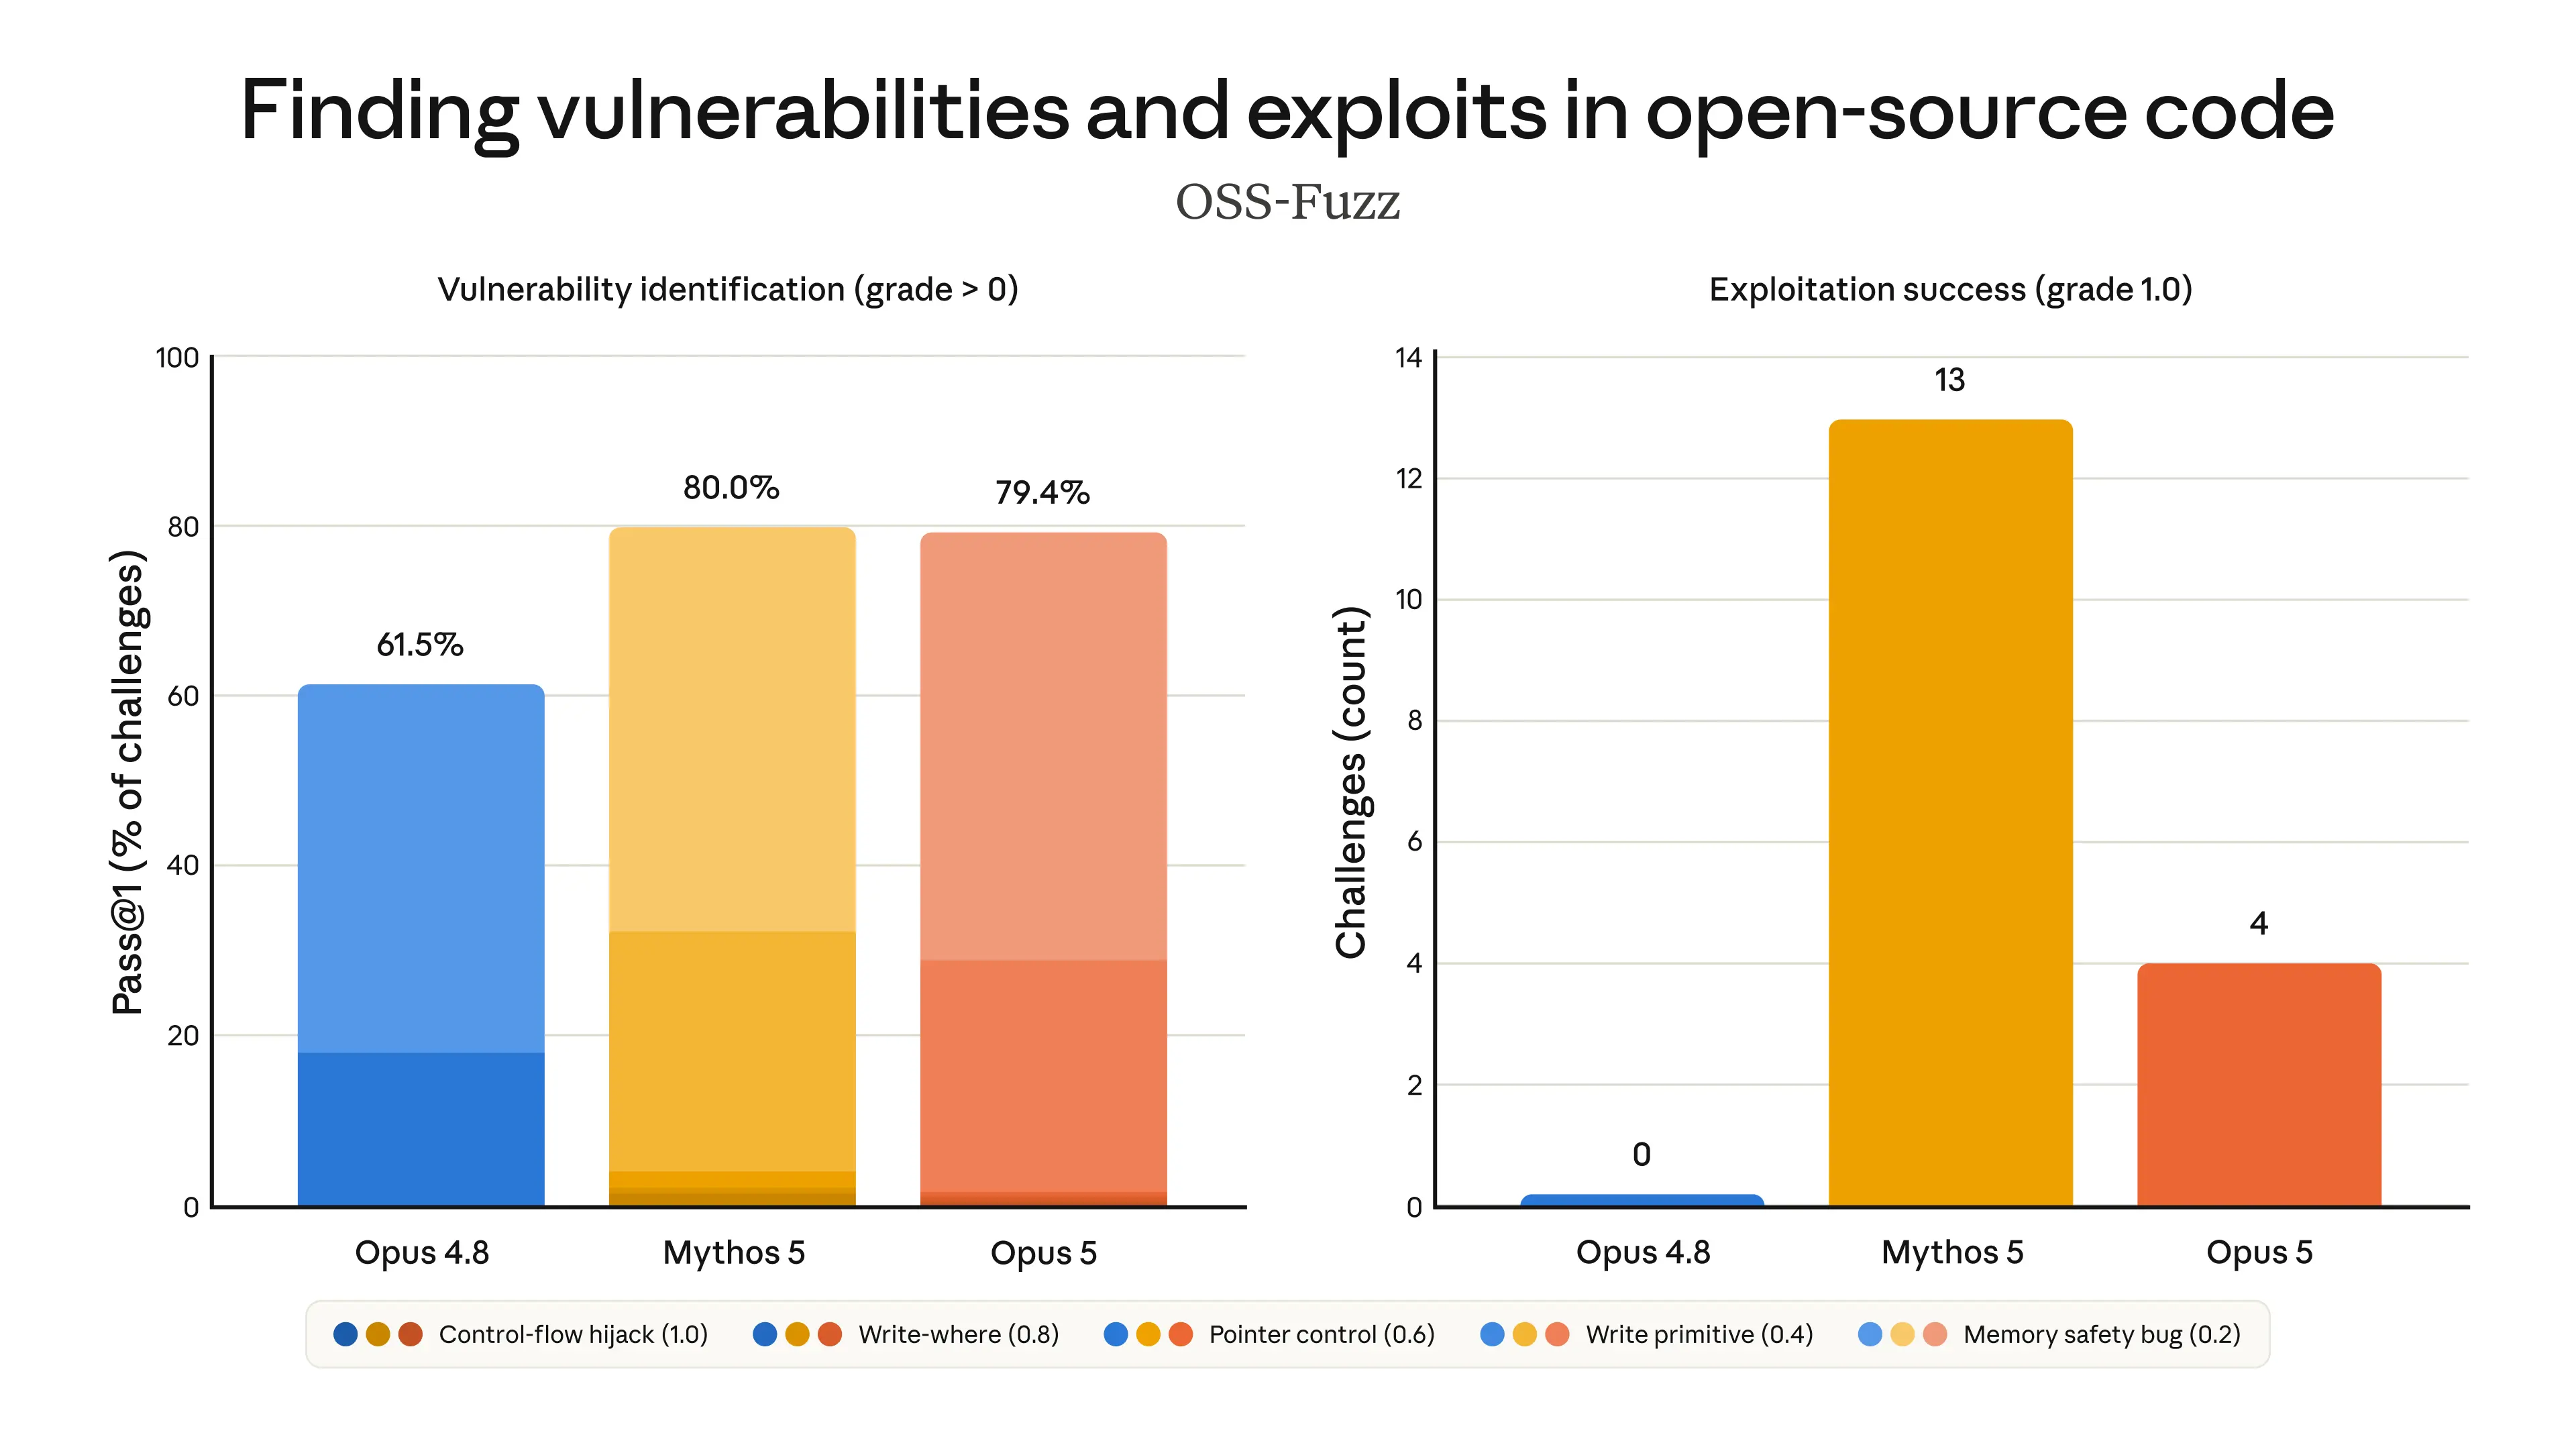
与其前身Opus 4.8一样,我们有意识地避免对Opus 5进行网络任务训练。然而,由于模型变得更具通用能力,它在这些任务上仍有显著提升,并且在发现网络安全漏洞方面接近Mythos 5。然而,它在利用 这些漏洞方面——即,将漏洞转化为实质性网络威胁——仍然大大落后于Mythos 5。
Opus 5在OSS-Fuzz上的表现说明了这一点,OSS-Fuzz是我们开发的一种评估,用于评估模型在没有大量人工指导的情况下发现并利用漏洞的能力。虽然Mythos 5和Opus 5在识别漏洞方面成功率相似,但Opus 5在利用开发方面的得分远低于Mythos 5。
Opus 5的防护措施
Claude Opus 5的防护措施旨在允许模型在网络安全和生物学领域的有益用途。它们与我们应用于Opus 4.8的防护措施类似,但在一小部分网络任务上增加了更强的护栏。
网络安全。Opus 5的网络分类器在比例上比Fable 5上的分类器限制更少。它们允许Opus 5在源代码中发现漏洞,但阻止“binary-based”漏洞扫描(一种更可能与恶意行为者相关的方法)、渗透测试和漏洞利用生成。
基于我们的测试,我们预计分类器的干预次数将比Fable 5少约85%。在Claude.ai、Claude Code和Claude Cowork中,任何被标记的请求将默认回退到Opus 4.8。也可以在API上启用回退到Opus 4.8。
我们的Cyber Verification Program(CVP)促进了原本可能因模型防护措施而受阻的网络安全工作。已经加入CVP的企业和研究人员可以立即访问一个安全限制较少的Opus 5版本。
生物学。由于Opus 5具有与Opus 4.8类似的防护措施套装,它现在是我们最强大的通用科学研究模型。尽管如此,该模型在长时间运行的自主研究任务上仍显示出重要局限性,而这正是我们预计AI模型会带来最严重生物学相关风险的领域。(Mythos 5仍然是这类生物学工作中更强大的模型。)作为此次发布的一部分,在Fable 5上被阻止的生物学相关请求现在将路由到Opus 5,而非Opus 4.8。
开始使用
Claude Opus 5现已面向所有平台推出,价格为每百万输入tokens 5美元,每百万输出tokens 25美元(与Opus 4.8相同)。开发者可以在Claude API上通过claude-opus-5开始使用。
它还提供快速模式,运行速度约为默认速度的2.5倍。与 Opus 4.8 一样,快速模式在 Claude Platform 上以 Opus 5 基础价格的两倍提供,也可通过 Claude Code 的使用额度获取。
在 Opus 5 发布的同时,我们推出了两项测试版更新:
- 对话中途更改工具(在 Claude Platform 上)。 在对话过程中,开发者现在可以更改 Claude 可以使用的工具,而不会使提示缓存失效。
- 自动回退(在 API 上)。 用户现在可以选择将由我们安全分类器在 Opus 5(或 Fable 5)上标记的请求自动路由到另一个模型。开启自动回退后,API 请求默认始终路由到可用的最佳模型,而不是被阻止。
与此前的 Opus 模型一致,Opus 5 在通用访问方面没有数据保留要求。
有关如何更好地使用 Opus 5 的更多指导,请参阅我们的 提示指南。
脚注
Frontier-Bench v0.1 效果图:这些结果来自 Frontier-Bench v0.1 的内部运行,采用 mini-SWE-agent 框架和 GKE 后端,平均奖励为每项任务尝试5次。Opus 4.8 作为 Opus 5 和 Fable 5 在安全分类器拒绝时的回退模型。
相关内容
经济未来研究基金的研究议程
我们正在分享 Anthropic 经济未来研究基金的研究议程。
Read more向 Claude 询问 Anthropic 经济指数
我们推出了用于 Claude 的 Anthropic 经济指数连接器,任何人都可以探索关于人工智能与工作的真实数据。
Read moreAnthropic 再次向 Public First Action 捐赠 2000 万美元
Anthropic 再次向 Public First Action 额外捐赠 2000 万美元,使我们的总支持金额达到 4000 万美元。
Read more同一事件的其他报道
- T2Simon Willison 博客(Atom)Claude Sonnet 5 发布:性能接近 Opus 但价格暗涨05:23
相关条目
精选DeepSeek V4 在 OpenRouter 上的代币份额翻倍,智能体工作负载成主要驱动力
DeepSeek V4 的快速采用表明市场对高性能、低成本推理模型的强烈偏好,尤其是智能体场景将重塑 AI 部署格局。
91
精选启用两项设置使ARC-AGI-3基准测试分数提升三倍
这项发现太关键了!它表明模型的性能不仅取决于训练,还取决于推理时的配置。对于AI工程师和研究者来说,这是一个必须注意的优化方向。特别是那些在资源受限设备上部署模型的团队,可能会因此找到低成本提升能力的方法。
91
精选GPT-5.6:前沿智能与前沿效率的融合
这条消息值得关注,因为它标志着大模型竞争从单纯拼参数转向拼效率。对于AI开发者和企业决策者来说,GPT-5.6意味着可以用更少预算获得更高性能,尤其适合那些被推理成本挡在门外的长上下文或Agent场景。OpenAI这一步,可能重新定义‘前沿’的标准。
91
精选LFM2.5-Encoder:面向CPU快速长上下文推理的新模型
这篇博文让我眼前一亮,因为它直接解决了大模型在CPU上跑长上下文的痛点。对于没有高端GPU的团队或个人开发者,LFM2.5-Encoder系列提供了可立即使用的开源方案。尤其推荐给做RAG、文档搜索或代码分析的朋友——现在用普通服务器就能处理百万级token的文档了。
91
精选GPT-Red:OpenAI通过自我对弈实现AI红队自动化,提升模型鲁棒性
GPT-Red 是红队测试从人工到自动化的里程碑,特别适合安全工程师和对齐研究者关注。它直接降低了测试成本,但也引发了对“自动攻击”本身的伦理讨论——值得所有关注AI治理的人深入思考。
91
精选OpenAI推出GPT-5.5生物漏洞赏金计划
这个计划值得关注,因为它首次将AI漏洞赏金制度拓展到生物安全领域,不仅为安全社区提供了新的研究方向,也为AI风险治理提供了实际演练场。对模型安全研究者、生物安全专家以及关心AI双重用途的从业者尤其重要。
91
精选vLLM推出原生速度Transformers建模后端,大幅提升推理性能
这项更新对于AI工程团队非常关键:无需格式转换意味着能更快地迭代模型,而2-5倍的速度提升直接降低GPU成本。如果你正在做LLM在线服务或者批量推理,这几乎是必读的技术更新。
90
精选Google DeepMind 发布手语转文本模型 SL2T,助力聋人用户
这则消息的意义不仅在于技术突破,更在于AI开始真正关注边缘群体的需求。对开发者而言,SL2T的架构思路和技术路径值得深入研究;对无障碍倡导者来说,这是推动行业标准的重要案例。